
扩散模型的学习密码:数据结构与不平衡如何决定谁先被记忆?
The Interplay of Data Structure and Imbalance in the Learning Dynamics of Diffusion Models
本文通过高维解析框架研究了扩散模型在处理非均质、不平衡数据时的学习动力学。核心方法基于随机特征(Random Features)模型与高斯混合模型(GMM)的理论推导,揭示了数据结构(如类方差、质心几何)与采样不平衡如何共同决定泛化与记忆的先后顺序,并在 Fashion MNIST 等真实数据集上验证了理论预测。
TL;DR
在生成式扩散模型的训练中,并非所有数据类别都是“平等”被学习的。最新研究《THE INTERPLAY OF DATA STRUCTURE AND IMBALANCE IN THE LEARNING DYNAMICS OF DIFFUSION MODELS》通过严谨的高维数学推导揭示:类方差(Class Variance)是决定模型学习顺序的第一变量(高方差类先学),质心几何次之,而采样不平衡则像一个调节旋钮,甚至能逆转这种顺序。这意味着,当你停止训练时,模型可能已经“背熟”了某些类,而对另一些类却还一知半解。
1. 现状痛点:消失的“公平性”时间窗口
在理想的扩散模型分析中,研究者通常假设所有类别的结构属性是一致的,模型会经历从“泛化”(Generalization)到“记忆”(Memorization)的平滑过渡。
然而,真实世界的数据充满了偏态。某些类(如人脸数据集中的少数族裔)不仅样本少,其内在方差和几何特征也与多数类完全不同。如果模型对这各类的学习进度不同,那么**Early Stopping(早停法)**作为一种隐式正则化手段就会失效:为了照顾少数类而继续训练,会导致多数类被过度记忆(Overfitting);反之则会导致少数类生成质量极差。
2. 核心机制:高斯等效解析框
作者采用了一个随机特征(Random Features, RF)模型来拟合**高斯混合模型(GMM)**生成的得分函数(Score Function)。
2.1 阶层式的学习动力学
模型通过分析特征协方差矩阵的特征谱,识别出了三个关键的时间点:
- :泛化的开始。
- :泛化的结束和记忆的开始。
- :记忆/过拟合的最终完成。
 图注:特征谱的分布(左)与训练/测试误差动力学(右)的对应关系,揭示了不同阶段如何由谱边缘决定。
3. 核心发现:谁主沉浮?
3.1 类方差:学习的“油门”
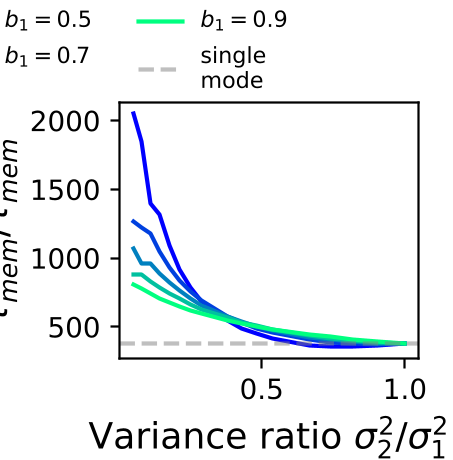
研究发现,类方差是主导因素。高方差的类别在得分匹配任务中表现出更平滑、更大的得分目标,因此模型能显著更快地完成对这些类的泛化和记忆。
3.2 采样不平衡:权力的逆转
采样比例(Mixing Proportion)扮演了调节者的角色。
- 弱不平衡下,全局 Speciation Time 保持不变。
- 强不平衡(少数类样本呈幂律稀缺时)会打破对称性,强制少数类的特征在更晚的扩散时间里才浮现。
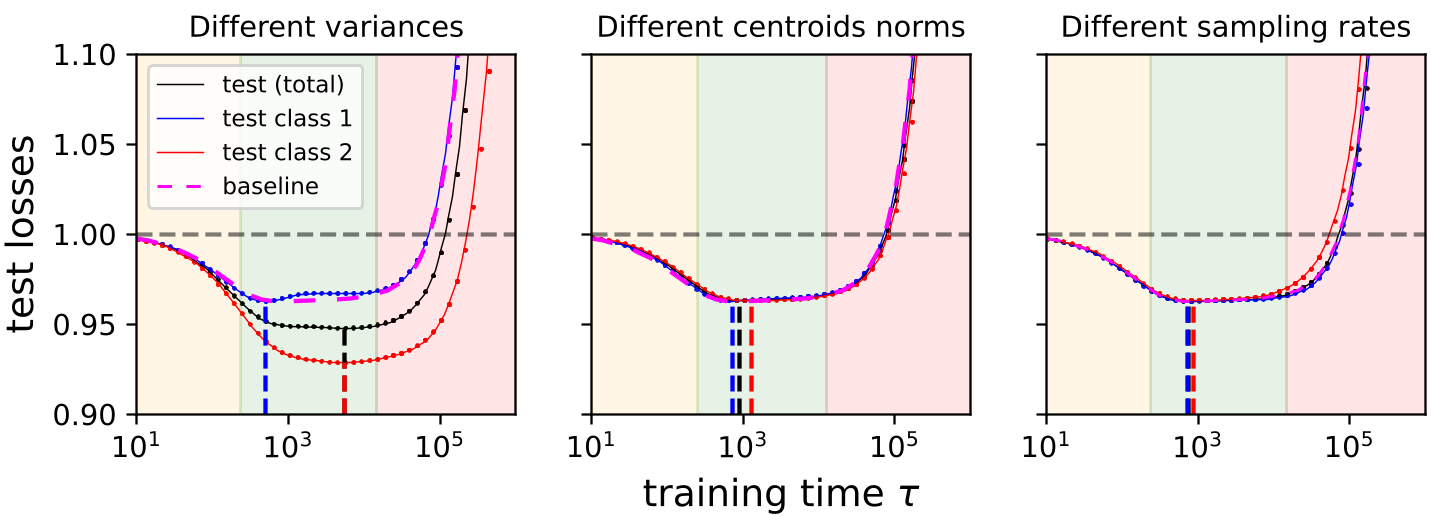 图注:改变方差、质心范数和采样权重对各类别测试误差的影响,展示了学习时间的明显分位。
4. 实验验证:从理论到 Fashion MNIST
为了验证理论的普适性,作者在现实数据集 Fashion MNIST 上使用 U-Net 扩散模型(DDPM)进行了实验。他们选择了“Sneaker”(运动鞋)作为参考类(其像素点方差最小),并观察它与其他类(如 Bag, Coat)搭配训练时的记忆间隔。
结果显示:
- 拥有最高方差的类总是先达到记忆阈值。
- 记忆间隔 与各类别的实证平均方差呈正相关。
- 增加少数类的采样权重,能有效缩小这种“记忆落差”。
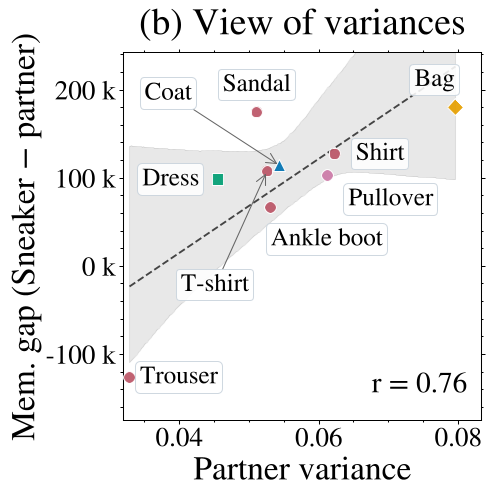 图注:DDPM 在实测数据上的记忆间隔变化趋势,验证了理论模型中方差作为主导因素的预测。
5. 深度洞察:泛化-记忆的权衡 (Trade-off)
论文提出了一个核心的权衡:调整采样权重以关闭泛化差距,往往不可避免地会扩大记忆差距。
如果我们为了让模型早点学会少数类而增加其样本量,可能会导致这个类被更早地“死记硬背”住,从而丧失了生成的多样性。这为未来设计“公平且稳健”的生成模型提出了巨大的挑战。
总结
这项工作不仅为扩散模型的偏见问题提供了数学解释,还指明了方向:未来的训练策略不应只是单纯地增加数据,而应根据数据内在的方差结构和几何性质,动态地调整学习速率或采样策略,从而让所有类别都能在同一个时间窗口里达到“完美泛化”。
参考文献:Nicoletti et al., "THE INTERPLAY OF DATA STRUCTURE AND IMBALANCE IN THE LEARNING DYNAMICS OF DIFFUSION MODELS", arXiv, 2026.