
JUMPLORA:让低秩适配器变稀疏,彻底告别持续学习中的任务干扰
JumpLoRA: Sparse Adapters for Continual Learning in Large Language Models
本文提出了 JUMPLORA,一种利用 JumpReLU 门控机制在 LoRA 模块中实现自适应稀疏化的持续学习(CL)框架。通过动态诱导参数隔离,该方法在不依赖重放或强正则化的前提下,显著提升了 IncLoRA 的性能,并超越了当前的 SOTA 方法 ELLA。
TL;DR
在持续学习(Continual Learning)领域,如何在学习新知识的同时不遗忘旧知识,本质上是一个参数隔离与利用的平衡问题。Bitdefender 与布加勒斯特大学的研究团队提出了 JUMPLORA,通过引入可学习的 JumpReLU 门控机制,让 LoRA 适配器学会“自发”地变得稀疏。它不仅在标准基准上显著超越了 SOTA(如 ELLA),更重要的是,它实现了极其纯粹的参数隔离——任务间的参数重叠率极低。
痛点深挖:为什么低秩(LoRA)还不够?
尽管 LoRA 已成为高效调优的标配,但在持续学习场景下,简单的低秩更新存在先天不足:
- 密度干扰:现有的 LoRA 变体(如 ELLA, O-LoRA)多采用稠密更新。随着任务增多,所有低秩坐标都在不断被改写,模型容纳新知识的能力会迅速饱和。
- 刚性约束:正交性约束(Subspace partitioning)往往过于死板,无法根据任务的真实复杂度动态分配参数。
- 灾难性遗忘:当新旧任务的梯度在同一参数坐标上频繁冲突时,遗忘不可避免。
核心机制:JumpReLU 驱动的自适应稀疏化
JUMPLORA 的灵感源自神经科学中的“稳定性-可塑性”权衡。它不再强求所有 LoRA 参数参与计算,而是通过一个可学习的阈值 来过滤掉不重要的更新。
1. 连续化的 JumpReLU
JumpReLU 的数学表达式为 ,其中 是阶跃函数。在反向传播中,作者使用了直通估计器(Straight-Through Estimator, STE)来让这个不可微的阈值变得可优化。
2. 动态插值调度(-scheduling)
这是 JUMPLORA 成功的关键。如果一开始就稀疏,LoRA 可能根本学不动。作者设计了一个调度器:
- 初期(Dense):允许全量更新,让模型摸索哪些参数重要。
- 中期(Interpolated):在密集更新()和稀疏更新()之间进行凸插值。
- 后期(Sparse):完全切换到稀疏模式,只精炼那些真正关键的正负量级参数。
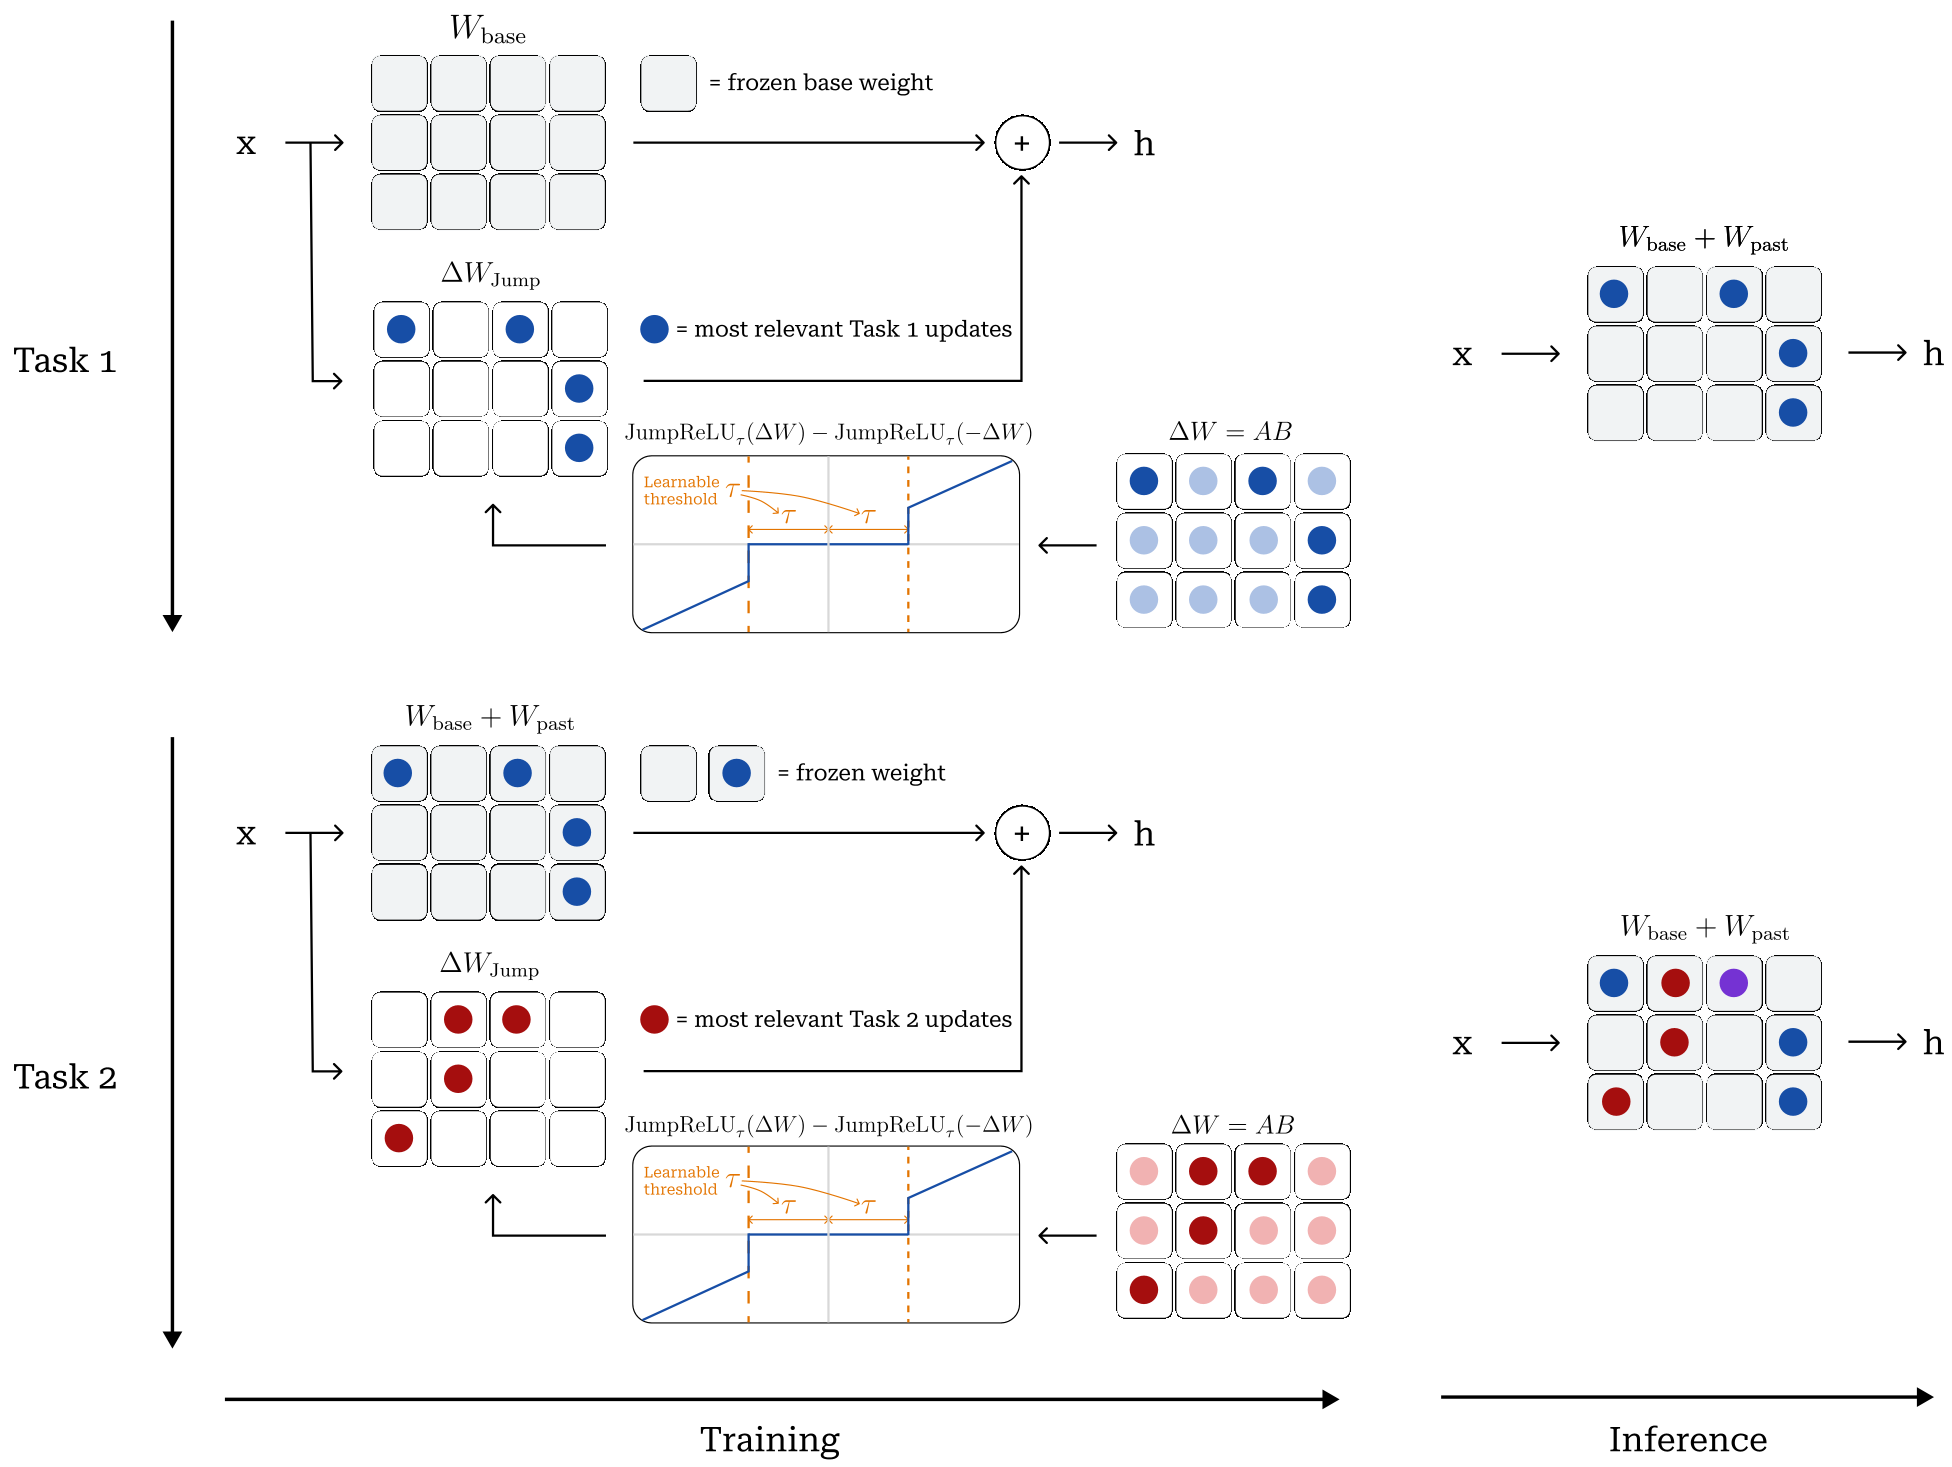 图 1:JUMPLORA 持续学习流程。针对每个任务训练一个可学习阈值,识别并保留最高干预价值的权重更新。
实验战绩:全线破纪录
研究人员在 T5 (770M) 模型上进行了广泛测试,涵盖了短序列(SC)和长序列(LS)基准。
- 性能爆炸:在没有复杂正则化的情况下,JUMPLORA + IncLoRA 将准确率从 62.6% 提升至 71.6%(SC 基准)。
- 结合最强补丁:当 JUMPLORA 作用于 SOTA 方法 ELLA 之上时,在 15 个任务的长序列测试中进一步提升了表现,达到了 72.72% 的 OA。
- 极低重叠:通过 Jaccard 相似度分析发现,JUMPLORA 诱导出的任务间参数重叠极小(仅 1.2% - 6.5%),这意味着不同任务几乎是在各自“独立”的参数空间内运作。
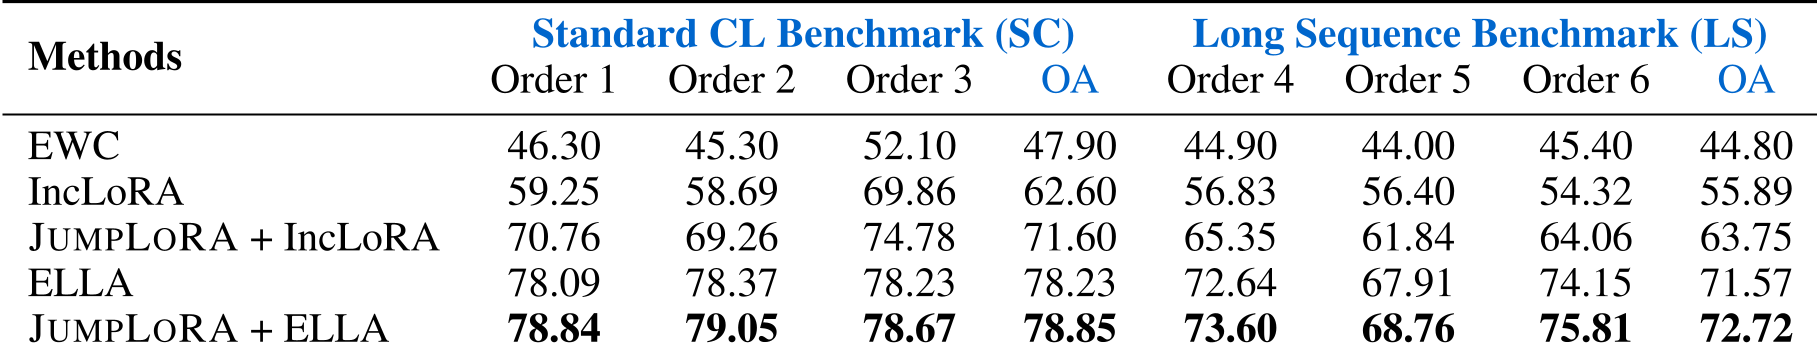 表 1:在标准(SC)与长序列(LS)基准上的 OA 对比。JUMPLORA 在所有阶次下均表现优异。
深度洞察:为什么这种稀疏性有效?
从物理直觉上看,JUMPLORA 扮演了一个“过滤器”的角色。它利用梯度量级作为参数重要性的代理指标,强制模型只在对当前任务贡献最大的坐标上进行细粒度干预。
有趣的是,消融实验显示,**“全局阈值”和“局部阈值(每层一个)”**各有千秋。在任务较短时,局部阈值由于灵活性更好表现更佳;而在极长任务序列中,全局阈值表现出了更强的鲁棒性。
局限性与展望
尽管 JUMPLORA 表现强劲,但由于引入了直通估计器(STE)和额外的调度逻辑,训练过程中的超参数(如 )可能需要一定的调优。
未来的研究方向将集中在:
- 跨模态应用:将此稀疏机制引入 Vision Transformer (ViT) 的持续学习中。
- 极度压缩:利用这种天然产生的稀疏性,在合并模型时进一步压缩 adapter 的存储成本。
总结
JUMPLORA 证明了,在 LLM 的持续学习中,我们不一定需要复杂的正交投影或海量的显存,有时候,一个简单、可学习的“跳跃阈值”就能通过诱导参数解耦,完美平衡学习新知与保留旧识。