
KernelBench-X:撕开 LLM 生成 GPU 内核的“正确性假象”
KernelBench-X: A Comprehensive Benchmark for Evaluating LLM-Generated GPU Kernels
本文推出了 KernelBench-X,一个专门面向 LLM 生成 GPU 内核(Triton)能力的深度基准测试集。该测试集涵盖 15 个类别、176 个任务,重点从语义正确性和硬件效率(IOU/MFU)两个维度刻画了当前大模型在高性能计算代码生成领域的真实边界。
TL;DR
在 AI 基础设施日益依赖定制化算子的今天,用 LLM 自动写 Triton 或 CUDA 内核成了大热门。然而,KernelBench-X 告诉我们一个残酷的现实:目前的 LLM 内核专家(如 GEAK, AutoTriton)虽然能写出“编译通过”的代码,但在涉及复杂算子融合、量化逻辑和硬件效率时表现惨淡。最扎心的发现是:AI 越改,代码执行得越慢。
1. 痛点:为何 GPU 内核生成是 LLM 的“深水区”?
通用的代码 Benchmark 只需要模型逻辑清晰,但 GPU 内核生成是一个多维约束任务:
- 语法约束:Triton/CUDA 的特定 DSL 语法。
- 语义约束:并行计算中的线程分配、掩码(Mask)处理、显存对齐。
- 硬件极限:代码不仅要对,还要快,否则不如直接用现成的深度学习框架。
现有研究往往陷入了“刷榜”的误区,而忽略了任务结构对性能的本质抑制。
2. KernelBench-X:多维度的深度解构
为了看清 LLM 的能力边界,KernelBench-X 构建了包含 176 个任务的矩阵,并将其归纳为 15 个细分任务类别。

该基准测试最核心的设计在于:
- 分类感知(Category-Aware):将任务分为直接定义的 Math 类和涉及全局协调的 Fusion, Quantization 类。
- 两阶段验证:不仅要输出对比一致,还要在异常值(Outlier)分布下测试稳定性,防止 LLM 通过“硬编码占位符”作弊。
- 硬件效率监控:引入 IOU(显存利用率)和 MFU(计算利用率),直接给代码效率“打分”。
3. 核心发现:任务结构决定生死
论文通过对五个代表性方法(包括专门微调的 AutoTriton 和 Agent 架构的 GEAK)的测试,得出了三个颠覆性的洞察:
洞察一:类别效应远胜方法效应
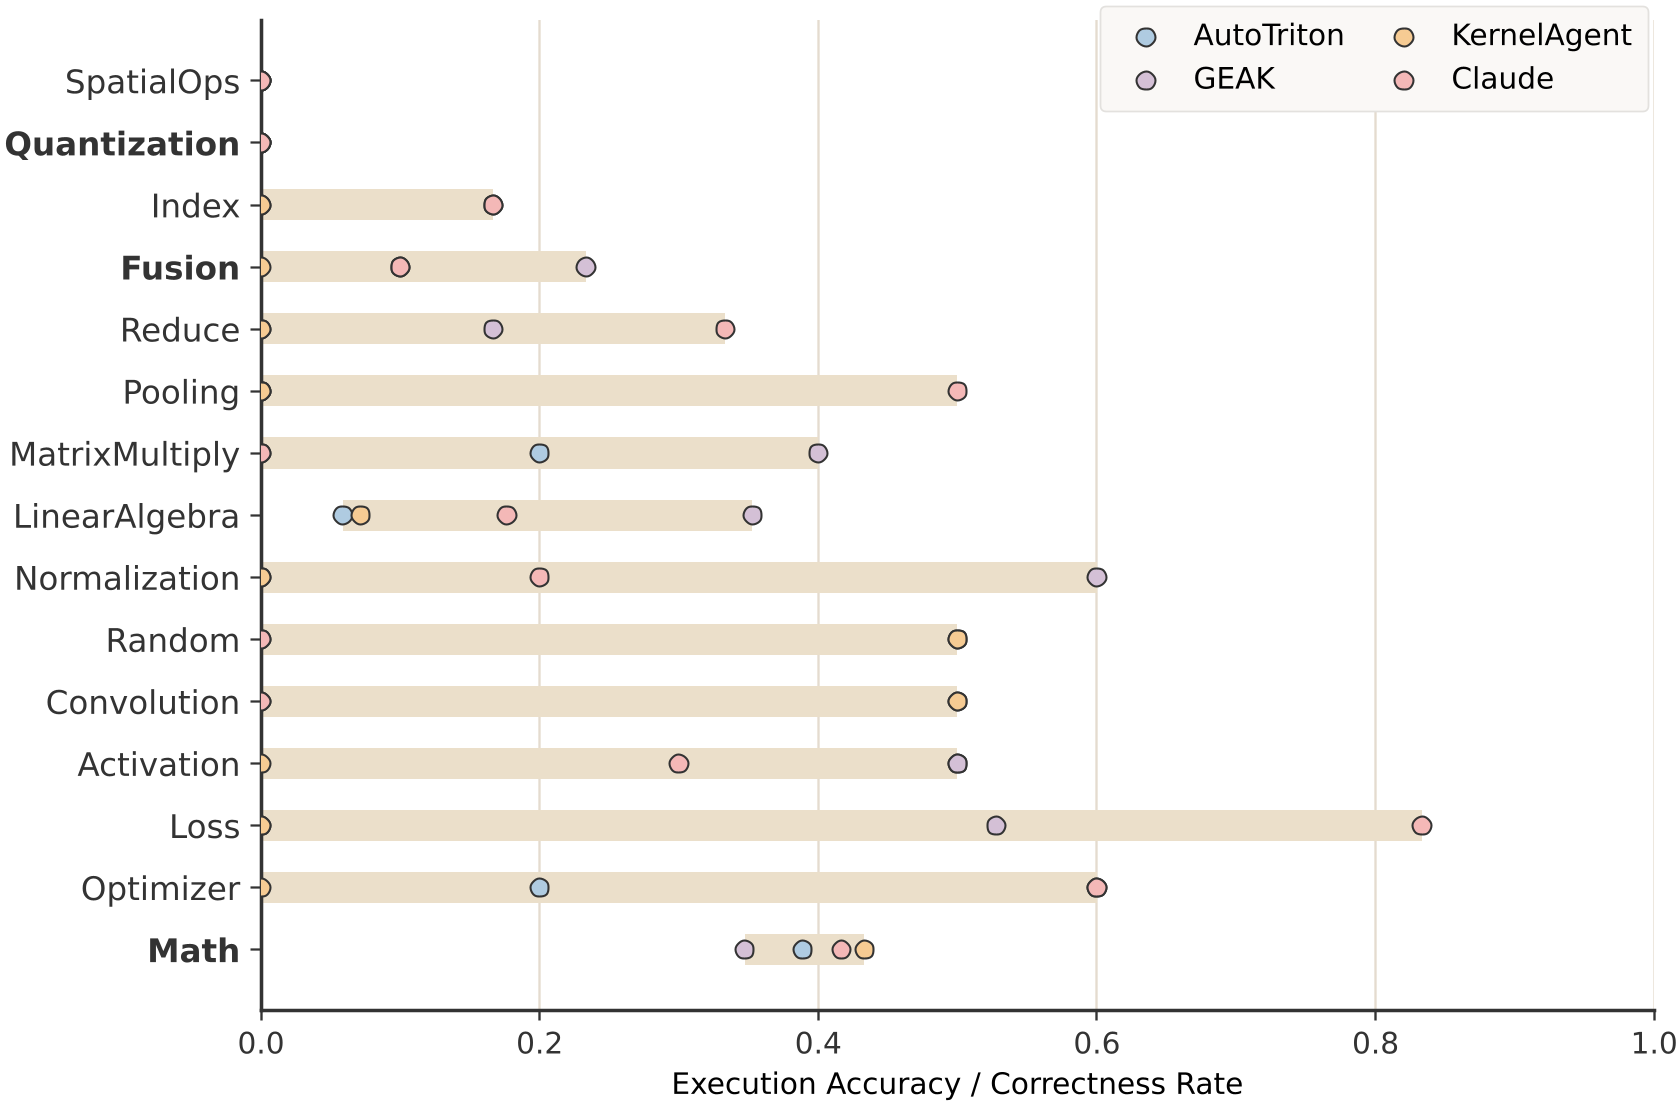
实验表明,一个内核能否生成正确,9.4% 取决于它属于哪一类任务,而只有 3.3% 取决于你用了哪个模型。例如,简单的 Math 任务模型几乎全对,但 72% 的 Fusion (融合算子) 任务在所有模型上都折戟沉沙。
洞察二:迭代修复的“副作用”
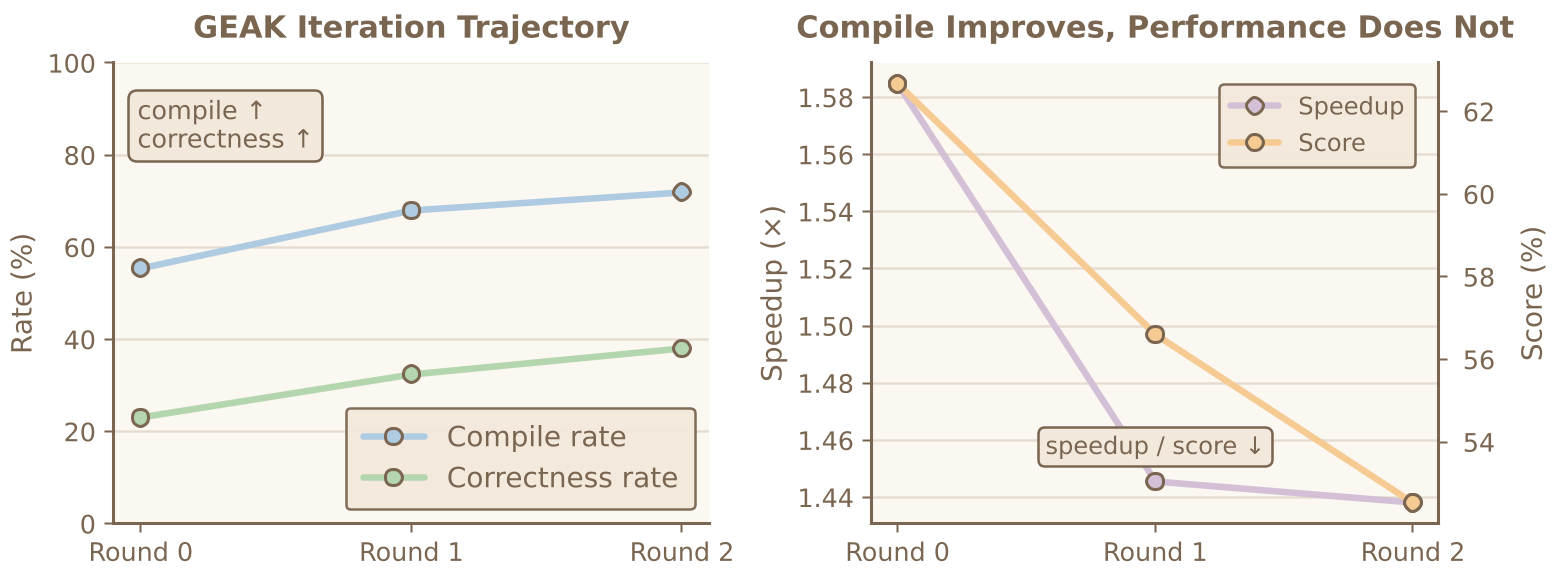
目前最先进的 Agent 框架(如 GEAK)通常通过“报错-修改”的循环来提升表现。但 KernelBench-X 发现:迭代能修正性能,但会稀释性能。 随着迭代轮数增加,编译通过率确实上去了,但平均加速比却在下滑。这是因为 LLM 在修复 Bug 时,往往倾向于使用防御性的、低效的 fallback 逻辑,而不是通过重构 Tile 大小或优化内存访问来解决问题。
洞察三:量化(Quantization)是无人区
在 W8A8 或 W4A16 这种需要手动管理数值精度和缩放系数的任务中,LLM 的正确率为 0%。尽管代码可以编译,但模型完全无法理解数值计算的精度契约(Numerical Contracts),导致计算结果彻底崩坏。
4. 深度案例:全局语义的崩塌
在 fused_exp_mean 任务中(案例 4.6.2),模型生成的代码分别看每一行都是对的,但组合在一起就坏了:它在处理 Padding 时给掩码位置填充了 0,导致经过 运算后变成了 1 并参与了 Global Reduction。这种非局部性(Non-local)的逻辑错误是当前大语言模型的致命伤。
5. 局限性与未来展望
KernelBench-X 指出,LLM 目前更像是一个“优秀的打字员”而非“资深的内核工程师”。
- 局限性:LLM 缺乏硬件代价模型(Cost Model),无法感知 Register Spilling 或 Coalescing。
- 未来方向:我们需要将**反馈信号(Profiling Signals)**直接喂入 LLM 的优化循环,并结合硬件感知搜索,而非仅仅告诉它“代码运行有误”。
结论
KernelBench-X 不仅仅是一个排行榜,它揭示了高性能算子生成的三个关卡:编译关、语义关、效率关。目前 LLM 刚过第一关,正在第二关苦苦挣扎,而第三关——实现真正的硬件加速——依然是一片未竟之地。
本文由资深学术技术主编基于 KernelBench-X 论文深度解析。