
[CVPR 2026 预研] KaCGM:当因果生成模型遇见 KAN,开启符号级可解释性新时代
Kolmogorov-Arnold causal generative models
本文提出了 KaCGM,一种基于 Kolmogorov-Arnold Network (KAN) 的因果生成模型,用于处理混合类型表格数据。该模型能在保持结构因果模型 (SCM) 语义的同时,通过 KAN 的函数分解特性提供高度可解释的显式结构方程,在合成和真实的心血管数据集上均达到了与 SOTA 方法相当的生成性能。
TL;DR
传统的深度因果模型往往是“黑盒”,虽能刷榜但不可审计。本文提出的 KaCGM (Kolmogorov-Arnold Causal Generative Model) 创造性地将最近火爆的 KAN (Kolmogorov-Arnold Network) 引入因果推理领域。它不仅能像常规生成模型那样处理观察、干预和反事实查询,最硬核的突破在于:它能直接吐出显式的数学公式(如 ),让因果机制逻辑彻底透明化。
背景定位:因果推理的“透明度”困境
在医疗决策或政策制定中,我们不仅想知道“如果我给药,病人会怎样”(干预查询),更想知道“为什么模型认为这个药有效”。现有的 Causal Flows 等方法虽然强大,但其内部是成千上万个神经元权重,人类无法理解其中的物理含义。KaCGM 弥补了这一鸿沟,它在学术坐标系中属于可解释深度因果模拟器的开创性工作。
核心直觉:为什么 KAN 是因果模型的完美搭档?
作者的研究直觉非常敏锐:因果机制本质上是结构方程的集合。
- 加性噪声模型 (ANM):假设 。如果 是黑盒,我们依然无法理解机制。
- KAN 的威力:根据 Kolmogorov-Arnold 定理,任何多元连续函数都能分解为一元函数的叠加。这与 神经加性模型 (NAM) 的思想不谋而合,但 KAN 使用 B-Splines 代替了 MLPs,这使得它对平滑函数的逼近更高效,且非常利于进行符号近似。
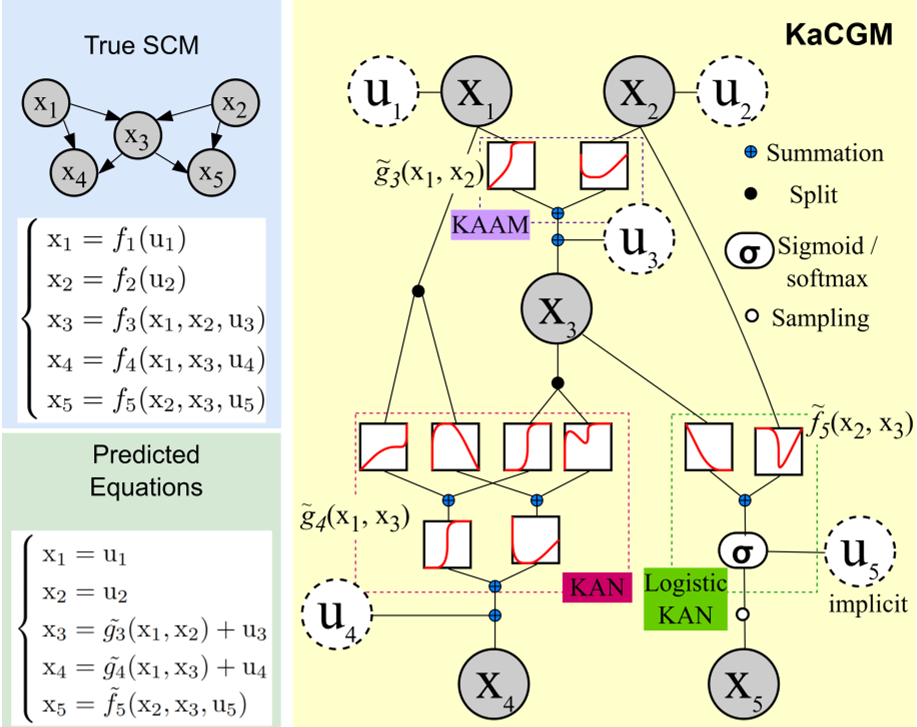 图 1:KaCGM 架构示意。每个节点的生成机制由一个 KAN 网络参数化,通过拟合残差获得外生噪声变量 。
技术亮点:从神经网络到闭式方程
KaCGM 的工作流程不仅仅是训练一个模型,而是一套解释流水线:
- 混合类型支持:通过 Logistic-KAN 扩展,模型可以完美处理离散变量。
- 剪枝与符号化:模型训练后,作者会对 KAN 的边进行剪枝(去除不重要的父节点影响),然后利用符号回归将 Spline 函数转化为多项式、三角函数等。
- 失配诊断:通过测试推断出的噪声 与父节点 的独立性(使用 HSIC 算法),模型能自豪地告诉你:“我的加性假设在这里是否成立”。
实验战绩:性能不减,透明度倍增
在 Sachs 蛋白质信号网络等标准基准上,KaCGM 展示了极强的竞争力。
- 加性场景下:KaCGM 的反事实预测误差 (MAECF) 与最先进的专用加性模型 (ANM) 持平,远优于通用的 Diffusion 基线。
- 混合类型优势:在包含离散变量的场景下,KaCGMmix 在观测分布和干预分布的拟合指标 (MMD, C2ST) 上显著胜过 CFlow 等模型。
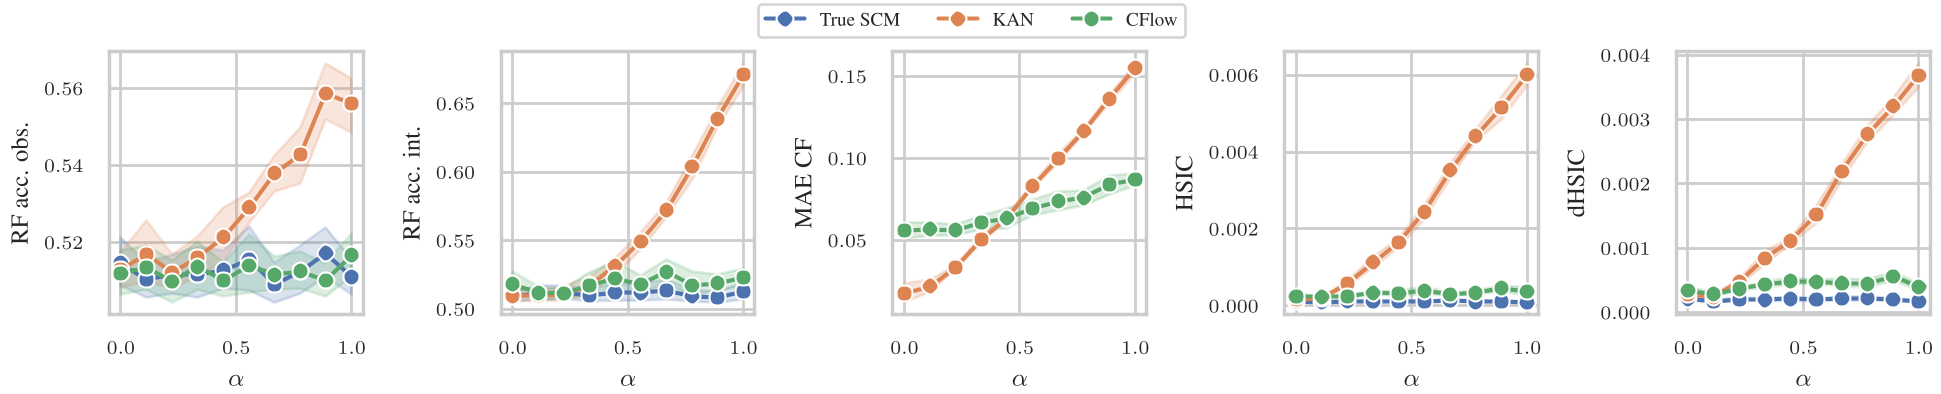 图 2:模型灵敏度分析。随着非加性系数 增加,KaCGM 的独立性测试 (HSIC) 评分显著下降,证明了其自诊断能力。
深度洞察:医疗案例中的“真相”
在心血管案例中,KaCGM 提取出的缺血风险方程显示:年龄(Age)和收缩压(Systolic)对风险的贡献具有明显的二次项特征。 这与临床医学中“风险随年龄呈非线性加速增长”的直觉完全契合。通过作者提供的 Probability Radar Plots (PRP),医生可以清晰地看到每个患者风险评分的来源。
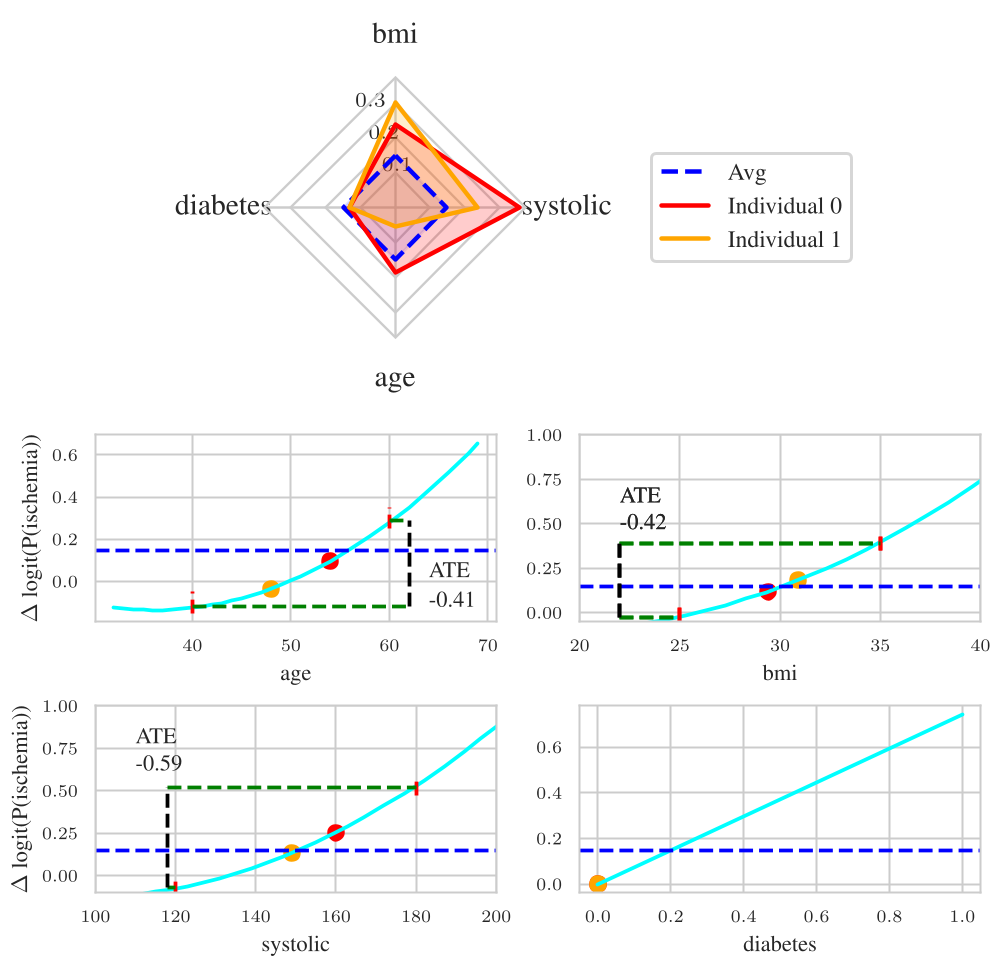 图 3:解释工具演示。上图为个体风险贡献的雷达图,下图为群体水平的偏相关图(PDP)。
总结与局限
Takeaway: KaCGM 是表格数据因果建模的一个重要里程碑,它解决了“既然有因果图,为什么还需要符号方程”的问题——图只告诉了你连通性,而 KaCGM 告诉了你传播的具体规律。
局限性分析:
- 强加性假设: 当数据生成过程(DGP)存在高度纠缠的非加性交互(如多变量乘积项)时,KaCGM 的拟合度会下降。
- 计算成本: KAN 的训练目前比简单 MLP 慢(见原文 Table III),在极高维特征下可能存在扩展性挑战。
- 图结构依赖: 它依赖于预先定义的因果图。如果图画错了,生成的公式再漂亮也是“误导性的真相”。
KaCGM 开辟了从“因果黑盒”到“符号白盒”的新路径,值得每一位关注 AI 透明度的研究者深入研读。