
Ctx2Skill:让大模型从复杂情境中自主“悟”出硬核技能
From Context to Skills: Can Language Models Learn from Context Skillfully?
本文提出了 Ctx2Skill,这是一个专为语言模型(LMs)设计的自进化框架,旨在从复杂语境(Context)中自主发现和提炼任务技能。通过多智能体自我博弈(Self-play)机制,该方法在不需要人工标注或外部反馈的情况下,显著提升了 GPT-4 和 GPT-5 等模型在长文本理解与推理任务(CL-bench)中的表现。
TL;DR
面对技术密集、长达数万词的文档,大模型往往“读了就忘”或者“读而不精”。清华大学与 UIUC 等机构的研究者提出了 Ctx2Skill 框架。它不依靠人类教师,也不靠运行反馈,而是让两个 AI 智能体通过“博弈对抗”和“失败复盘”,把长文档转化为一套逻辑严密的“技能书” (Natural-language Skills)。这一方法让 GPT-4 的情境推理能力直接跨越了一个分位点。
痛点深挖:长文本推理的“黑盒”困境
在现实场景中,我们经常要求 AI 阅读产品说明书、法律条文或科学数据并解决问题,这就是 情境学习 (Context Learning)。然而,这个领域存在两个长期悬而未决的难题:
- 标注之痛:长达 50 页的技术文档,让人类去总结其中的推理逻辑(技能)既费时又费力,难以规模化。
- 反馈缺失:不像写代码或做数学题,逻辑推理任务往往没有编译器或标准答案,AI 无法通过“试错”来学习。
现有模型在面对包含隐含逻辑的长文本时,往往只能进行浅层的语义检索,而无法形成深层的规则认知。
核心机制:Ctx2Skill 的自进化逻辑
Ctx2Skill 的核心思想是将模型权重的进化转化为“技能文档”的进化。其架构包含五个关键智能体角色:
1. 技能优化的自我博弈环路
- 挑战者 (Challenger):基于当前掌握的语境,挖掘文档中的难点,出题并制定严苛的“评分准则”(Rubrics)。
- 推理者 (Reasoner):拿着“技能书”,在长文档中寻找线索并作答。
- 裁判 (Judge):铁面无私,根据准则给出 Pass/Fail。
- 进化器 (Proposer & Generator):这是核心。如果推理者失败了,Proposer 会复盘“哪条技能没写对”或“漏掉了什么逻辑”,由 Generator 实时重写技能书。
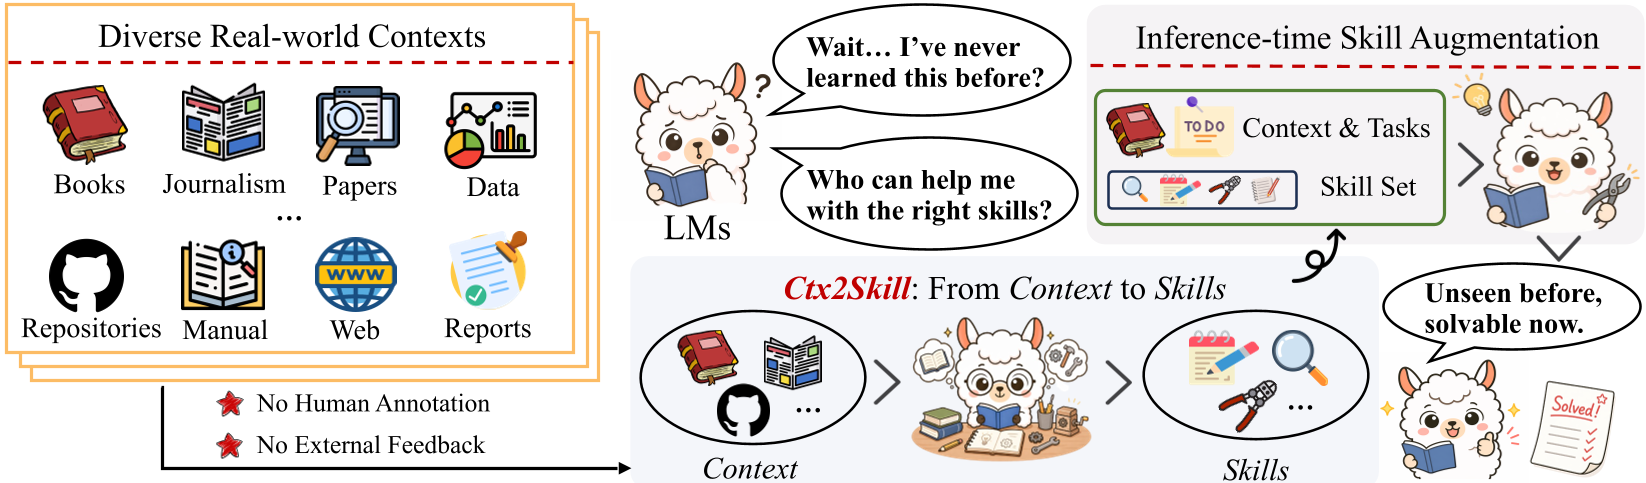 图1:Ctx2Skill 整体流程:从语境到技能的提取不需要人工介入。
2. 跨时回放 (Cross-time Replay):对抗“走火入魔”
在对抗学习中,挑战者为了赢,可能会出一些“钻牛角尖”的怪题,导致推理者的技能书变得过度特化,这就叫 对抗塌缩 (Adversarial Collapse)。 为了解决这个问题,研究者引入了“跨时回放”机制:它会在每一轮迭代中选择表现最稳健(既能解难题,又不退化简单题)的那一版技能书,而不是盲目追求最后一轮。
实验战果:技能加持下的“越级打怪”
研究团队在 CL-bench 这一极具挑战性的基准上进行了测试。结果显示:
- 全面超越基线:无论是在领域知识推理还是在程序性任务执行上,Ctx2Skill 均显著优于传统的 Prompting 方案。
- 性能跨代:搭载了 Ctx2Skill 技能书的 GPT-4.1 (16.5%) 竟然在表现上超越了未挂载技能的 Gemini 3 Pro (15.8%)。这意味着优化的思维工具(技能书)可以弥补模型底座能力的不足。
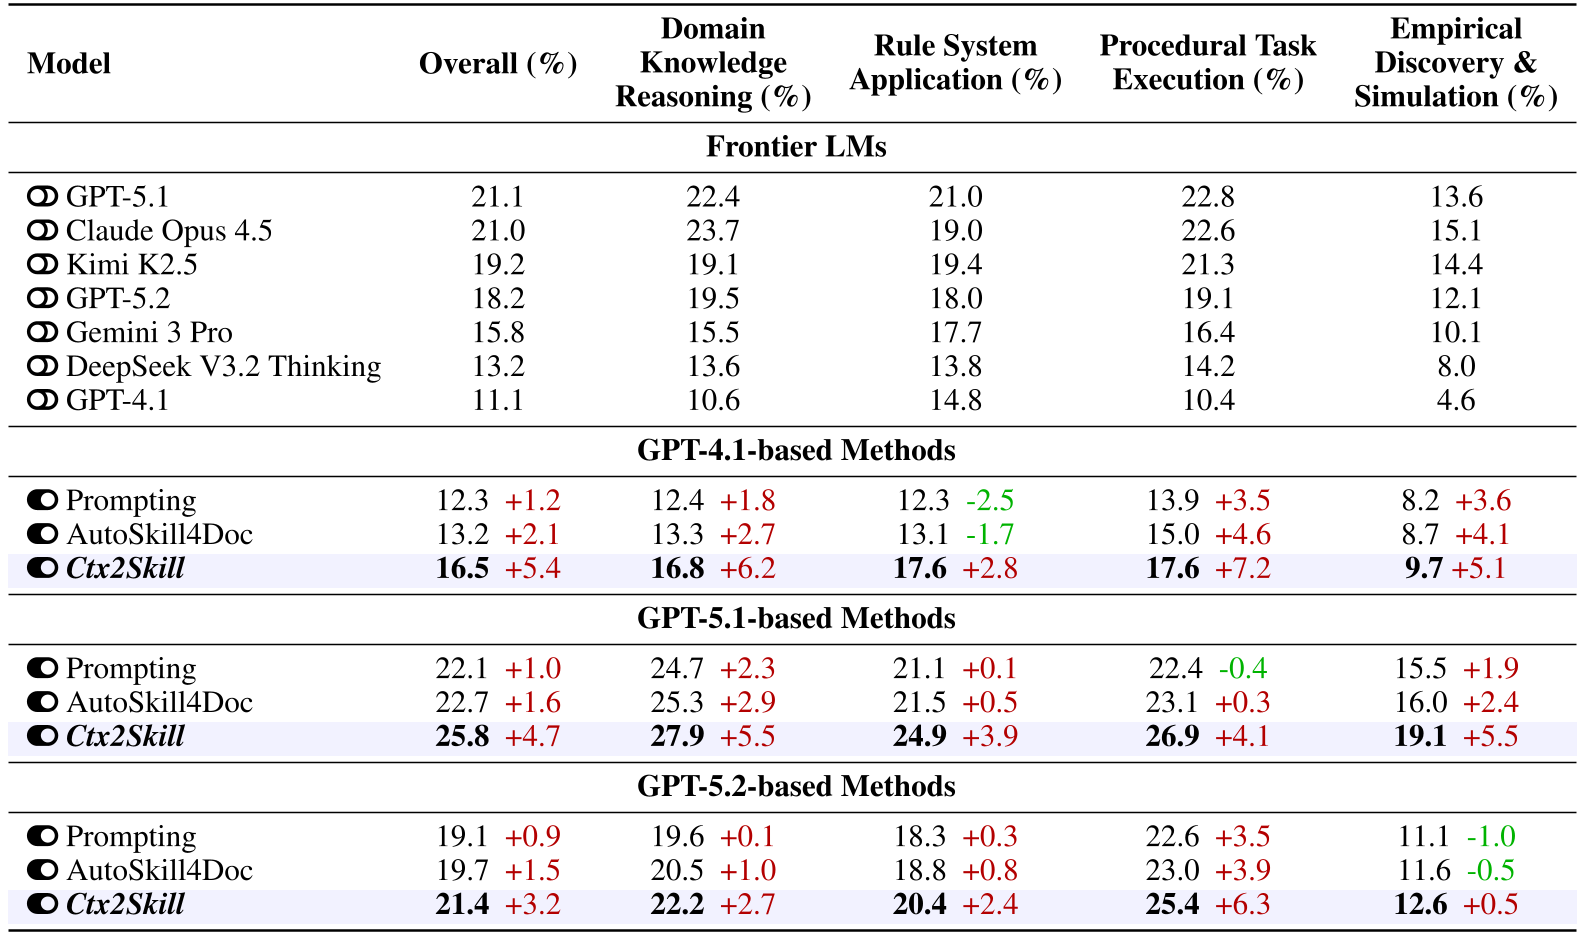 表1:不同模型在 CL-bench 上的性能提升。Ctx2Skill(蓝色部分)在各分项均保持领先。
深度洞察:为什么这种方法有效?
- 显性化逻辑:传统的上下文学习依赖模型的隐层表示。Ctx2Skill 将逻辑提取为自然语言技能,这种“显性化”过程其实是对模型的推理路径进行了结构化规范(Inductive Bias)。
- 失败驱动学习 (Failure-driven):通过诊断错误而非仅仅模仿成功,模型能更精准地识别语境中的边界条件。
- 可解释性:最终产出的 Markdown 格式技能书,人类可以读懂、审计甚至手动微调,这在对安全性要求极高的行业(如医疗、法律)极具吸引力。
局限性与展望
尽管 Ctx2Skill 表现强劲,但其推理成本在大规模应用时仍需优化,因为它涉及多次迭代的任务生成与评估。未来的研究方向可能包括将这些学到的显性知识通过蒸馏(Distillation)重新注回到模型的参数中。
总结:Ctx2Skill 证明了在大语言模型的时代,“学会如何学习”(Learn how to learn from context)可能比单纯增加参数规模更重要。