
[ICLR 2025] 语言模型学到了什么,何时学到的?揭秘预训练中的“隐式课程”
What do Language Models Learn and When? The Implicit Curriculum Hypothesis
本文提出了“隐式课程假设”(Implicit Curriculum Hypothesis),通过设计一套涵盖检索、逻辑推理和数学等 91 个原子及复合任务的评测集,系统性地揭示了大语言模型(LLM)在预训练过程中技能涌现的规律:即技能遵循从简单到复杂的组合式顺序,且该顺序在不同模型家族和规模间具有惊人的一致性。
TL;DR
长期以来,大模型预训练被视为黑盒,我们只知道 Loss 在降,却不知道模型在想。卡内基梅隆大学(CMU)和约翰霍普金斯大学的研究者通过这项工作证明:LLM 的预训练过程其实存在一套**“隐式课程表”**。技能不是随机开启的,而是像拼积木一样,从简单的 Copy、词干提取开始,逐步演化到复杂的跨语言翻译和多步推理,且这个顺序在不同厂商的模型中是高度通用的。
背景定位:跳出 Scaling Laws 的数值迷雾
虽然 Scaling Laws 告诉我们增加算力和数据能降低 Loss,但 Loss 的平滑曲线掩盖了内部逻辑技能的剧烈波动。作者提出的 Implicit Curriculum Hypothesis 指出:
- 组合性顺序:任务 A 只要是任务 B 的组成部分,A 就一定比 B 早学会。
- 跨模型稳定性:无论是 OLMo 还是 Pythia,大家的“学技能顺序”基本一致。
- 表示对齐:模型的内部表示(Representation)已经剧透了它未来会学会什么。
核心方法:构建技能的“原子”与“分子”
研究者设计了一个包含 91 个任务的实验场,将其分为两类:
- 简单任务(Simple Tasks):如字符串拷贝(Copying)、大小写转换、提取实体等“原子”操作。
- 复合任务(Composite Tasks):将简单任务串联,例如“提取动词 + 转为分词 + 全大写”(gerund_upper)。
通过在预训练的几千个 Checkpoints 上运行这些任务,作者捕捉到了每个技能“解锁”的瞬间。
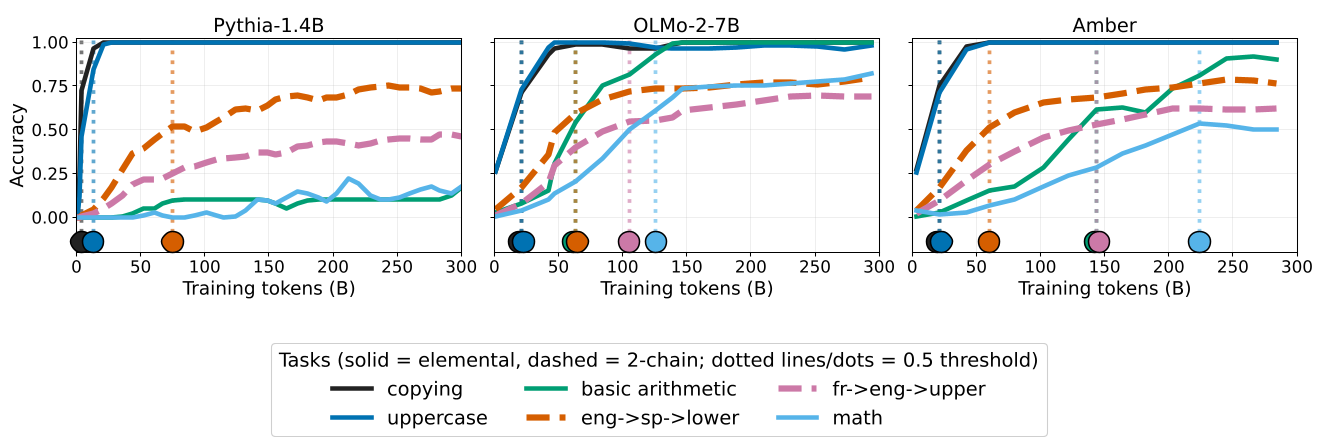 图 1:不同规模模型在各任务上的涌现点。纵轴代表任务复杂度,横轴代表训练步数,可以看到明显的梯度层次。
实验发现:全天下 LLM 都在上同一套课
1. 技能涌现的一致性
研究结果显示,所有模型几乎都遵循:拷贝 & 指代消解 -> 简单字符串操作 -> 词态变化 -> 知识检索 -> 逻辑运算 -> 多步算术。
有趣的是,这种一致性仅在**“绝对准确率”**定义下成立。如果你用模型自身能达到的最高水平百分比(相对阈值)来衡量,这种规律就会消失。这说明模型内部确实存在一种“通用的计算电路”形成过程。
2. 表示空间即预言机
这是本论文最惊艳的部分。利用 Function Vectors (FV),研究者发现如果两个任务在模型某一层的隐向量空间里靠得近,它们的学习曲线也极其相似。
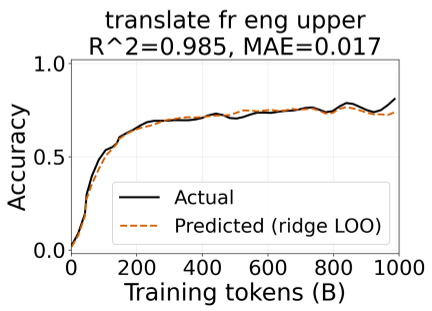 图 4:利用 FV space 预测的任务学习轨迹(虚线)与实际观察到的准确率曲线(实线)高度契合。
作者利用核脊回归分析发现,即使模型还没完全学会某个复合任务,只要看了它当前的中间层表示,就能预知这个技能在未来 500B 个 Token 后能否练成。
深度洞察:这对 AI 研发意味着什么?
- 预训练的“降压药”:开发者不再需要焦虑 Loss 曲线。如果预训练早期模型还没学会简单的 ICL 拷贝,那么强行喂再多数学题也是徒劳。
- 瓶颈诊断:当模型在 GSM8k 上表现不佳时,可以通过这套原子任务自测,查出到底是“翻译能力”没到位,还是“逻辑取反”没学会。
- 计算本质的再思考:为什么不同数据配比、不同架构的模型会呈现相同的课程顺序?这是否暗示了语言本质上存在一种最优的、必然的认知路径?
总结与局限
该研究通过严谨的实验支撑了“预训练是结构化发育”的观点。尽管其任务集仍偏向合成任务,对于更具启发性的“顿悟”(Grokking)现象解释尚浅,但它为我们观测模型内部演化提供了一台“高倍显微镜”。未来,或许我们可以根据这套隐式课程建议,动态调整预训练的数据比例,实现真正的自动化课程学习(Automated Curriculum Learning)。