
Graph-RAG 赋能制造业:如何让复杂的 AI 结果对工人“说人话”?
Using Large Language Models and Knowledge Graphs to Improve the Interpretability of Machine Learning Models in Manufacturing
本文提出了一种结合知识图谱 (Knowledge Graph) 与大语言模型 (LLM) 的 Graph-RAG 方法,旨在提升制造业中机器学习 (ML) 模型的后验可解释性 (Post-hoc Interpretability)。通过扩展 ML-Schema 建立领域知识库,并利用 LLM 驱动的 Branch-and-Bound 动态图遍历机制,系统能生成相比传统 XAI 工具更具业务上下文、更易理解的自然语言解释。
TL;DR
在制造业转型中,机器学习模型(ML)虽然能预测生产成败,但在解释“为什么”时往往只会抛出一堆复杂的数学公式。本文介绍了一种创新的方法:通过大语言模型 (LLM) 动态遍历知识图谱 (KG),将晦涩的算法逻辑(如 Shapley values)转化为工人也能听懂的自然语言。研究表明,这种基于 Graph-RAG 的多轮迭代生成方式能够显著提升生产决策的透明度。
背景:AI 在工业界的“信任危机”
工厂车间的操作工并不关心什么是“特征重要性评分”,他们关心的是“为什么预测这颗螺丝拧不上”。现有的 XAI(可解释人工智能)方法大多是“数学家给数学家的解释”,缺乏业务关联。此外,现有的 LLM 虽然懂人话,但容易产生幻觉。如何将严谨的工业结构化知识与灵活的 LLM 表述能力相结合,成了解决领域 AI 落地难的关键。
核心机制:基于图遍历的动态检索(Graph-RAG)
作者的核心 Insight 是:不要让 LLM 学习所有的知识,而是给它一本可以随时索引的“结构化百科全书”。
1. 扩展 ML-Schema 本体
为了让机器理解 ML 流程,作者在 ML-Schema 基础上,增加了硬件描述、具体任务关联及解释类型(Explainability techniques)等类别。
2. 多轮对话与 Branch-and-Bound 搜索
大多数 Graph-RAG 依赖复杂的推理语言(如 SPARQL),但这极易出错。作者提出了一种新的交互范式(见下图):
- Step 1/2: LLM 首先根据用户问题定位到图谱中的目标类(如 Dataset)和起始实例。
- Step 3: 采用类似算法竞赛中的 Branch-and-Bound(分支定界) 思想,LLM 在多轮对话中不断深入探索相邻节点,直到收集到足够信息触发
<STOP>指令。
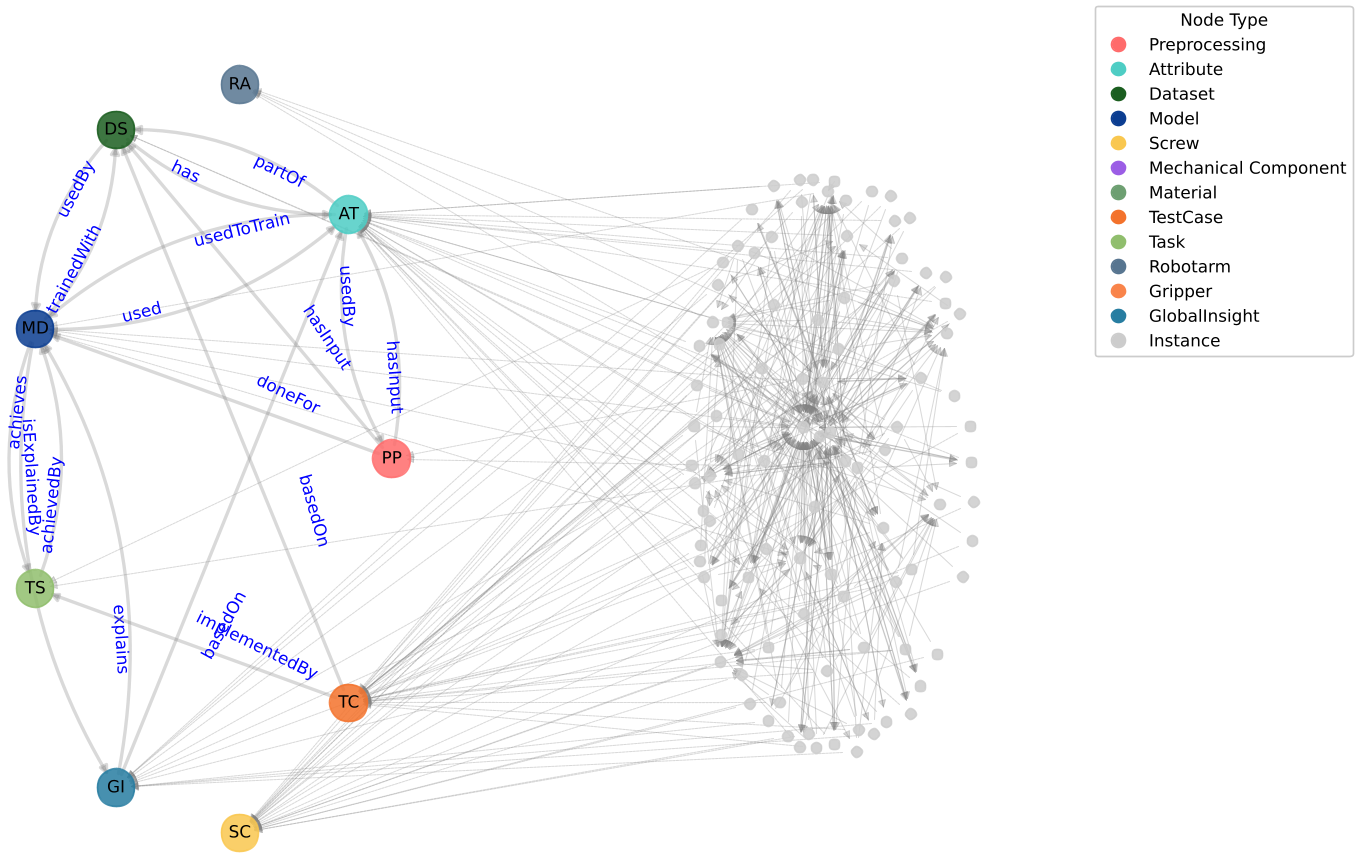 图 1:系统通过多轮交互从 KG 中提取结构化信息的流程
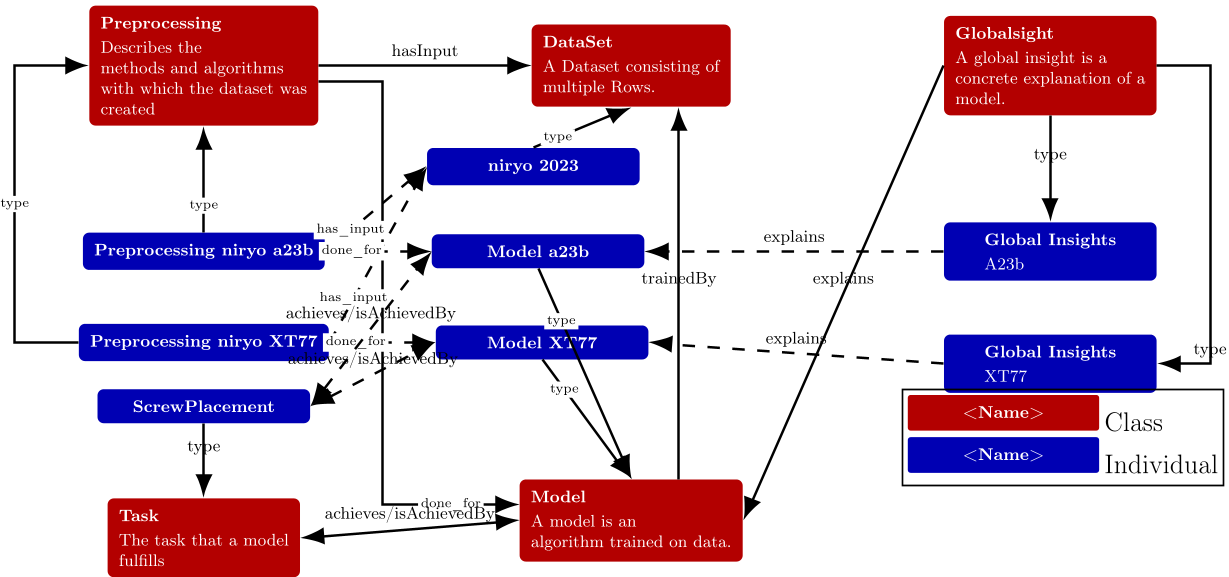 图 2:Algorithm 1 展示了基于 LLM 反馈的递归式信息检索逻辑
实验战报:开发者与工人的对视
在针对“工业机器人装配螺钉”任务的测试中,研究发现:
- 理解一致性:开发者群体对系统给出的解释反馈非常一致,认为结构清晰且有助于调试。
- 角色差异:在一线工人眼中,解释的长度(Length Appropriateness)是关键。过于繁琐的技术细节有时反而会增加认知负荷。
- 鲁棒性表现:面对错误的前提(例如问一个不存在的模型属性),系统能凭借图谱中的真实三元组进行反驳,展现了极强的“抗幻觉”能力。
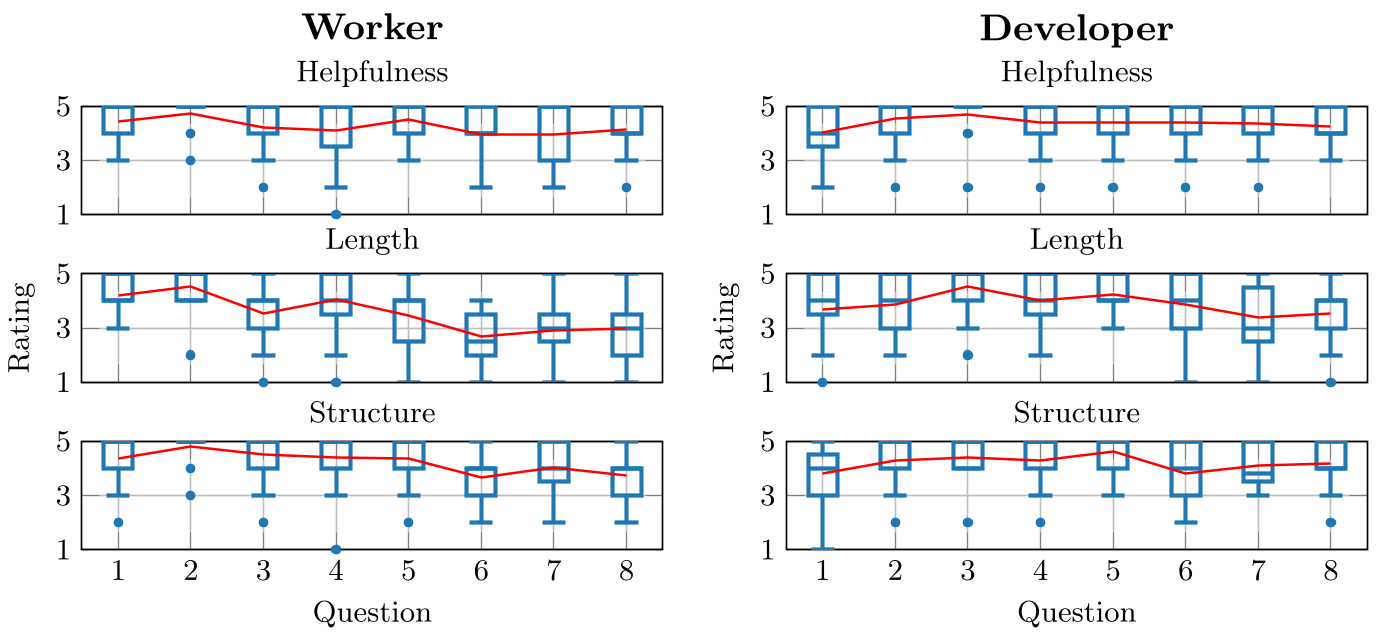 图 3:不同角色(Developer vs Worker)对解释权重的打分分布
深度洞察
- 为什么这种方法有效? 它将“推理”与“知识”解耦。KG 提供了不可撼动的真相(Ground Truth),而 LLM 充当了“翻译官”。这种动态子图检索比简单地把整张表扔进提示词(Prompt)要高效且精准得多。
- 未来痛点:即便如此,面对专门设计的对抗性攻击(Prompt Injection),LLM 仍可能绕过 KG 限制。如何在大模型在“遵循指令”与“严格基于知识”之间找到平衡点,是下一代工业 AI 系统的核心挑战。
总结
这篇论文为制造业 AI 提供了一个可落地的模板:知识图谱是根基,LLM 是界面。通过将后验解释集成到 Graph-RAG 流程中,我们正在接近一个 AI 能真正与劳动力协同工作的未来。