
HeadsUp:苹果视角下的大规模高保真 3D 头像前馈重建
Large-Scale High-Quality 3D Gaussian Head Reconstruction from Multi-View Captures
Apple 团队提出 HeadsUp,一种基于 3D Gaussian Splatting 的大规模前馈式头像重建方法。该方法采用 Encoder-Decoder 架构,通过 UV 参数化将 3D 高斯锚定在标准头部模板上,实现了在万级 identity 数据集上的高效 SOTA 重建。
TL;DR
在 3D 数字人领域,如何在极短时间内从多视角相机阵列中生成“照片级”头像一直是工业界的难题。Apple 研究团队推出的 HeadsUp 给出了一套优雅的解法:通过 UV 参数化的 3D 高斯 (3DGS) 和 Transformer 编码器,实现了在 0.1-0.3 秒内完成高质量重建。该模型在 10,000 个 Identity 的大规模数据集上训练,性能大幅超越过往 SOTA。
痛点深挖:为什么之前的模型“跑不动”?
传统 3D 头部重建面临“既要、又要”的窘境:
- 优化法 (Optimization-based):虽然精细,但每个用户都要训练半天,无法大规模落地。
- 像素对齐前馈法 (Pixel-aligned Feed-forward):典型代表如 Avat3r,其高斯数量随输入图像分辨率和视角线性增长。当你试图用 16 个高分辨率相机进行重建时,显存会瞬间爆炸(OOM),且难以处理头发这种复杂的非流形几何。
核心动机 (Motivation)
HeadsUp 的核心直觉是:解耦 (Decoupling)。
- 解耦输出与输入:通过 UV Map 来承载 3D 高斯属性,无论你输入 1 个视角还是 16 个视角,输出的高斯数量是恒定的(约 65K)。
- 引入几何先验:将高斯锚定在通用的中性模版上,让网络专注于学习“外观差异”而非从零构建“几何形状”。
Methodology:HeadsUp 架构详解
HeadsUp 的架构分为两个核心阶段:
1. 多视角编码 (Multi-View Encoder)
系统首先将 N 个校准视角的图像进行 Patchify,并注入 Plücker 嵌入(一种表达射线几何的高级方式)。接着,一个 Cross-Attention Transformer 将这些无序的视角特征聚合成一个 3D 头部潜在表征 。
2. UV 空间解码 (Gaussian UV Decoder)
这是本文的精髓所在。解码器并非直接生成点云,而是生成一张 2D UV 特征图。
- 每个 UV 坐标 对应一个 3D 高斯。
- 属性包括:3D 位置偏移 、缩放 、旋转旋转 、透明度 和球谐系数 (SH) 颜色。
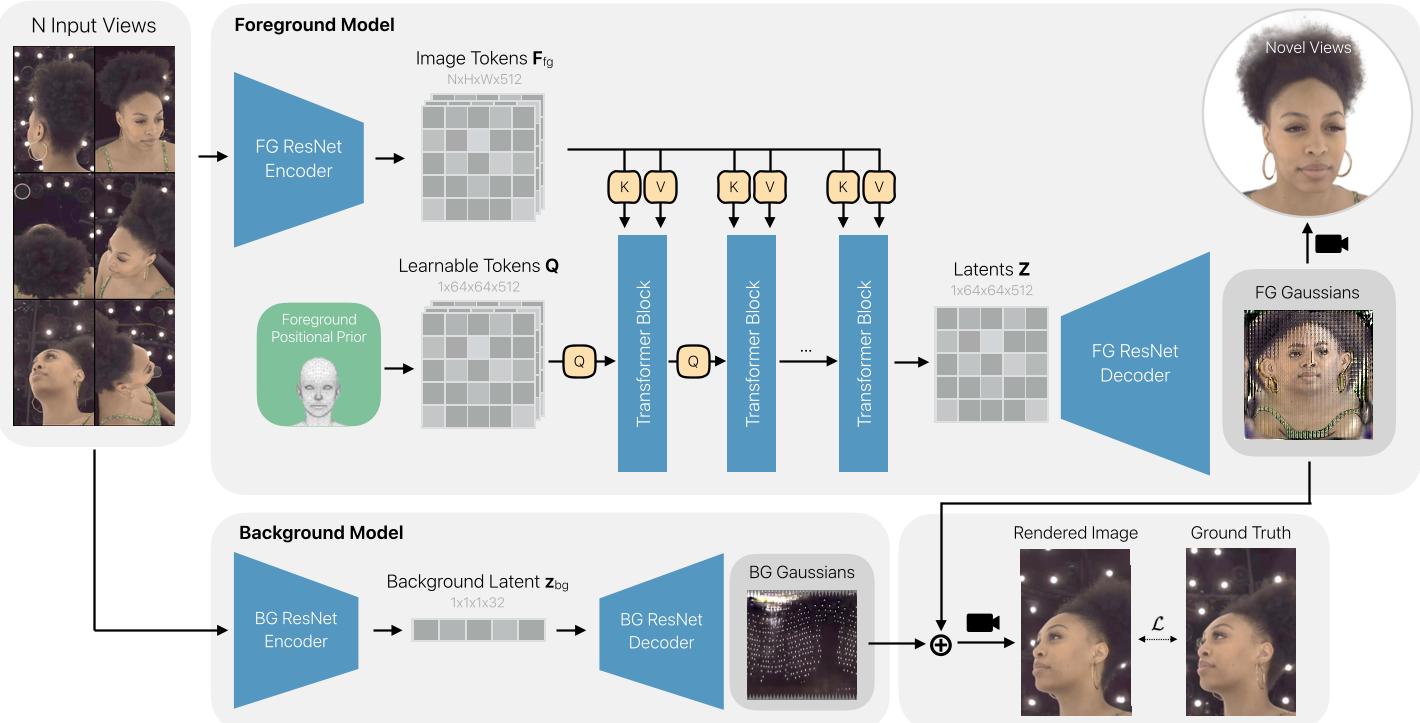
3. 特殊武器:显式背景建模
为了处理细碎的头发丝,作者不再生硬地进行前景分割(Foreground Matting),而是专门用一个轻量级 Decoder 渲染背景。这种“双管齐下”的策略有效地避免了背景伪影污染受损的头像边缘。
实验与结果:降维打击
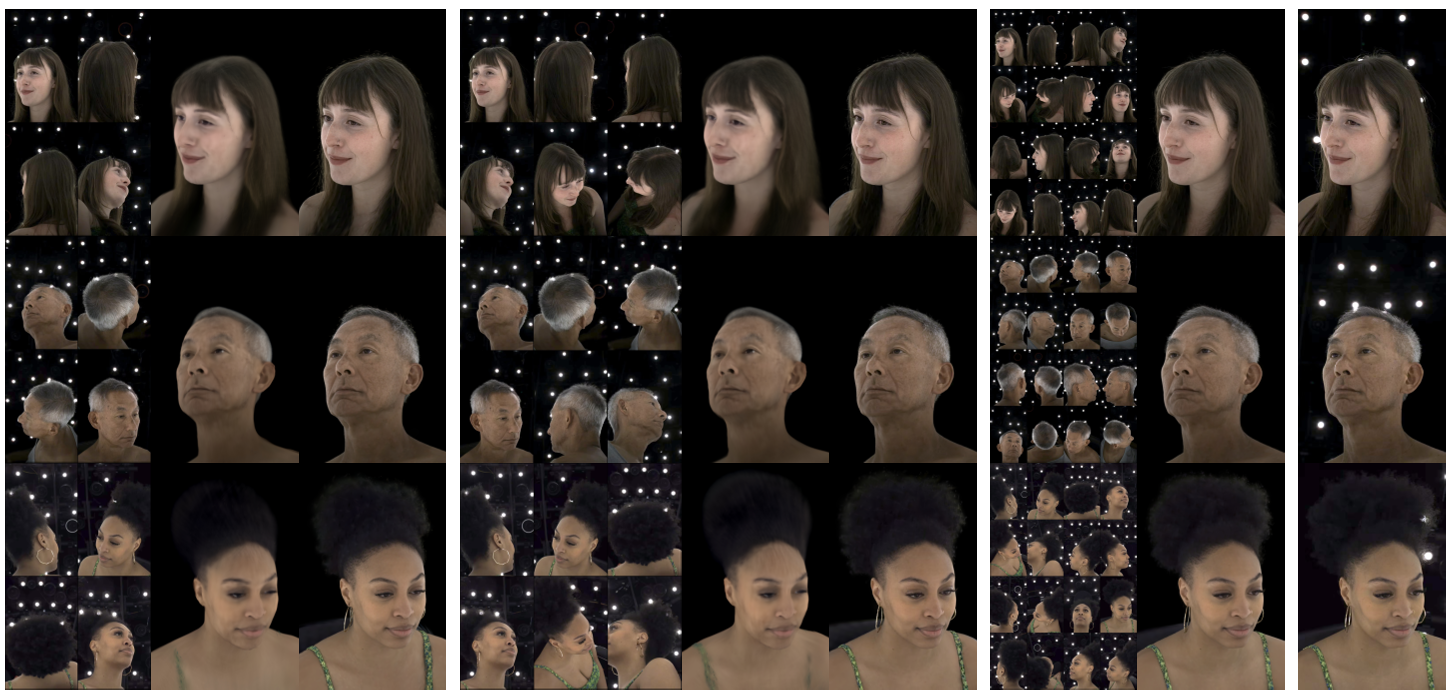
在 Apple 的内部万级数据集和公开的 Ava-256 上,HeadsUp 展示了统治级的表现。
- 性能对比:在相同视角下,HeadsUp 的 PSNR 领先 baseline 超过 5dB。
- 扩展性:即便输入视角增加到 16 个,推理时间也仅从 0.14s 略微增加到 0.33s,而对比方法早已崩溃。
- 细节捕捉:在双阶段训练策略(包括局部区域特定的 Loss)加持下,模型对眼睛、牙齿和饰品的刻画达到了工业级水准。
深度洞察:潜在空间的二次利用
这篇论文最令人兴奋的部分不仅是重建,而是其生成的 潜在空间 极其稳健。
- 生成新身份:通过在 空间训练 Diffusion Transformer (DiT),你可以直接用文字生成出从未见过的 3D 头像资产。
- 表情驱动:通过在 空间学习 Blendshape 偏移,可以实现非常丝滑的表情控制。
总结与启示
HeadsUp 证明了:
- UV 参数化是前馈式 3DGS 走向高性能、规模化的正确路径。
- 大规模数据 (Scaling Law) 对重建质量有明显边际效应。在 4K 身份之后提升放缓,这提示我们未来的重点可能在于模型架构的提升而非单纯的数据堆砌。
- 局限性:虽然摆脱了表情追踪依赖,但依然受限于中性模版的拓扑,对于极其夸张的模型外饰可能处理欠佳。
这篇论文不仅是 Apple 在 3D 技术上的炫技,也为未来在移动设备上实现即时、高保真的 3D 远程通信奠定了坚实基础。