
Latent Bridge:预测“增量”胜过重复计算,VLA 模型推理提速的艺术
Latent Bridge: Feature Delta Prediction for Efficient Dual-System Vision-Language-Action Model Inference
本文提出了 Latent Bridge,一种专为双系统视觉-语言-动作(VLA)模型设计的轻量级增量预测模型。该方法通过预测 VLM 主干网络在时间步间的输出增量(Delta),在无需调用昂贵 VLM 的情况下实现高频动作推断,成功将 VLM 调用次数减少 50-75%。
TL;DR
在机器人控制领域,Vision-Language-Action (VLA) 模型虽然聪明但“步履蹒跚”。本文提出的 Latent Bridge 核心直觉极其简单而有效:既然连续时间步之间的视觉特征变化微乎其微,为什么不让昂贵的 VLM 模型“休息”几步,改用一个极速的小模型来预测特征的**变化量(Delta)**呢?该方法在几乎不损失成功率的情况下,让模型推理提速 1.7 倍,直接打破了双系统 VLA 的部署瓶颈。
1. 痛点:被 VLM 拖累的实时控制
当前的 SOTA 机器人模型多采用“双系统”设计:
- Stage 1 (重型主干):VLM(如 Qwen 或 Gemma)提取视觉-语言表征。
- Stage 2 (轻型动作头):轻量级网络将表征解码为机器人的关节指令。
问题在于,主干网络规模巨大,每秒运行几十次会耗尽计算资源。研究者们发现,连续两个时刻 VLM 输出的特征向量余弦相似度往往高达 0.99 以上。这意味着我们支付了昂贵的算力,却只得到了一堆重复的信息。
2. 核心算法:Latent Bridge 的“借代”方案
Latent Bridge 不再去计算完整的特征 ,而是计算 。
架构设计
作者针对两种主流设计实例化了 Bridge:
- Feature-space Bridge (针对 GR00T):直接预测特征向量的残差。
- KV-cache Bridge (针对 π0.5):预测多层 Transformer 的键值对(KV)缓存增量。
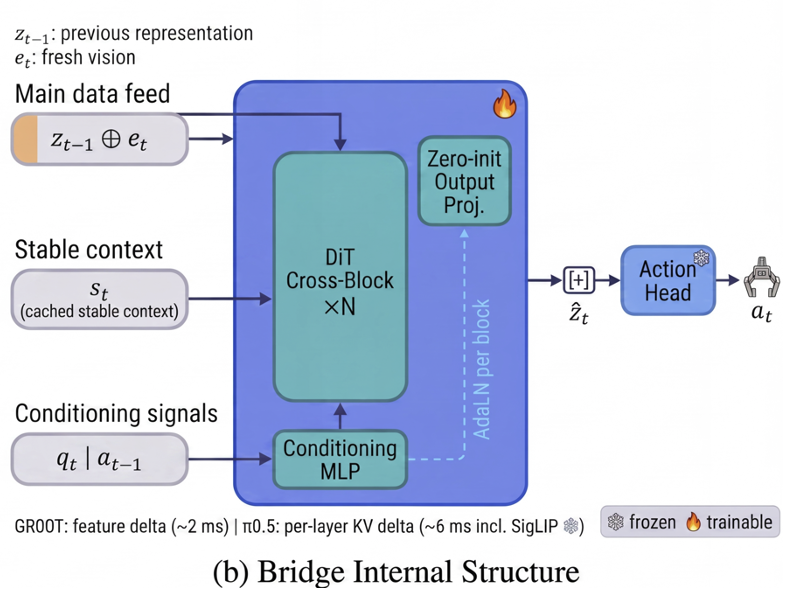 图 1:Latent Bridge 架构。其输入包含上一时刻特征、当前机器人状态、前一动作,以及极其廉价的原始视觉特征。输出层采用零初始化,确保训练初期 Bridge 相当于简单的“特征缓存”。
DAgger:解决“差之毫厘,谬以千里”
Bridge 在推理时是自回归连接的(即用自己预测的特征作为下一步预测的输入)。这种模式会导致误差累积。为了解决这个问题,作者引入了 DAgger (Dataset Aggregation) 流程: 在模拟器中运行 Bridge 策略,同时让“上帝视角”的 VLM 产生真实特征作为监督信号,强制 Bridge 学习如何纠正自己之前留下的偏差。
3. 实验战果:更轻快,更精准
在 LIBERO 任务集上,Latent Bridge 展示了统治级的性能:
- 高保真度:在 f=4(每 4 步才调用一次 VLM)时,平均成功率保持在同步模式的 95% 以上。
- 真加速:相比此前只能提供 ~1.08x 加速的 Token Pruning 方法,Latent Bridge 达到了 1.65x - 1.73x 的净提速。
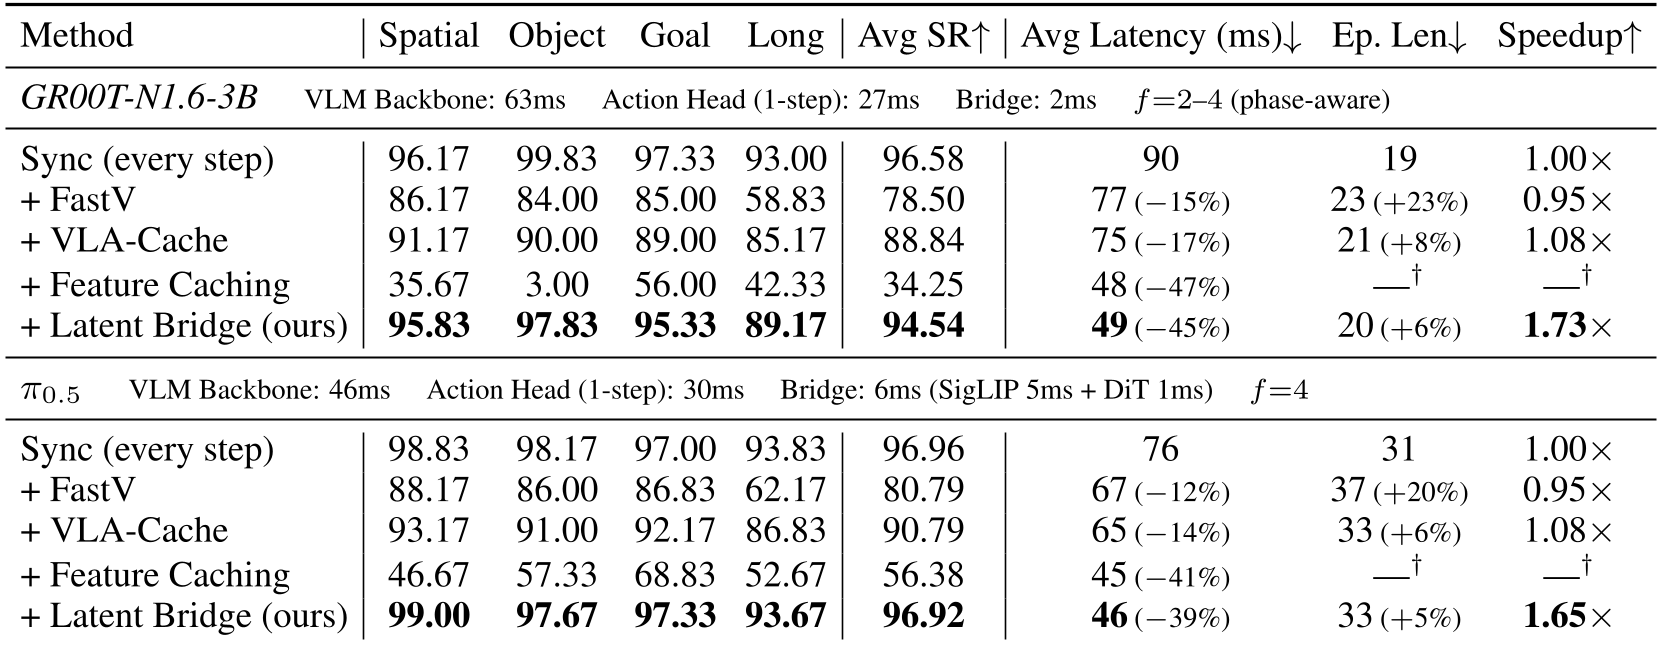 表 1:Latent Bridge 在各类指标上显著超越了 FastV 和 VLA-Cache 等强力基准。
典型案例对比
为什么简单的“特征缓存(Feature Caching)”会失败? 如下图所示,当机器人移动时,真实特征会迅速变化。直接重用旧特征(红色曲线)会导致特征保真度(Cosine Similarity)锯齿状暴跌,机器人动作随即变形。而 Latent Bridge(蓝色曲线)通过预测增量,始终贴合真实轨迹。
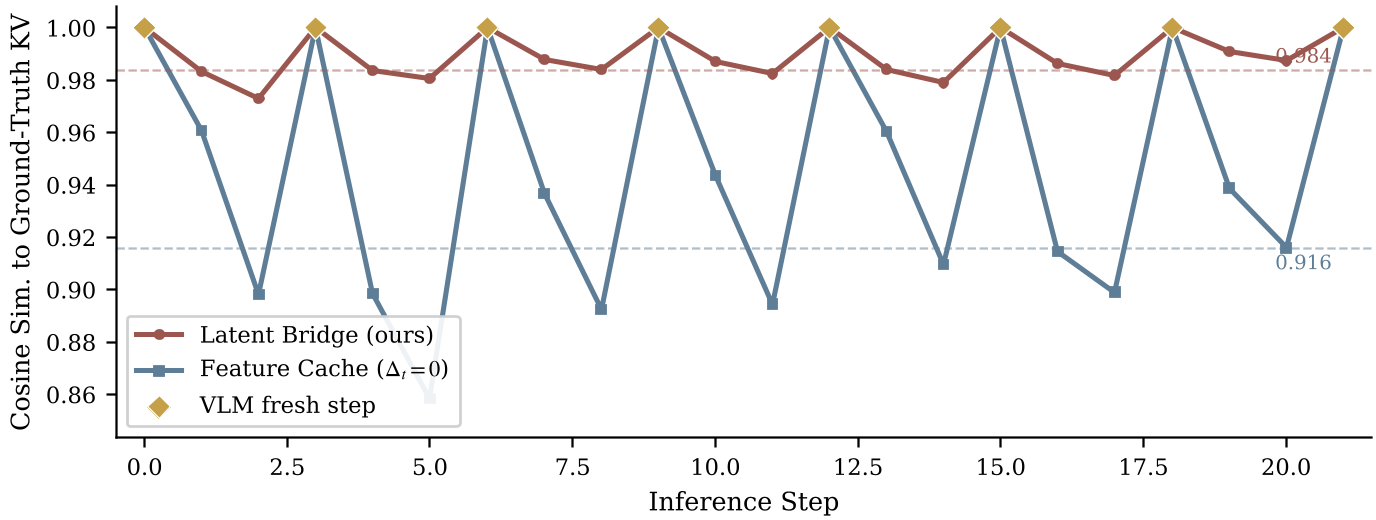 图 2:KV 缓存相似度对比。可以看到 Bridge 极大地缓解了由于 VLM 跳帧带来的信息滞后。
4. 深度洞察
- 跳过(Skipping) vs 优化(Optimization):这篇文章最深刻的启示是,在具身智能中,模型的“反应频率”往往比“单次计算精度”更关键。即便把 VLM 剪枝一半,它依然很慢。而完全跳过主干网络,即便 Bridge 本身存在轻微预测误差,高频的动作闭环也能自我补偿修正。
- 视觉锚点的重要性:消融实验显示,如果 Bridge 失去廉价的视觉输入(如 SigLIP),长程任务(LIBERO-10)的性能会骤降。这说明 Delta 预测不能只看历史特征,必须感知当前视觉环境的变化。
5. 总结与局限
Latent Bridge 为大规模 VLA 模型的端侧部署开启了一扇新窗。它不需要改动原始 VLA 权重,仅需几小时训练一个小 Bridge 即可平替昂贵的计算环节。
局限性:目前该方案高度依赖模拟器(用于 DAgger 训练),且增量预测对那些将机器人状态编码进 Prompt 的模型(State-in-prompt)支持不够完美。未来的研究方向可能在于如何实现完全脱离模拟器的离线增量学习。
Takeaway for Practitioners: 如果你的视觉基座模型推理太慢,不要总想着给它减脂(Pruning),考虑给它修一座“潜空间桥梁(Latent Bridge)”,跨过那些冗余的计算步骤。