
LatentRAG:将 Agentic RAG 推理速度提升 10 倍的隐空间革命
LatentRAG: Latent Reasoning and Retrieval for Efficient Agentic RAG
本文提出了 LatentRAG 框架,这是一种高效的 Agentic RAG(代理式检索增强生成)系统。该方法将传统的串行语言空间推理与检索转移到连续的隐空间(Latent Space),通过单次前向传播生成隐标记(Latent Tokens),在保持与主流 Agentic RAG(如 Search-R1)相当性能的同时,将推理延迟降低了约 90%。
1. TL;DR
传统的 Agentic RAG 虽然在处理复杂多步问题上表现卓越,但其“边想边搜”的机制导致了巨大的延迟,通常比普通 RAG 慢上十几倍。LatentRAG 彻底颠覆了这一现状:它通过在 连续隐空间(Latent Space) 中进行推理和检索,消除了冗长的逐字文本解码。实验表明,它在保持 SOTA 性能的同时,将推理延迟降低了足足 90%,让复杂推理任务也能拥有接近实时响应的速度。
2. 痛点深挖:为什么 Agentic RAG 这么慢?
在诸如 Search-R1 或 AutoRefine 等先进框架中,LLM 扮演着“搜索代理”的角色。每一步它都要生成:
- Thinking (CoT): “我下一步应该搜什么?”
- Subquery: 实际发送给搜索引擎的字符串。
这种模式下,LLM 必须通过 Autoregressive Decoding(自回归解码) 逐字产生这些文本。研究发现,这两个阶段占用了总耗时的 90%。在多跳问答(Multi-hop QA)任务中,这种串行依赖导致的延迟让用户难以忍受。
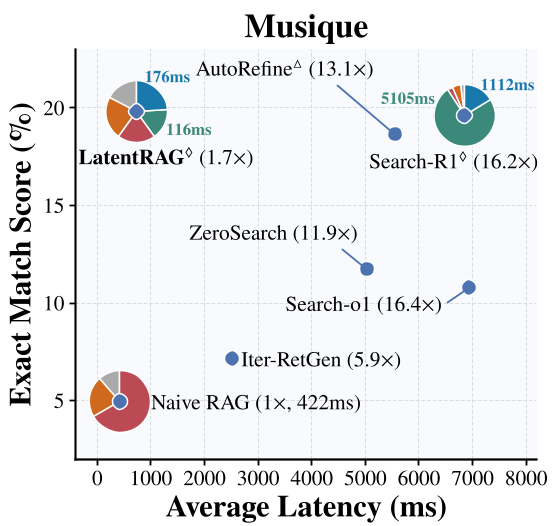 图 1:Agentic RAG 与 Naive RAG 的延迟对比,显示生成阶段是核心瓶颈。
3. 核心方案:从离散语言到连续隐空间
LatentRAG 的核心直觉是:既然中间思维和子查询只是给模型和检索器看的,为什么非要转换成自然语言不可?
3.1 隐标记生成 (Latent Generation)
LatentRAG 使用预定义的 [THINK] 和 [QUERY] 等特殊标记(Special Tokens)占位。LLM 只需进行一次前向传播(Forward Pass),直接提取最后一层隐藏状态(Hidden States)作为 Latent Tokens。这种方法利用了 Transformer 的计算并行性,彻底告别了慢速的自回归解码。
3.2 隐空间检索对齐 (Latent Retrieval Alignment)
如何让检索模型理解这些“隐藏状态”?作者引入了一个轻量级的 Projector,并提出了一种基于 KL 散度(KL Divergence) 的对齐目标:
- 将 Latent Tokens 投影成检索向量。
- 最小化 Latent 向量产生的检索分布与真实文本子查询产生的检索分布之间的差异。 这种端到端的联合优化,使得模型能够学习到比普通文本更高效的检索表示。
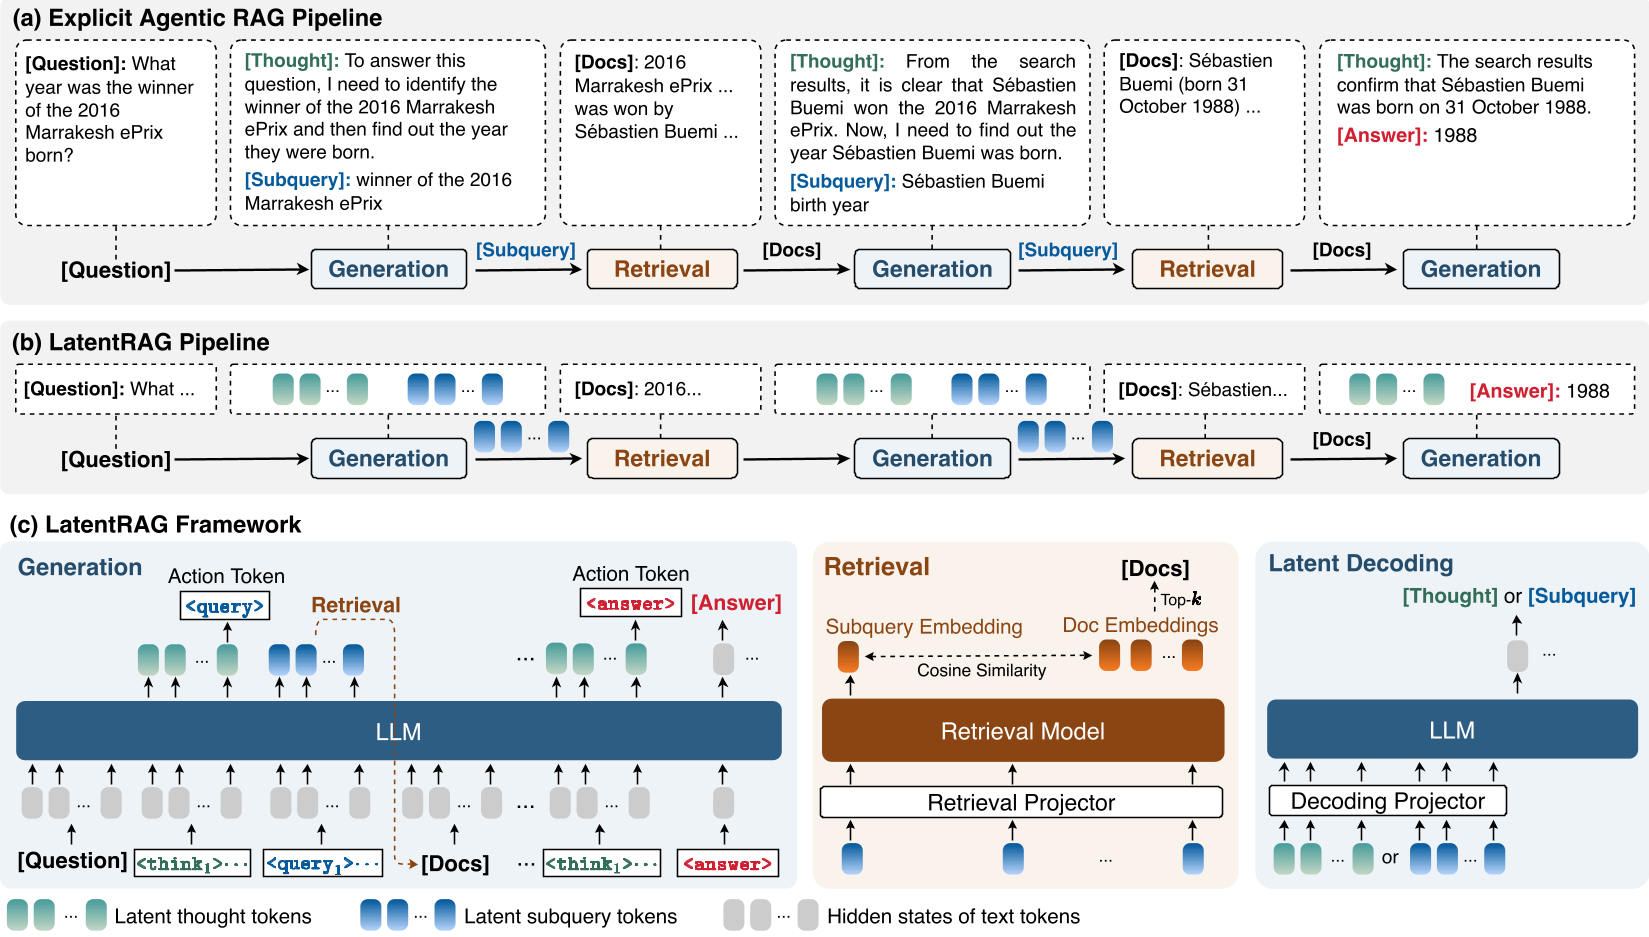 图 2:LatentRAG 与传统 Agentic RAG 的架构对比。
3.3 可视化透明度:并行解码
为了解决隐空间不可解释的问题,LatentRAG 提供了一个可选的并行解码机制。它能将 Latent Tokens 瞬间还原为自然语言思维。由于各步骤的解码是独立的单次操作,它依然比传统的串行生成快得多。
4. 实验战绩:极致性能与速度
在 NQ、HotpotQA 等 7 个权威数据集上,LatentRAG 展示了恐怖的效率提升:
- 性能持平:在 Qwen2.5-7B 骨干模型上,EM(精确匹配)分数与 Search-R1 几乎一致(甚至在部分任务上有 2%+ 的微增)。
- 延迟剧降:平均运行时间从 5000ms+ 压缩到了 500-600ms 左右,加速约 9 倍。
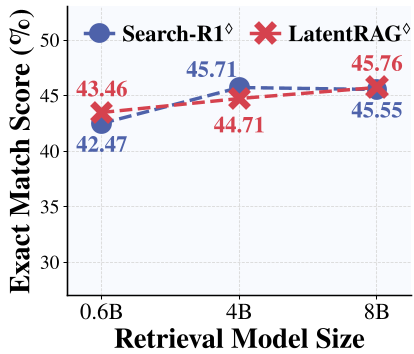 图 3:分阶段延迟对比,LatentRAG 在 Thought 和 Subquery 生成上几乎不耗时。
此外,通过 LogitLens 分析(见下图),我们发现即便不强制对齐词表,Latent Tokens 内部依然自发聚集了与任务高度相关的语义信息(如“Christianity Today”或“William Goldman”)。
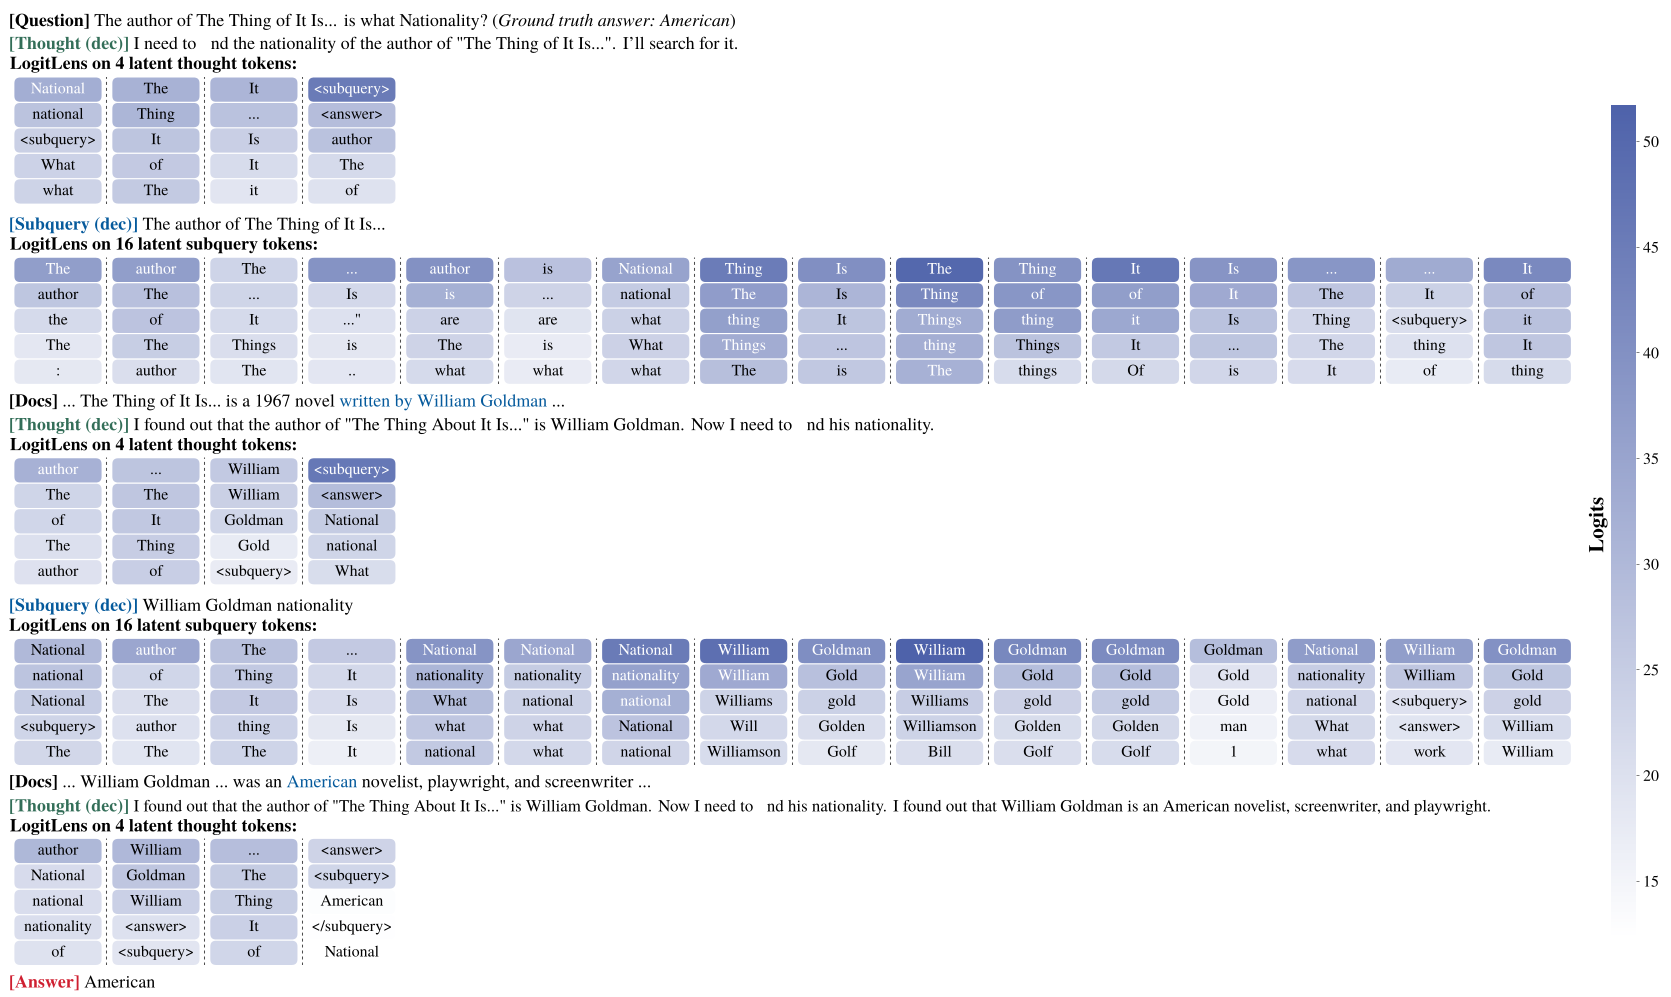 图 4:LogitLens 显示隐空间标记实际上精准捕捉了复杂的语义实体。
5. 深度洞察与总结
LatentRAG 的成功揭示了 LLM 代理的一个重要演进方向:从“以人为中心”的自然语言搜索,转向“以模型为中心”的向量化搜索。
优势:
- 极速响应:为实时 Agent 应用扫清了障碍。
- 端到端可导:解决了检索信号无法反向传播给 LLM 的痛点。
- 灵活的透明度:开发阶段开启解码用于调试,生产环境关闭解码以保速度。
局限性:
- 数据依赖:目前依赖于现有强大模型生成的轨迹(SFT)进行训练。未来的探索方向应该是利用强化学习(RL)让 Agent 在隐空间自主探索。
总结:LatentRAG 证明了“少说话、多思考”在连续向量空间中不仅可行,而且极其高效。它是连接单步检索与复杂代理推理之间那座缺失的桥梁。