
告别盲目堆料:RLVR 在低资源场景下的“反直觉”缩放定律
Learning from Less: Measuring the Effectiveness of RLVR in Low Data and Compute Regimes
本文针对计算资源和标注数据受限的场景,系统研究了小参数语言模型(SLM)在可验证奖励强化学习(RLVR)下的性能表现。通过三个程序化生成的推理数据集,作者揭示了数据多样性、任务复杂度和样本效率之间的非线性缩放关系,证明了 Qwen3-4B 在低数据量下仍能通过 RLVR 获得显著推理提升。
TL;DR
在追求 DeepSeek-R1 式推理能力的道路上,算力和数据是两大门槛。本文研究发现:在低资源环境下,100 个精心挑选的“难易混合”样本,效果甚至优于 500 个“简单”样本。作者通过对 Qwen3-4B 的 RL 微调实验证明,RLVR(可验证奖励强化学习)的成功并不总是依赖于海量数据,关键在于任务的多样性与计算预算的动态平衡。
背景定位
虽然 Scaling Laws 告诉我们“越多越好”,但在学术界和工业界边缘计算场景中,我们常面临 Low Data(数据少) 和 Low Compute(算力穷) 的双重困境。本文是针对小模型(SLM)在特定领域进行 RLVR 微调的实战指南,填补了 RL 扩展定律在小规模区间的研究空白。
痛点深挖:为什么简单的 RL 训练会“崩盘”?
很多开发者在对 SLM 进行强化学习时会发现,模型不仅学得慢,甚至会出现性能坍塌。作者指出,这通常源于:
- 奖励稀疏性:简单的任务奖励太容易拿,模型学不到深层推理;复杂的任务因为 Token 长度限制或由于模型本身能力不足,拿不到正向奖励。
- 固定算力的陷阱:在训练步数固定的情况下,增加数据量意味着每个样本获得的优化次数减少,导致学习不充分。
- 梯度不稳定性:在极小数据集(如 100 样本)上,若数据缺乏多样性,极易出现梯度爆炸(Gradient Spikes),导致训练指标瞬间归零。
核心方法:程序化生成与难度分层
为了精准受控,研究者设计了三个数据集:计数(Counting)、图推理(Graph)和空间推理(Spatial)。
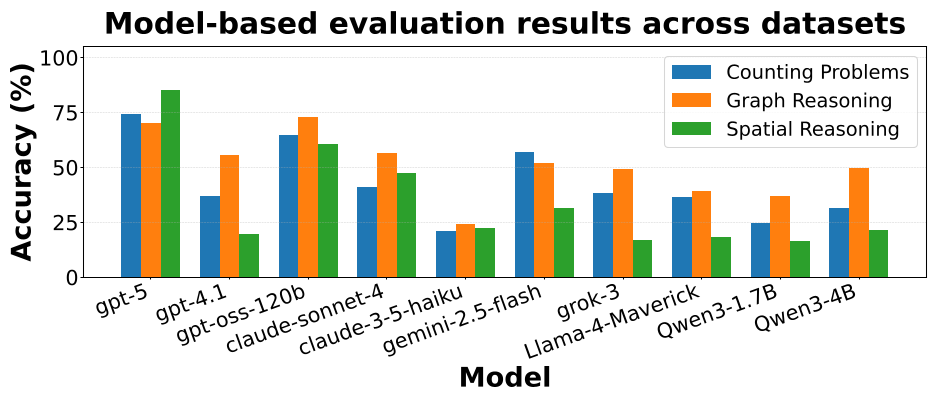 图 1:10 种不同模型在三个初始数据集上的表现,展示了任务的区分度。
关键战术:难度校准
作者没有拍脑袋决定什么是“难”,而是用 GPT-4o、Claude、Llama 等 10 个模型跑一遍,根据它们的平均通过率(Pass Rate)划分:
- Easy: 67% 以上模型能做对。
- Mixed: 均匀混合 Easy、Medium 和 Hard 样本。
算法选择:GRPO + LoRA
选择了 Qwen3-4B 作为基底,使用 GRPO (Group Relative Policy Optimization)。这种算法通过组内相对比较来估计 Advantage,能有效减少奖励方差,且不需要额外的 Value Network,极大节省了显存。
实验结果:5 倍的样本效率增益
实验得出了两个颠覆直觉的结论:
1. 混合数据是“降维打击”
在计数问题中,仅用 100 个混合难度样本 训练出的模型,性能就达到了 500 个简单样本 训练出的水平。这意味着在 RLVR 场景下,数据多样性可以作为数据规模的低成本替代品。
2. “倒 U 型”缩放曲线
在算力预算(Training Steps)固定时,数据并不是越多越好。
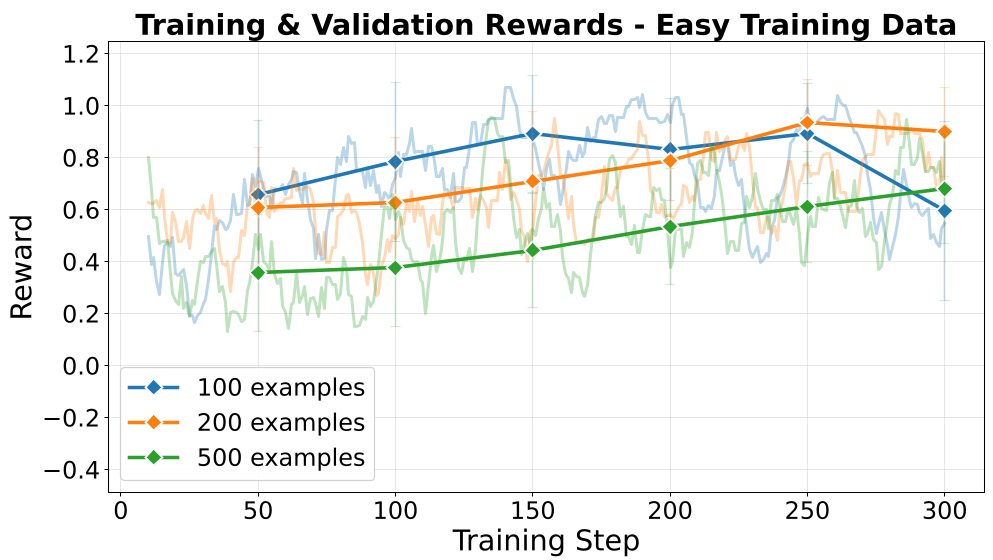 图 2:注意左侧计数任务中,Easy-100(蓝色)在 200 步左右发生了灾难性的奖励崩溃,而 Mixed-100(右侧蓝色)则非常稳定。
实验显示,空间推理任务中,样本量从 200 增加到 500 时,测试准确率反而下降了 3.6%。这是因为有限的更新次数被平摊到了过多样本上,导致模型“贪多嚼不烂”。
3. 图推理的“Token 墙”
在图推理任务中,由于输出需要结构化的 JSON 且逻辑复杂,即便模型有潜力学对,也常因触碰 max_tokens 限制而导致验证失败(Extraction Failures),这解释了为什么该任务的曲线表现最差。
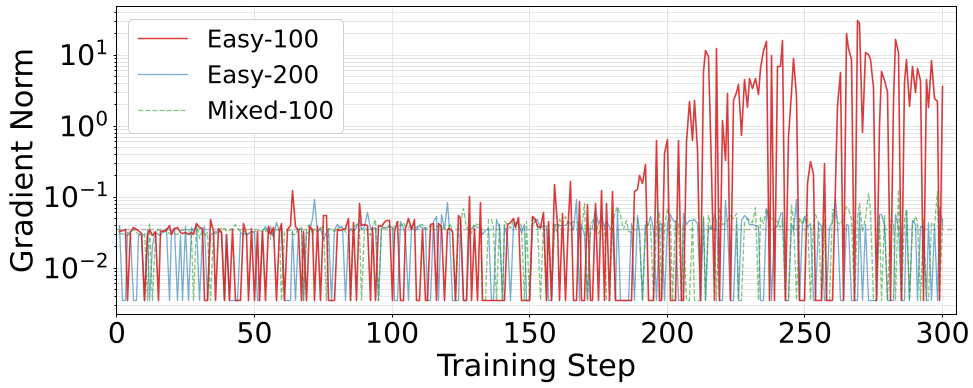 图 3:梯度范数监控。Easy-100 的尖峰解释了其训练崩溃的物理原因,说明多样性不足会导致优化动力学极其脆弱。
深度洞察:给实践者的建议
- 优先混合难度:如果你只有几百个标注样本,务必确保里面有一定比例的“难题”,哪怕模型现在还做不出。难度梯度能提供更稳定的梯度方向。
- 算力与数据挂钩:如果你增加了数据集大小,必须同步增加迭代步数。若算力卡死,宁可削减样本量,提高每个样本的利用率。
- 监控奖励构成:不要只看总分。如文章所示,拆解正确率(Correctness)和格式(Format)分数。如果格式分很高但正确率低,说明模型在“投机取巧”拿格式分,需要调整奖励权重。
总结与展望
这篇论文有力地反击了“RL 只能是巨头游戏”的论点。通过精细化的数据工程(Procedural Data)和难度调度,4B 等级的 SLM 也能在垂直领域进化出强大的推理灵魂。未来的研究方向将集中在“长度自适应优化”——解决如何让模型在有限的 Token 预算内完成更深思熟虑的推理。
局限性声明:本研究基于 LoRA 微调及单次实验种子,结论在全参数微调或更大参数模型上的泛化性仍待进一步大规模验证。