
NEO:像科学家一样思考,从观测中诱导世界的“思维语言”
Learning to Theorize the World from Observation
本文提出了 Learning-to-Theorize (L2T) 学习范式,旨在从原始非文本观测中推断出显式的、可执行的解释性理论。核心方法 NEO (Neural Theorizer) 通过诱导潜在程序作为“思维语言 (Language of Thought)”,在 GridWorld、算术推理和图像编辑任务上实现了超越 SOTA 的组合泛化能力。
TL;DR
传统的 AI 模型擅长预测“接下来会发生什么”,但往往无法解释“为什么会发生”。本文介绍的 Neural Theorizer (NEO) 改变了这一现状。它不再仅仅拟合输入输出的映射,而是学习从观测中构建可执行的程序作为对世界的理论解释。这种方法让 AI 具备了类人的组合泛化能力,即使面对从未见过的复杂场景,也能通过组合基础原语来化解。
核心动机:从预测者到理论家
发展认知科学认为,人类儿童并非被动的预测机器,而是“摇篮里的科学家”。他们在掌握语言之前,就能通过观察物体运动构建内部理论。
当前的 World Models(如 SORA 或 Dreamer)通过潜在空间的轨迹预测来实现理解,但它们的局限性在于:
- 非成分化(Non-compositional):学到的表征是纠缠的单体(Monolithic),不可拆解。
- 泛化性差:一旦环境发生微小变化或操作序列变长,模型就会崩溃。
作者由此提出 Learning-to-Theorize (L2T):AI 应该学习如何发现可重用的“原语”(如“旋转”、“移动”、“取反”),并将其组合成逻辑严密的理论。
技术深挖:NEO 的内部构造
NEO 的核心是将观测对 转化为一段潜在程序 。
1. 理论编程器 (Theory Programmer)
这部分是一个目标条件策略 。它观察当前状态 和目标结果 ,决定下一步该执行哪个“原语” 。这些原语存储在一个通过 VQ-VAE 学习得到的离散码本(Codebook)中。
2. 状态锚定 (State Grounding) 与 MDL
这是 NEO 能够成功的两项关键设计:
- State Grounding:强制要求程序执行的每一步中间结果都必须落在有效的观测流形上。这防止了模型学习到毫无意义的“捷径”表征。
- 最小描述长度 (MDL):模型在遇到多种解释时,会优先选择最短、最简洁的程序。这符合奥卡姆剃刀原理,迫使模型发现最本质的原语。
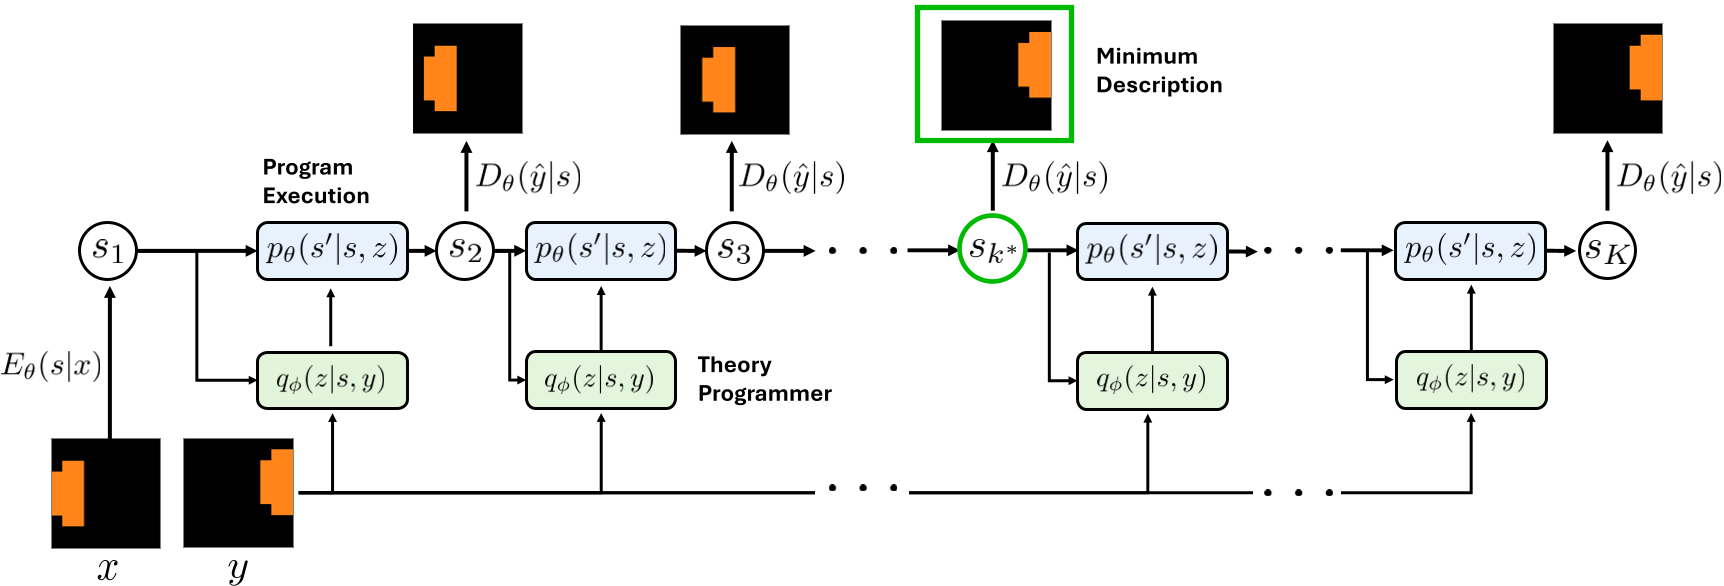 图 2:NEO 的计算图。模型通过迭代选择原语并执行,逐步将初始状态引导至目标结果。
实验战绩:突破组合爆炸
作者引入了 OTIB(Observation-to-Theory Induction Benchmark)。在图像编辑任务中,即便某些操作(如旋转+遮罩)在训练集中从未同时出现,NEO 也能通过组合已学到的“旋转”和“遮罩”原语来通过测试。
关键结果分析
- 组合 OOD (Out-of-Distribution):在 α=0.33(极其稀疏的训练数据)下,NEO 的表现依然远超 Continuous Monolithic 模型。
- 长度泛化:NEO 可以生成比训练时更长的程序序列。
- 测试时缩放 (Test-time Scaling):通过增加采样预算并进行多数投票,NEO 的泛化准确率呈现出类似大模型的 Scaling Law 增长。
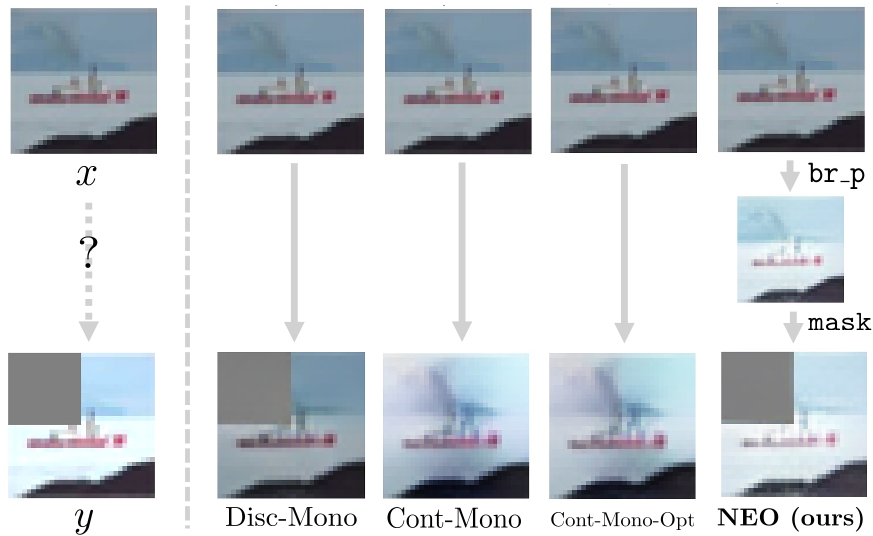 图 4:图像编辑任务的可视化。NEO 能够将其解释为“亮度增加”后跟“遮罩”的序列,而基线模型只能得到模糊的预测。
深度洞察
NEO 的真正价值在于它对 Inductive Bias 的重新利用。它通过离散符号化程序为神经网络重新引入了逻辑结构。
局限性考察:
- 确定性假设:目前主要针对确定性动态,面对随机性(Stochastic)世界仍需扩展。
- 计算开销:由于需要顺序执行 步,其推理成本高于单向预测模型。
总结
NEO 代表了从“拟合曲线”向“发现规律”的跃迁。这种从原始观测中自动诱导显式理论的能力,是通往 AGI 认知架构的重要一步。未来的世界模型可能不再仅仅是庞大的扩散投影仪,而是一个能够自我编程、自我修正的逻辑系统。