
RLA-WM:通过残差潜动作突破视觉特征世界模型的瓶颈
Learning Visual Feature-Based World Models via Residual Latent Action
本文提出了 RLA-WM,一种基于视觉特征的世界模型,通过学习 DINO 特征残差的压缩表示——剩余潜动作(Residual Latent Action, RLA),实现了高效且精确的未来状态预测。该方法在 ManiSkill 和 IWS 机器人操纵数据集上显著超越了现有的特征回归模型和视频扩散模型(Video Diffusion)。
TL;DR
本文介绍了一种新型视觉特征世界模型 RLA-WM。它不直接生成像素,也不盲目回归高维特征,而是通过一种名为 Residual Latent Action (RLA) 的紧凑表示来捕捉物理世界的演变。RLA-WM 在保持极高推理效率的同时,解决了长时预测中的“模糊”与“幻觉”问题,甚至支持在纯虚拟的环境中进行机器人强化学习(Visual RL)。
背景:像素与特征的博弈
构建机器人世界模型时,研究者通常在两条路之间选择:
- 视频生成派:如 GAIA-1 或 UniSim。视觉效果惊艳,但计算成本极高,且容易在细节处产生物理上不可能的“幻觉”。
- 视觉特征派:如 DINO-WM。预测语义特征(DINO tokens)而非像素。这类模型效率极高,但以往采用的简单 直接回归 (Direct Regression) 在处理复杂的 3D 操纵任务时,往往会因为多峰分布导致预测结果“向均值回归”,变得模糊不清。
作者指出一个关键痛点:DINOv3-L 特征的维度高达 100 万维,比 Stable Diffusion 的 VAE 潜空间大两个数量级。在这种量级下直接进行扩散建模(Diffusion)是极其困难的。
核心直觉:物理演变的本质是“残差”
作者认为,虽然视觉特征空间维度极高,但有效的物理运动流形(Manifold)其实是低维的。基于这一 Insight,他们提出了 Residual Latent Action (RLA)。
什么是 RLA?
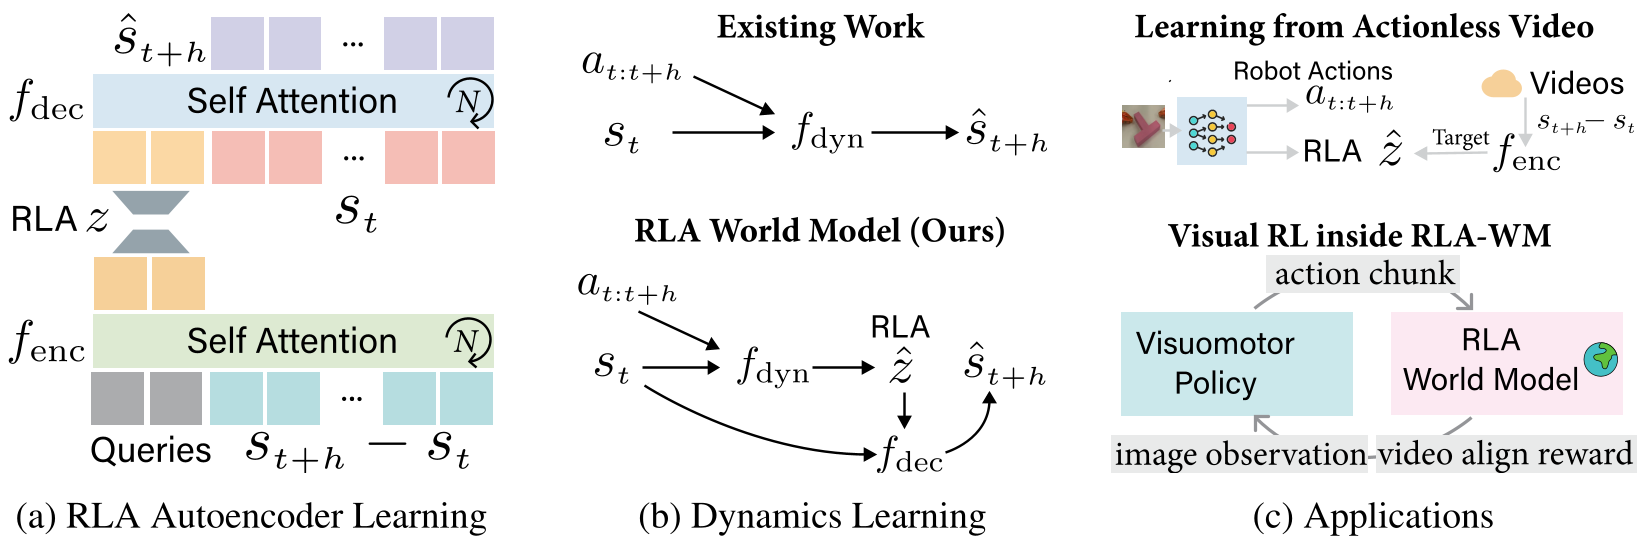
RLA 通过一个简单的 Autoencoder 学习:它编码的是 和 两个时间点 DINO 特征的残差 (Residual)。
- 架构直觉:编码器 将特征变化压缩进一个紧凑的潜向量 。
- 惊人特性:RLA 不仅具有足够的预测性(单次解码即可恢复高质量特征),还展现出了时间拓扑性——在噪声和 RLA 之间进行线性插值,竟然能解码出中间时间步的状态。
RLA-WM:在紧凑空间中“舞蹈”
RLA-WM 的工作流程非常优雅:
- 条件注入:将当前状态 和机器人动作序列 输入条件网络。
- 流匹配预测:在低维、紧凑的 RLA 空间中执行 Flow Matching,预测出对应的 。
- 瞬间生成:利用训练好的解码器 ,结合 和预测出的 ,一步生成未来特征 。
这种设计让生成过程保留在低维空间(效率高),而最终输出则通过残差连接保证了物理一致性(精度高)。
实验结果:降维打击
在与 SOTA 模型 Vid2World(参数量 1.1B 的视频扩散模型)对比时,RLA-WM 在 ManiSkill 任务中不仅预测更准确,且计算开销仅为其千分之一(3.5T vs 1.1P FLOPs)。
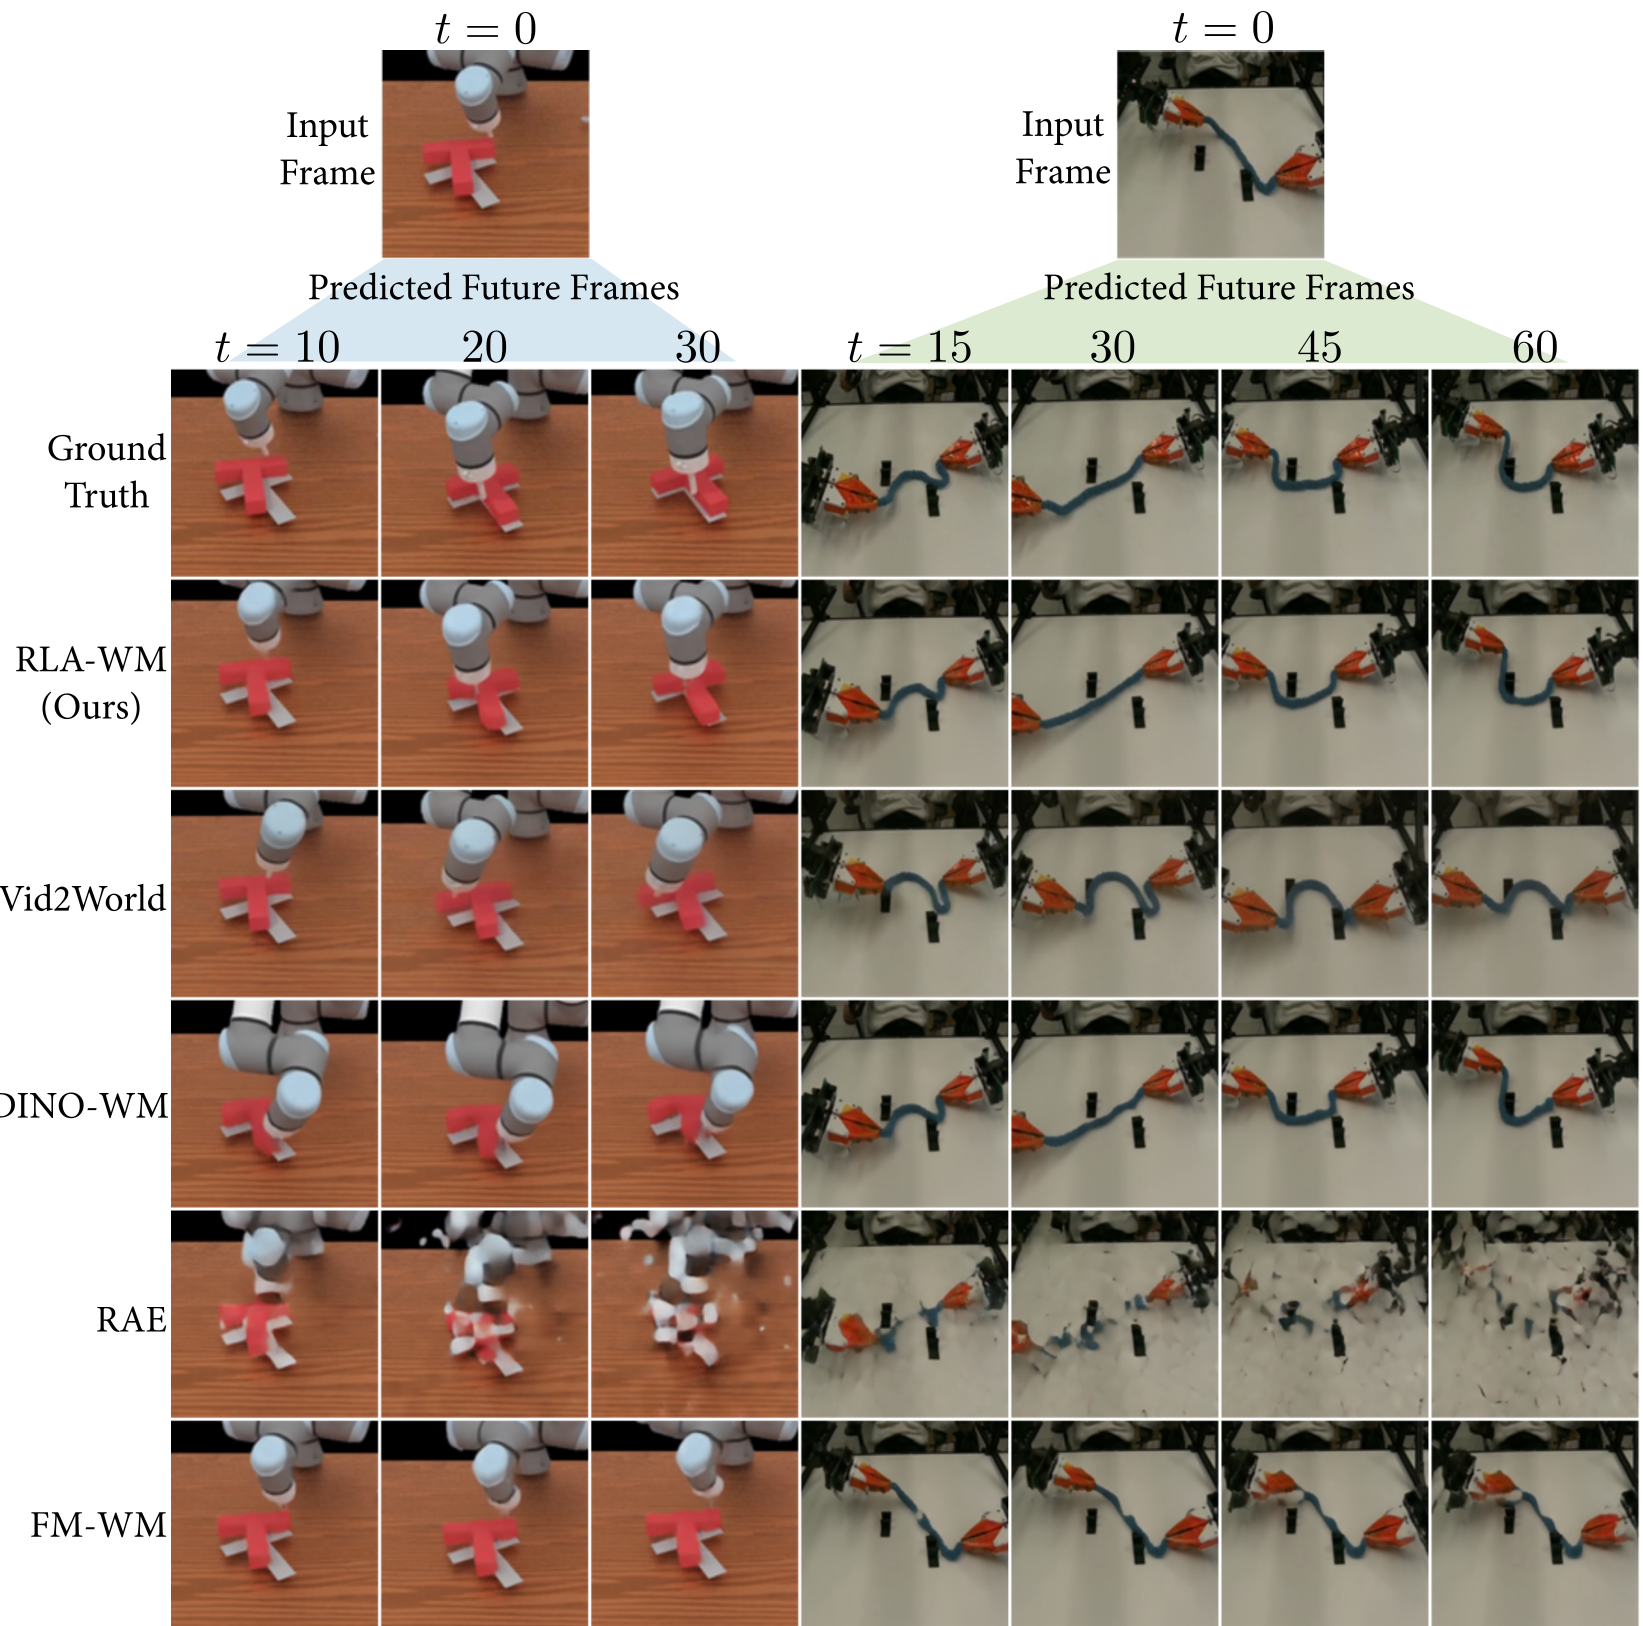
从对比图中可以清晰看到:
- DINO-WM 在长时序列中迅速变得模糊。
- Vid2World 虽然画面清晰,但其预测的物体运动完全偏离了物理真实。
- RLA-WM 则在视觉清晰度和物理真实感之间达成了极佳的平衡。
进阶应用:纯虚拟世界的强化学习
本文最令人兴奋的贡献之一是 WMRL (World Model-based RL)。作者展示了如何完全在 RLA-WM 内部进行策略训练:
- 使用 DINO 特征空间的 L1 距离作为 视频对齐奖励 (Video Aligned Reward, VAR),无需手动编写复杂的 Reward 函数。
- 由于 RLA-WM 推理极快,策略可以在虚拟想象中进行海量试错。
- 战绩:在 XArm 和 UR10e 机器人上,经过虚拟 RL 训练后的策略性能显著优于单纯的模仿学习(BC)。
总结与价值
RLA-WM 展示了“残差学习”在具身智能领域的强大生命力。通过将生成挑战转移到低维残差动作空间,它打破了视觉世界模型在“效率”与“准确性”之间的零和博弈。
局限性分析:目前 RLA 依赖于成对帧的对比,对于背景大幅度晃动(如第一人称视角)或长时间遮挡(Partial Observability)的场景,仍需进一步引入时序记忆模块(如 Transformer 或架构扩展)。
未来展望:随着 RLA-WM 走向互联网级数据规模,我们有望看到一个真正能让机器人“闭眼排练”的通用模拟器。