
优化理论深度讲义:从梯度流直觉到现代算法的数学底座
Lectures on optimization
本文是关于高级优化技术的系统性讲义稿,涵盖了从凸分析基础到现代前沿算法(如加速梯度法、镜像下降、方差缩减及内点法)的理论体系。重点分析了不同 Oracle 模型下的查询复杂度下界,并详细推导了达到这些下界的 SOTA 算法。
TL;DR
本讲义系统性地梳理了现代优化理论的核心脉络:通过 Oracle 模型 定义原子的查询复杂度,利用 Bregman Divergence 重新度量空间几何,并揭示了 Acceleration(加速现象) 的物理直觉与离散化坑点。讲义不仅涵盖了经典的凸优化,还深入探讨了随机优化中的统计泛化性能及大规模计算下的方差缩减技术。
1. 痛点:为什么 Black-box 优化如此之难?
在优化算法的“身份证明”中,Complexity(复杂度)是核心。讲义指出,若仅假设 Lipschitz 连续性,找寻 ε-近似解的复杂度将随维度 d 指数级增长。
- 直觉陷阱:局部信息(梯度)并不总能给出全局指导。
- 破局关键:Convexity (凸性)。它是将“局部下降”转化为“全局收敛”的唯一合法凭证。
2. 动力学直觉:梯度流 (Gradient Flow)
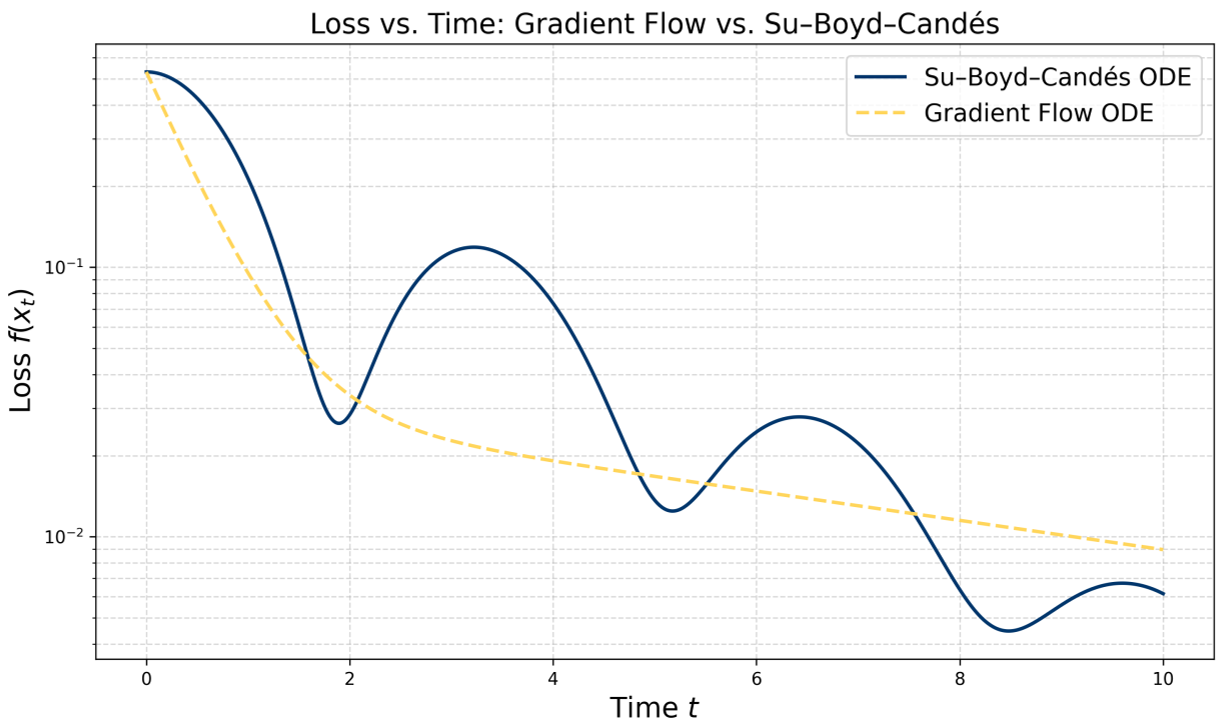
作者首先在连续时间域建立了物理直觉。所有的加速算法都可以看作是某种带有“摩擦力”和“势能”的动力学系统。
- GF (Gradient Flow):。
- AGF (Accelerated Gradient Flow):引入了动量项。
有趣的是,讲义展示了加速梯度流在强凸下并非单调下降,这种“振荡”特性解释了为什么需要特殊的 Lyapunov 函数 来证明收敛性,而不是简单的 Descent Lemma。
3. 核心机制:Mirror Descent 与空间几何
传统的梯度下降假设由于欧几里得范数的“自对偶性”,梯度与点属于同一空间。但面对单纯形 (Simplex) 等非对称约束时,这种假设失效了。讲义引出了 Mirror Map (镜像映射):
- 通过 将点映射到对偶空间(梯度空间)。
- 在对偶空间执行梯度步。
- 利用对偶映射 返回原空间。
这种转换通过 Bregman Divergence 实现了对算法进度的精准度量。在最优传输 (Optimal Transport) 的案例中,Sinkhorn 算法被巧妙地证明为熵镜像下降的实例,其复杂度直接与 KL 散度下降挂钩。
4. 走向大规模:随机优化与方差缩减 (SVRG)
在 empirical risk minimization 任务中,n 个样本的全梯度计算代价巨大。随机梯度 (SGD) 虽然单步快,但 variance (方差) 导致收敛停滞。
- SVRG 的妙招:引入定期计算的全梯度作为锚点,通过公式 实现零偏估计且方差随迭代趋于零。
下表对比了不同算法在有限和设置下的梯度评估复杂度:
| Algorithm | Iterations (Convex) | Iterations (Strongly Convex) |
|---|---|---|
| SGD | ||
| GD | ||
| SVRG |
5. 高阶武器:内点法 (Interior Point Methods)
为了解决 LP 或 SDP,内点法引入了 Self-concordant Barrier (自共轭障碍)。其核心在于控制 Hessian 矩阵的变化率,使得 Newton 法在整个迭代路径(Central Path)上保持二阶收敛。
- Barrier Calculus:讲义推导了 项如何通过线性组合构建复杂的障碍函数。
- 核心结论:迭代次数仅需 次,其中 是障碍参数。这意味着我们可以以极高的精度解出最优化问题。
6. 批判性洞察:理论与实践的鸿沟
虽然讲义证明了 ASVRG 是“理论最优”的,但在深度学习实践中,SGD 往往因为噪声带来的 Inductive Bias 而表现出更强的泛化能力。
- 局限性:下界证明多基于 Gradient Span 假设,但在高度过参数化 (Overparameterized) 的神经网络中,PL 条件或中轴路径的理论可能需要重写。
- 未来展望:Hessian 几何与参数间曲率的自适应耦合将是下一代二阶优化器的突破点。
作者总结:优化不仅是找最小值,更是理解目标函数背后的几何纹理。从 GF 到镜像映射,数学美感在于将复杂的约束化为优美的动力学轨迹。