
让 ViT 直接开口说话:GenLIP 开启极简生成式预训练新范式
Let ViT Speak: Generative Language-Image Pre-training
本文提出了 GenLIP,一个极简的生成式图文预训练框架,旨在为多模态大语言模型(MLLMs)提供强大的视觉编码器。该方法直接利用单个 Vision Transformer (ViT) 通过标准的自回归语言建模目标(Next Token Prediction)预测文本,无需对比学习。
TL;DR
传统的视觉编码器预训练要么依赖对比学习(如 CLIP),存在目标不匹配;要么依赖复杂的编码器-解码器架构(如 CapPa),优化路径间接。GenLIP (Generative Language-Image Pre-training) 彻底打破了这种繁琐,它只用一个标准的 Vision Transformer (ViT) 和最基础的自回归语言建模损失,让视觉编码器学会“直接说话”。仅需 8.0B 样本,它就在 OCR 和多模态理解任务上全面超越了训练数据量大 5 倍的 SigLIP2。
1. 回归常识:为什么对比学习不是视觉对齐的终点?
当前多模态大模型(MLLM)的架构通常是“视觉编码器 + 连接器 + LLM”。这里存在一个隐形的目标不匹配 (Objective Mismatch):
- 视觉编码器多是用 CLIP 这种“判别式”方法训练的,强调全局语义对齐。
- 下游 LLM 的工作方式是“生成式”的,即 Next Token Prediction。
作者认为,最直接的解决方案就是让视觉编码器在预训练阶段就以生成式的方式运行。然而,前人为了实现这一点,往往会额外挂载一个庞大的文本解码器,这增加了训练成本,也稀释了视觉特征的纯粹性。
2. 核心架构:化繁为简的艺术
GenLIP 的核心思想极其暴力美学:把图像 patch 当成文本的“前缀 (Prefix)”,全部塞进同一个 Transformer。
2.1 极简数据流
输入序列 ,其中 是图像 patch, 是文本 token。模型的目标是:给定图像及其之前的文本,预测下一个文本 token。
2.2 两项关键改进
为了让标准的 ViT 能处理这种混合任务,作者做了微小但致命的技术优化:
- Prefix-LM Attention:图像 patch 之间采用双向注意力(Bi-directional),使视觉信息充分交互;文本部分采用因果注意力(Causal),符合生成逻辑。
- MRoPE (Multimodal Rotary Position Encoding):引入旋转位置编码以更好地处理混合序列的位置关系。
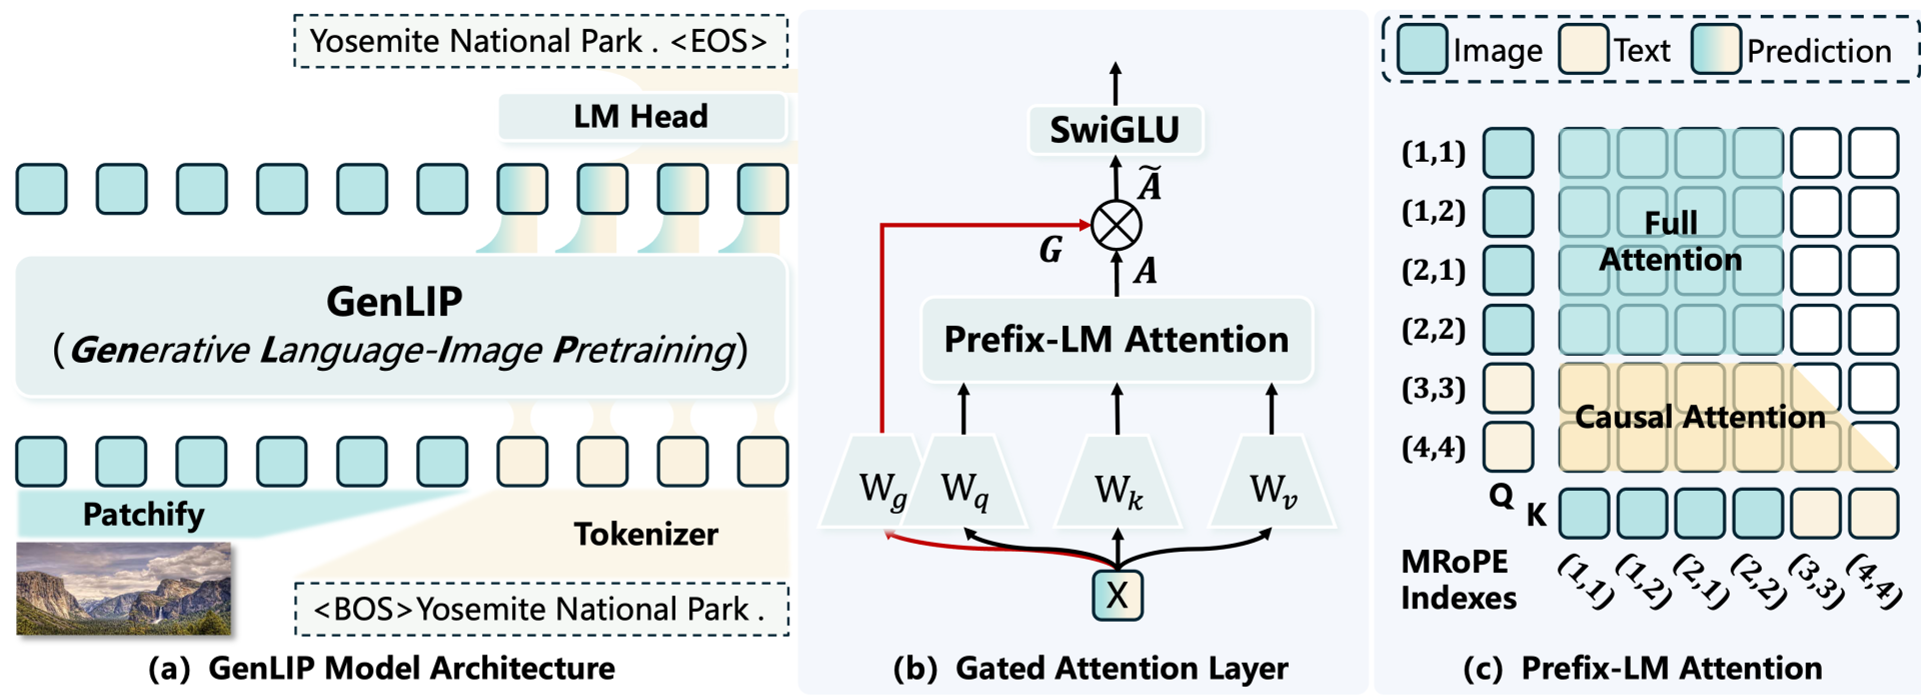 图 1:GenLIP 统一架构,通过 Gated Attention 调节信息流
3. 攻克 Attention Sink:门控注意力机制
在实验过程中,作者发现一个严重的副作用:Attention Sink (注意力陷阱)。 由于所有文本 token 只能通过因果注意力看到前面的图像 patch,模型为了偷懒,会倾向于把所有视觉信息压缩到第一个起始 token () 中。这会导致视觉表示的“空间多样性”丧失,让 ViT 失去了捕捉图像细节的能力。
解决方案:Gated Attention 作者在注意力层引入了一个简单的门控机制: 通过对 token 进行逐位的门控调节,强制模型利用分布式的空间特征,而不是全部坍缩到一个点上。这一改进不仅稳定了训练,还显著提升了判别任务(如 ImageNet 分类)的表现。
4. 实验战绩:以少胜多的数据效率
4.1 OCR 与文档理解的统治力
在 OCRBench 和 ChartQA 等极其考验细节的任务上,GenLIP 展现了惊人的统治力。即使在“冻结视觉特征”的情境下,其表现依然大幅领先 SigLIP2,这说明其学到的视觉表征本身就更具有文本感知力。
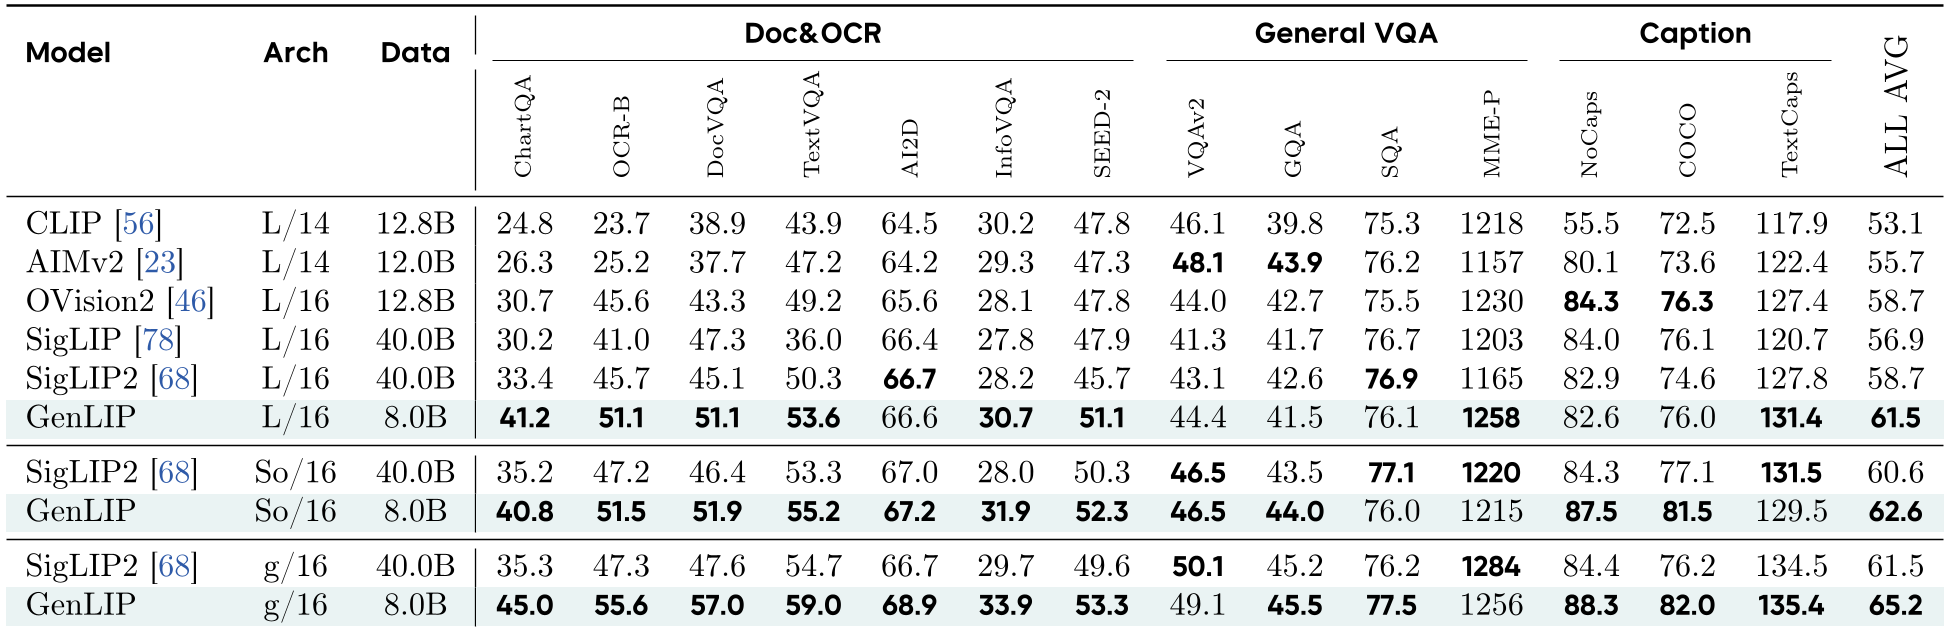 表 1:跨任务性能评估,GenLIP 在各项平均分(ALL AVG)上持续领先
4.2 “让 ViT 说话”
如果你直接在 ViT 的最后一个层挂上 LM Head,你会发现有趣的现象:GenLIP 能够自发地将特定的图像像素区域对齐到文本语义。例如,看到“皮卡丘”的 patch,它能直接 readout 出相关文本 token。
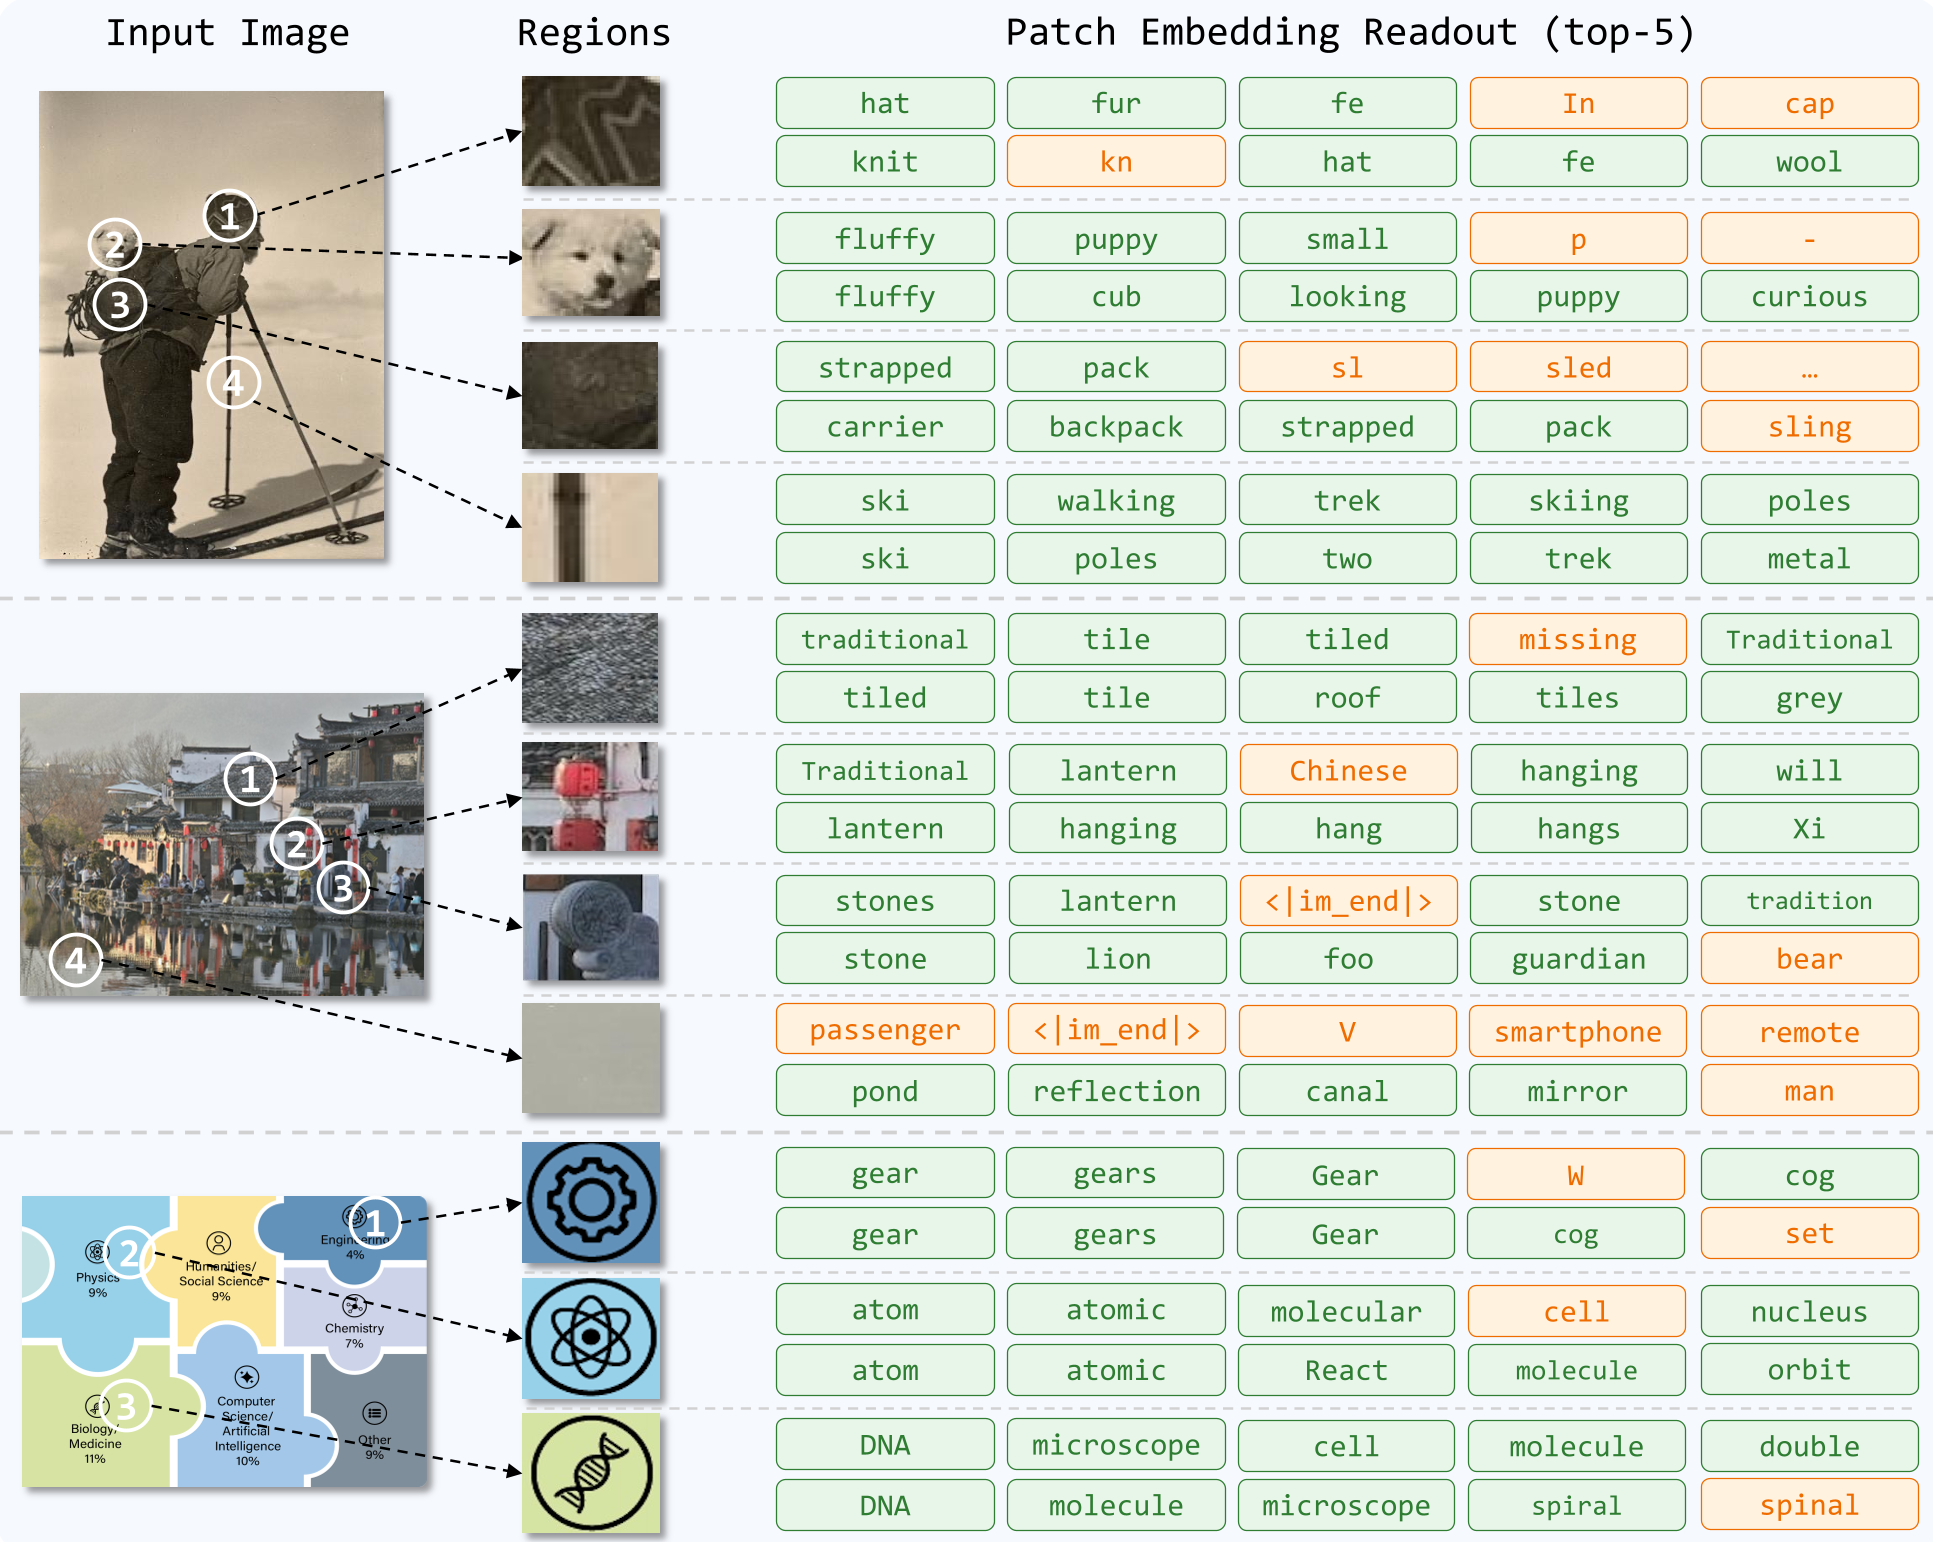 图 2:局部 Patch 的语义读取结果,展示了强大的零样本对齐能力
5. 总结与洞察
GenLIP 的成功对未来的 MLLM 研究有两个重要启示:
- 架构对齐优于损失函数对齐:与其在损失函数(Loss Function)上修修补补,不如让视觉编码器在架构和输入模式上就与下游 LLM 保持高度的一致性。
- 生成式目标的优越性:对于视觉理解而言,生成任务比判别任务更难,也因此能逼迫模型学到更致密、更细粒度的特征,尤其是在 OCR 这种高精尖场景下。
局限性:GenLIP 依然高度依赖高质量的图片描述(Recaptioning)数据。如何低成本获取海量的精细描述文本,仍是该路线未来规模化(Scaling up)的首要瓶颈。
结论:GenLIP 是一个极简主义的胜利,它证明了在多模态的世界里,最直接的路径往往也是最有效的。