
LIVEditor:突破 ICL 视频编辑瓶颈,实现近无损的 60% 推理加速
Lightning Unified Video Editing via In-Context Sparse Attention
本文提出了 LIVEditor,一个基于 In-Context Learning (ICL) 的统一视频编辑框架,并引入了 In-context Sparse Attention (ISA) 机制。ISA 通过预选择显著上下文令牌和基于 Query 尖锐度(Sharpness)的动态分组计算,在保持几乎无损的编辑质量的同时,将注意力模块延迟降低了约 60%。
TL;DR
视频编辑正在步入 In-Context Learning (ICL) 时代,通过简单的视频拼接实现强大的编辑能力。然而,翻倍的序列长度带来了沉重的计算负担。本文提出的 LIVEditor 引入了 In-context Sparse Attention (ISA) 机制,利用上下文令牌的低显著性和 Query 尖锐度启发式,在 EditVerseBench 等基准上刷新了 SOTA 记录,同时显著降低了延迟。
背景定位
在当前的学术坐标系中,视频编辑已从早期的特定领域模型过渡到如 Wan 2.1 这样的统一生成框架。ISA 并非简单的剪枝,它是一套针对 ICL 模式量身定做的硬件友好型稀疏化方案,属于模型推理加速与算法优化的前沿交叉成果。
痛点深挖:为什么 ICL 视频编辑这么慢?
在 ICL 范式下,模型需要同时处理“参考视频(Context)”和“待生成的视频(Source)”。
- 计算复杂度爆炸:序列长度翻倍意味着 Attention 的计算量翻了四倍。
- 盲目稀疏化:现有的稀疏注意力(如 Radial Attention)没有区分 Context 和 Source。作者发现,Context 令牌在深层网络中的 Saliency(显著性)远低于 Source,这意味着大量的计算在处理“冗余背景信息”。
核心机制:ISA (In-context Sparse Attention) 详解
1. 预选择 (Pre-Selection) 策略
作者通过可视化发现,Attention 矩阵中 Source-to-Source 的分数远高于 Source-to-Context。ISA 首先通过一个轻量级的池化操作(Pooling Attention)评估 Context 块的重要性,直接剔除掉那些对生成贡献微乎其微的令牌。
2. 基于分数的动态路由 (Grouped Computation)
这是本文最具学术深度的地方。作者在理论上证明了 Query Sharpness(尖锐度) 与 0 阶泰勒展开近似误差 之间的正相关性。
- 高尖锐度 Query:意味着分布集中,近似误差大,必须使用 Full Attention 以保留精细特征。
- 低尖锐度 Query:分布平缓,使用 0 阶泰勒稀疏注意力 进行近似,计算复杂度从 直接降至 。
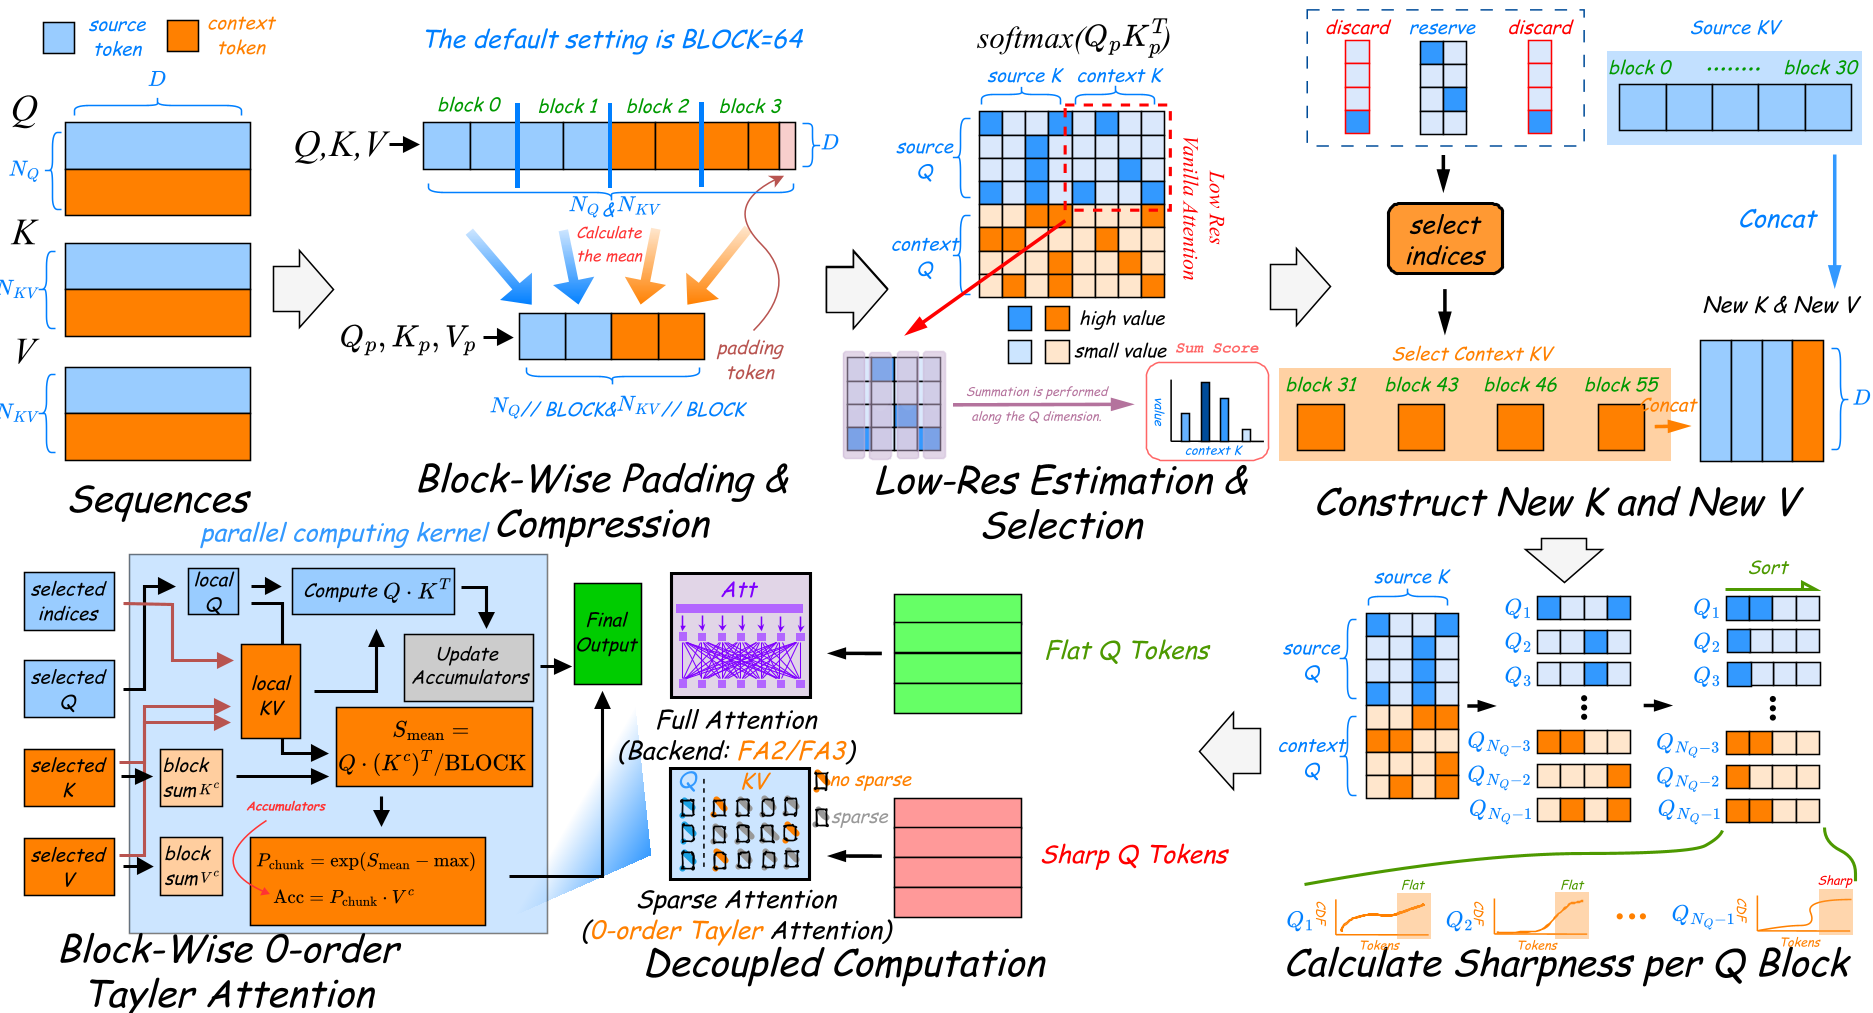 图 1:ISA 工作流,展示了从预选择到 Query 分组分发的全过程。
实验与结果对比
1. 性能全线超越
在针对视频编辑的权威榜单 EditVerseBench 上,LIVEditor (ISA) 在质量、文本一致性、时间连贯性等方面均位列榜首,甚至在部分指标上超过了全注意力版本。作者认为,这是因为 ISA 的剪枝机制起到了类似于“去噪”的作用,过滤了无关噪声令牌的干扰。
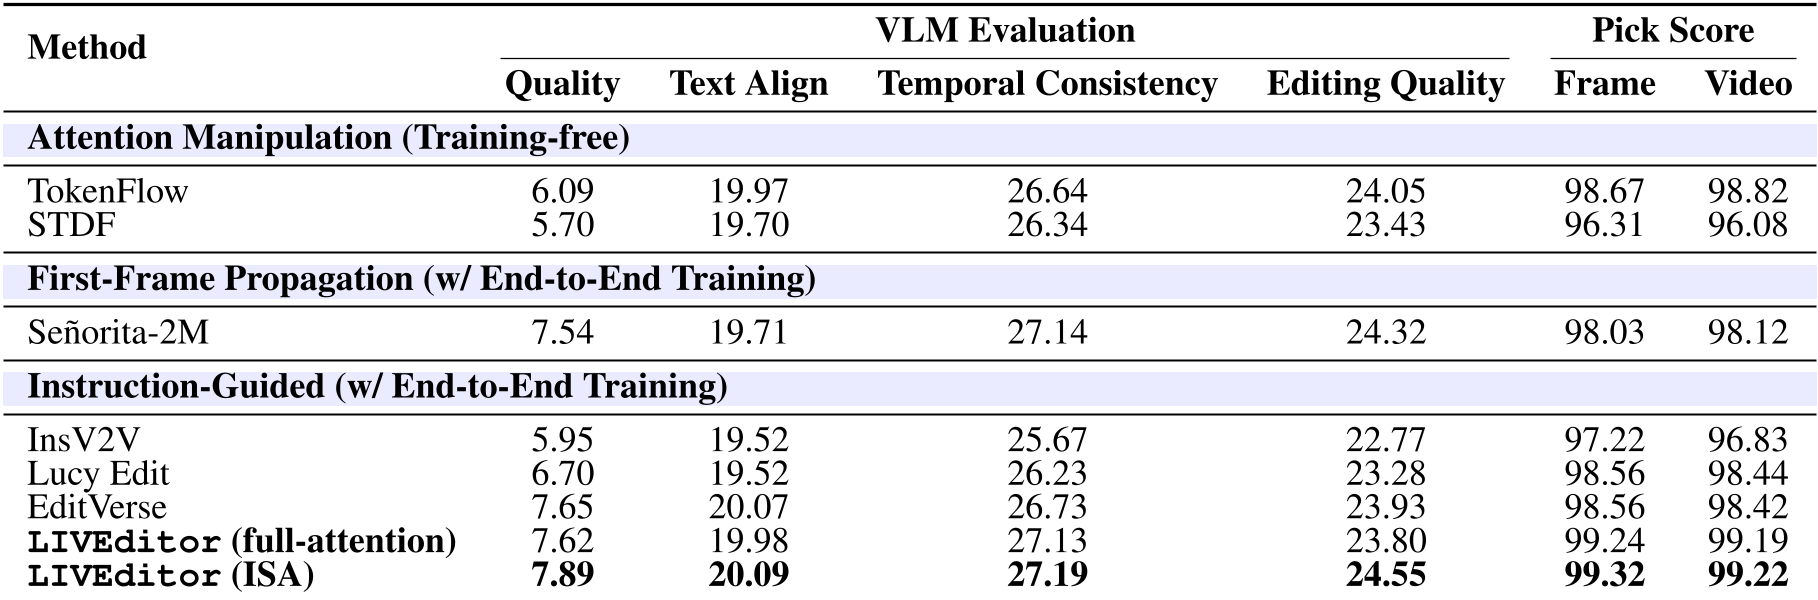 表 1:LIVEditor 与 TokenFlow, InsV2V 等 SOTA 方法的量化对比。
2. 极致的加速效果
随着序列长度从 5K 增加到 50K,ISA 的加速效果呈线性增长趋势。相比于标准的 FlashAttention-2 方案,ISA 能够将注意力模块的延迟降低约 60%。
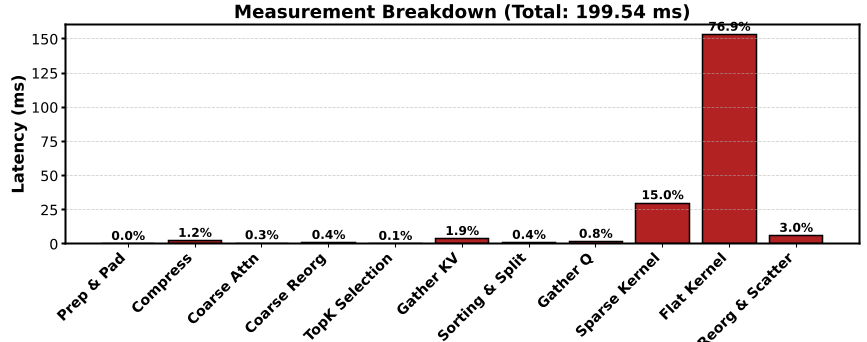 图 2:ISA 随序列长度增加展现出的加速比优势。
深度洞察与总结
Takeaway: LIVEditor 的成功不仅仅在于算法的精巧,更在于它对 ICL 任务物理直觉的精准把握——即并不是所有的输入信息都配享有同样的计算力。
局限性与展望: 虽然 ISA 实现了近乎无损的加速,但在极端复杂的动态场景下,Query Sharpness 阈值的动态调整仍有优化空间。未来,这种基于任务语义的动态稀疏化思路,有望扩展到超长视频生成、多模态对话等更广泛的领域。
结论: LIVEditor 为长视频编辑任务提供了一个高效、统一且鲁棒的范式。通过 1.7M 高质量数据集的注入与 ISA 机制的加持,视频编辑的“闪电级”体验已然成真。