
WeightFormer:摆脱显式注意力,用动态参数重构全局建模
Linear-Time Global Visual Modeling without Explicit Attention
本文提出了 WeightFormer,这是一种旨在取代 Transformer 中显式注意力机制的线性复杂度架构。该工作将注意力机制重新解释为一种具有动态参数预测能力的多层感知机(Dynamic MLP),并证明了通过动态权重生成即可实现 SOTA 级别的全局建模能力。
TL;DR
清华大学的研究团队在论文《Linear-Time Global Visual Modeling without Explicit Attention》中提出了一个革命性的观点:注意力机制的本质并非显式的 Token 聚合,而是一个以输入为条件的动态 MLP。 基于此,他们设计了 WeightFormer,通过动态预测线性层和卷积层的权重,在保持线性计算复杂度的同时,实现了超越 Vision Transformer (ViT) 的全局建模能力。
1. 范式转移:注意力其实是动态 MLP?
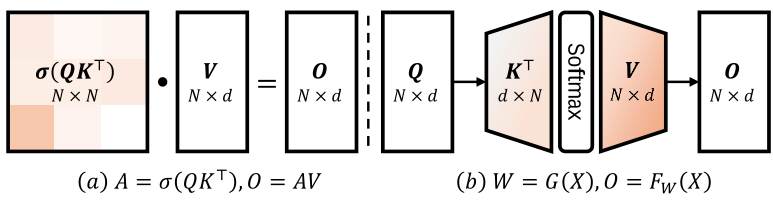
长期以来,学术界认为 Transformer 的成功在于 带来的 Token 间两两交互。但这篇论文提出了一个极具启发性的视角转换(如图 2 所示):
- 将输入 视为 MLP 的输入。
- 将 视为第一层线性权重的动态生成结果。
- 将 视为非线性激活函数。
- 将 视为第二层线性权重的动态生成结果。
在这个视角下,全局上下文其实是被“压缩”进了动态生成的权重中。既然如此,我们是否可以直接预测权重,而完全不需要计算昂贵的 注意力矩阵?
2. 核心架构:WeightFormer 的动态权重生成
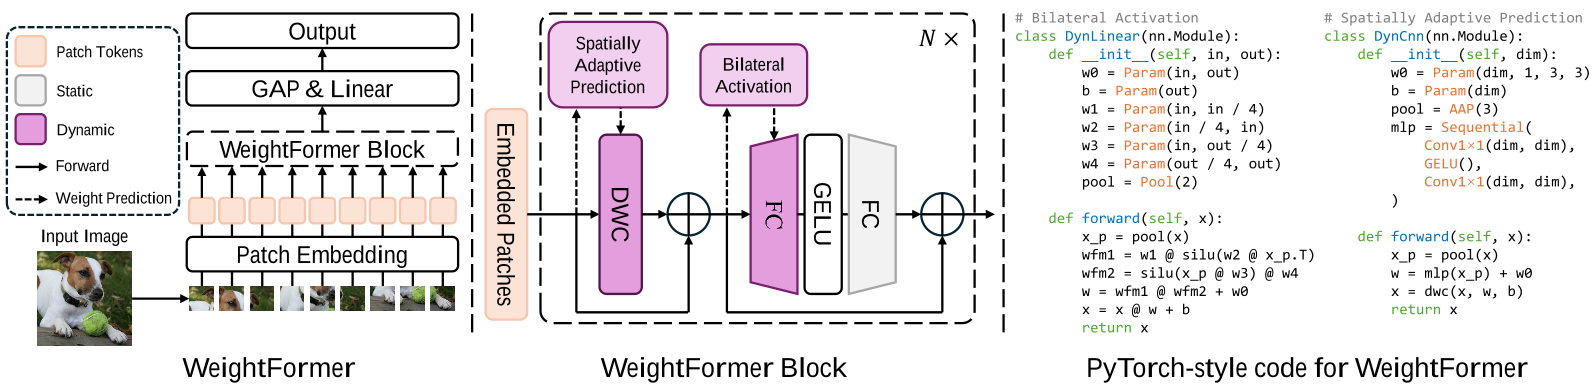
为了验证这一假设,作者设计了两种核心的动态更新策略,取代了传统的自注意力层:
2.1 动态线性层与“双边激活”
普通的线性层只能做通道混合,无法处理空间依赖。WeightFormer 通过输入 动态生成偏移量 。其中效果最好的是 Bilateral Activation(双边激活) 策略: 这种方式利用了 的二阶关联信息,捕捉更高阶的特征交互,同时确保复杂度与 (Token 数量)成线性关系。
2.2 动态深度卷积 (Dynamic DWC)
为了引入空间感应偏置(Inductive Bias),WeightFormer 动态生成深度卷积核。作者发现 Spatially Adaptive(空间自适应) 预测效果最均衡:通过将输入特征图池化到固定的 大小,再映射为卷积核参数,从而让卷积核具备了随输入变化的“全局视野”。
3. 实验结果:线性复杂度的降维打击
3.1 惊人的高分辨率表现
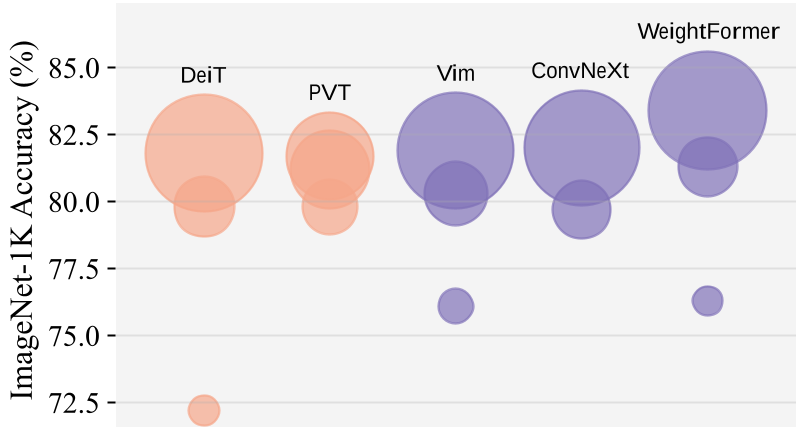
在处理超高分辨率图像(如 1248x1248)时,传统 Transformer 的内存占用会呈几何倍数爆炸,而 WeightFormer 展现了极强的线性扩展性。相比 DeiT,它实现了 91% 的显存精简 和 7.7 倍的吞吐量提升。
3.2 真正实现了“全局感受野”
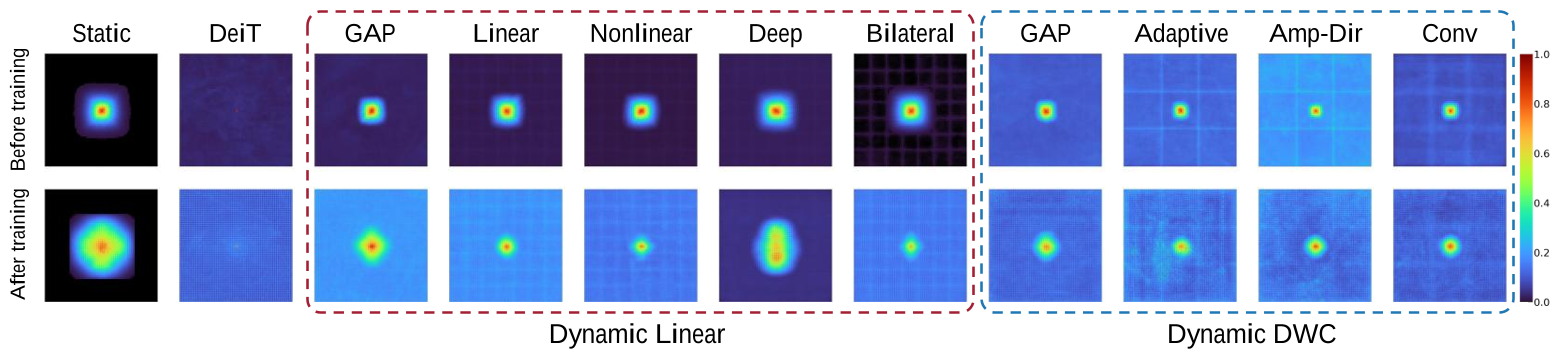
通过对有效感受野 (ERF) 的可视化分析发现,尽管 WeightFormer 没有使用注意力矩阵,但由于其权重是根据全局上下文动态生成的,模型依然能够像 Transformer 一样感知到图像的每一个角落(见图 3)。
4. 深度洞察与总结
WeightFormer 的成功证明了:显式的点对点注意力(Explicit Token-wise Aggregation)并非实现全局建模的唯一路径。
- 优点:计算效率极高,对长序列极其友好,在图像检测、分割、甚至扩散模型(Diffusion Models)生成任务中都有出色表现。
- 局限性:目前研究主要集中在视觉领域,在 NLP 超大模型上的泛化性以及训练稳定性(动态权重带来的梯度流动挑战)仍需进一步探索。
这项研究为后 Transformer 时代的架构设计提供了新的思路:也许未来我们不需要更复杂的 Attention 变体,而只需要更巧妙的参数生成器。
作者总结:全局建模实际上是动态参数化的副产品。WeightFormer 不仅仅是一个模型,它更像是一个宣言——线性复杂度的全局建模不仅可行,而且在工程实践中极具竞争力。