
T5:突破二次复杂度堡垒,1小时将预训练模型转化为线性效率架构
Linearizing Vision Transformer with Test-Time Training
本文提出了 T5 (Transformer To Test-Time Training) 架构,旨在将预训练的 Softmax Attention 模型无损、高效地线性化。通过引入测试时训练 (TTT) 机制替代注意力层,该方法在 Stable Diffusion 3.5 上仅需 1 小时微调即可实现 1.32x 至 1.47x 的推理加速,同时保持 SOTA 级别的生成质量。
TL;DR
随着生成式 AI 迈向超高分辨率(4K/8K)和超长上下文,Transformer 原生的 Softmax Attention 因为 的复杂度成为了不可逾越的鸿沟。清华大学等团队提出的 T5 (Transformer To Test-Time Training) 框架,通过将注意力机制重构为动态的“测试时训练”层,实现了对预训练权重的全量继承。在 Stable Diffusion 3.5 上,仅需 1 小时微调,即可在保持画质的同时,实现最高 1.47 倍的推理加速。
痛点深挖:为什么线性化 Transformer 这么难?
此前,业界尝试过多种“线性化”手段(如 Linear Attention 或将模型蒸馏到 Mamba 等架构),但效果往往不尽人意。其核心逻辑缺陷在于:
- 结构不兼容:Softmax Attention 本质上是一个“两层动态 MLP”,具有中间非线性激活。而大多数线性注意力只是一个单层的线性映射,这就像是用平房去强行模拟摩天大楼。
- 分布偏移:由于 Softmax 具有偏移不变性(Shift-Invariance),预训练模型中的 Key 向量通常带有巨大的偏置(Bias),一旦强行切换到不支持该特性的线性算子,模型会瞬间发生数值爆炸(NaN)。
核心方案:TTT 架构的“降维打击”
作者认为,解决线性化的关键不在于去强行“拟合” Softmax 函数,而在于寻找一个结构对齐的替代者。他们选定了 Test-Time Training (TTT)。
1. 架构对齐:两层 MLP 的天然同构
TTT 将序列建模看作一个在线学习问题:隐藏状态不再是静态的缓存(KV Cache),而是一个不断更新权重的内部模型 。
作者发现:
- Softmax Attention:。
- TTT Layer:其计算过程可以写成 。
这种结构上的相似性(如图 2 所示)使得 TTT 可以直接继承预训练的 Q、K、V 投影权重,从而绕过了从头开始训练的巨额成本。
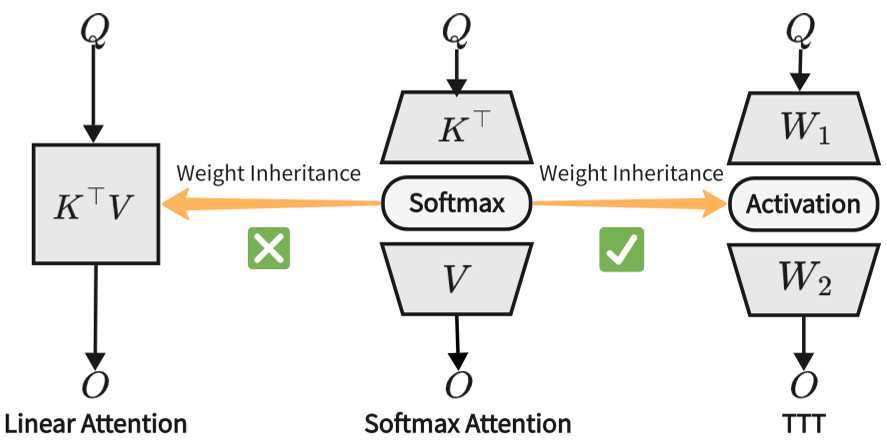 图 2:Softmax Attention 与 TTT 结构的高度同构性是实现权重继承的基础
2. 表示对齐:消除 Key 的“偏移诅咒”
针对数值不稳定的问题,研究者通过实证发现预训练 ViT 的 Key 偏移率高达 0.5(如图 3 下部)。
- 解决方案:引入 Key Instance Normalization。通过在序列维度上对 Key 进行中心化处理,强行模拟出 Softmax 的偏移不变功能,从而确保了微调过程的稳定。
- 局部性增强:通过在 Q 和 K 上加入轻量级的深度卷积(DWC),补齐了线性模型在处理局部纹理时感知力不足的短板。
实验战绩:1小时微调的奇迹
该方法在多种任务中展现了极其恐怖的适配速度:
- Stable Diffusion 3.5-Medium:仅在 4 张 H20 GPU 上运行 1 小时(3000 步),生成的图像质量便恢复至原生水平,甚至在某些评估指标(GenEval)上有所超越。
- 计算效率:在处理 2048 高分辨率图像时,T5 将延迟从 231.5s 压缩到了 157.1s。
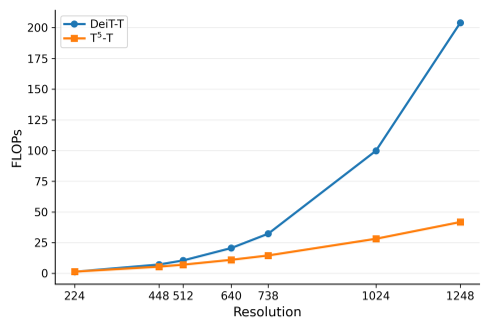 图 5:随着分辨率提升,T5 的 FLOPs 增长远低于原生 Transformer(左图:DeiT,右图:DiT)
深度洞察:架构演进的新范式
T5 的成功标志着“模型架构迁移”进入了新阶段。过去我们认为从 Transformer 迁移到更高效的架构必然伴随着巨大的性能损失或重新训练成本,但 T5 告诉我们:只要物理结构对齐、数学性质补偿做得足够到位,即使是数亿参数的模型也能在短短一小时内完成高效架构的平滑更替。
局限性分析: 虽然 T5 解决了推理效率问题,但其 TTT 层在训练过程中的梯度计算开销(Inner Loop)依然存在,未来如何进一步优化训练时的显存占用将是该路线大规模普及的关键。
总结
T5 不仅仅是一个线性化工具,它更像是一种“算力释放器”。它让那些昂贵的预训练资产能够在不牺牲精度的情况下,无缝切换到线性复杂度的赛道上,为下一代超大规模多模态模型的高效推理铺平了道路。