
[arXiv 2026] LLaDA-TTS:统一合成与编辑,扩散模型突破自回归瓶颈
LLaDA-TTS: Unifying Speech Synthesis and Zero-Shot Editing via Masked Diffusion Modeling
LLaDA-TTS 是一种基于掩码离散扩散(Masked Diffusion)的语音合成系统。它通过将预训练的自回归(AR)语言模型转换为双向注意力架构,实现了固定步数的并行语音生成,在 Seed-TTS-Eval 测试集上达到 0.98% (zh) CER 的 SOTA 水平。
TL;DR
LLaDA-TTS 是一项突破性的工作,它通过**掩码离散扩散(Masked Discrete Diffusion)**重构了语音合成(TTS)的生成逻辑。它不仅保留了自回归(AR)模型卓越的自然度,还将推理成本从“随长度线性增长”解耦为“固定步数并行生成”,实现了 2 倍以上的速度提升,并顺带解决了复杂的零样本语音编辑难题。
背景定位:从“逐字念稿”到“全局构思”
传统的语音 LLM(如 VALL-E, Seed-TTS)本质上是在“逐词预测”。这种自回归方式虽好,但效率极低。LLaDA-TTS 的核心思路是:如果我们能让模型像填空一样,从满是 [MASK] 的背景中同时“变”出所有语音 token,效率会如何?作者不仅做到了这一点,还利用 Qwen2 的预训练权重,在极短的微调时间内完成了这一范式的转换。
痛点与动机:AR 模型的“沉没成本”
- 推理延迟:长句子的生成耗时不可控,尤其是对于实时交互场景。
- 编辑困境:如果你想改掉中间的一个词,自回归模型很难利用“后半句”的信息来保证衔接处的自然度。
作者的 Insight 非常深刻:语音信号具有物理上的局部相关性(ε-Forward Dependence)。即,当前的声音主要受过去影响,未来的声音提供的额外信息量是有限的。这意味着 AR 模型的参数天然包含了扩散模型所需的绝大部分信息。
方法论详解:如何“调教”一个 AR 模型?
1. 架构的华丽转身
作者保留了 Qwen2-0.5B 的骨架,但做了两个关键改动:
- 双向注意力:撕掉了 Causal Mask,让每个 token 都能看到上下文。
- 标签偏移(Label Shift):为了复用 AR 权重,隐藏层 依然负责预测位置 。
2. 掩码扩散目标
模型在训练时,会随机掩盖一定比例的语音 token,并使用 加权的交叉熵损失进行优化。这种加权方式的核心逻辑是:当剩下的空位越少( 越小),每个空位的重要性越高,模型越需要精准。

3. 数学直觉:Theorem 1
作者证明了一个非常优美的结论:在语音序列中,AR 预测器与理想的双向预测器之间的 KL 散度被 ε 限制。这从理论上解释了为什么只需 50 小时的微调,模型就能从 AR 状态平滑切换到扩散状态——因为它们在数学本质上是高度相近的。
实验与结果:速度与质量的双重获益
在 Seed-TTS-Eval 榜单上,LLaDA-TTS 展示了极强的竞争力:
- CER (zh):0.98%(优于 CosyVoice 3 的 1.21%)。
- 加速比:在 64 步下实现 2.0x 加速,而在 48 步时已能超越 AR 基线的音质,加速比达 2.6x(即便在没有 KV Cache 优化的前提下)。

意外惊喜:涌现的对齐能力
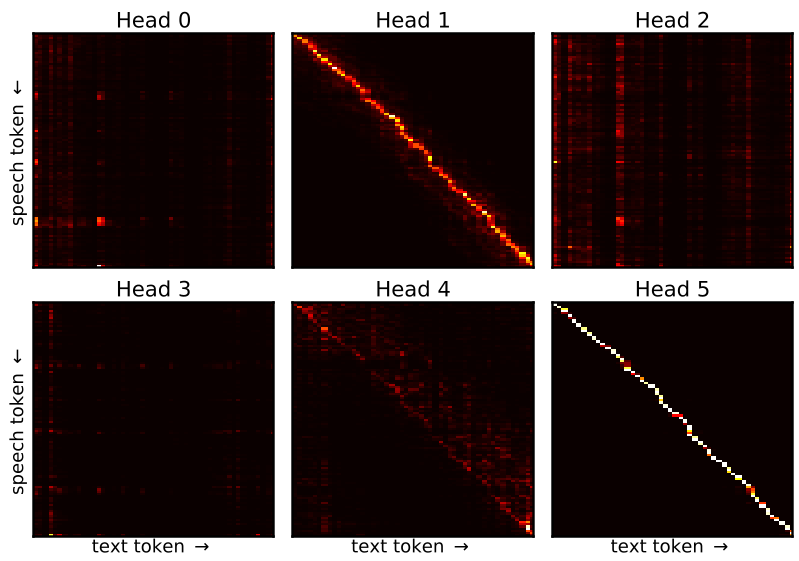
研究发现,在微调后,模型的特定注意力头(如第 11 层的第 1 和第 5 头)自发地学习到了单调对齐属性。这使得模型能够精准定位文本对应的语音区间,从而实现“选中即改”的零样本语音编辑。
深度洞察:一种普适的新范式
LLaDA-TTS 的成功不仅在于语音,它的方法论是通用的。任何基于 LLM 的自回归生成系统(VALL-E, Spark-TTS 等)都可以通过这种“Masked Diffusion + 权重迁移”的方式转化为非自回归模型。
局限性:
- 目前仍需要预先指定输出长度(Token-to-text ratio)。
- 暂时不支持流式生成(Streaming)。
未来展望: 作者提到的“步骤蒸馏(Distillation)”和“前缀优先解冻(Prefix-priority unmasking)”可能是解决推理效率和流式生成的最后一块拼图。这篇论文开启了语音模型从“序列拟合”向“全局生成控制”演进的新阶段。