
LLM-Emu:无需 GPU,也能精准模拟 vLLM 的在线服务表现
LLM-Emu: Native Runtime Emulation of LLM Inference via Profile-Driven Sampling
本文推出了 LLM-Emu,一个针对 vLLM 的原生运行时仿真器(Serving-native Emulator)。通过将 GPU 前向计算替换为基于剖析(Profile-driven)的延迟采样和合成 Token,它能在无 GPU 的情况下精确模拟 vLLM 在在线服务场景下的排队、调度及吞吐行为。
TL;DR
在 LLM 服务系统研究中,昂贵的显卡资源往往是实验的瓶颈。由剑桥大学研究者开发的 LLM-Emu 提供了一个天才的解决方案:它通过在 vLLM 内部植入一个轻量级插件,将真实的 GPU 矩阵运算替换为基于历史经验的“延迟采样”。它不仅能跑在 CPU 环境下,还能完美复刻 vLLM 的调度行为,且误差极低(关键指标误差 < 5%)。
痛点深挖:为什么现有的模拟器不够用?
传统的 LLM 服务模拟器(如 Vidur, LLMServingSim)通常面临三个痛点:
- 重复造轮子:为了模拟 vLLM,往往需要用 Python 重新写一遍 vLLM 的调度逻辑。一旦 vLLM 升级(如引入 Chunked Prefill),模拟器就失效了。
- “温室里”的评估:多数模拟器是离线的,无法直接对接真实的 HTTP 客户端,忽略了网络延迟、系统调用开销等真实的生产环境因素。
- 计算复杂度与精度的平衡:基于算子级的拉丁建模(Operator-level modeling)虽然精细,但配置困难且难以跨硬件迁移。
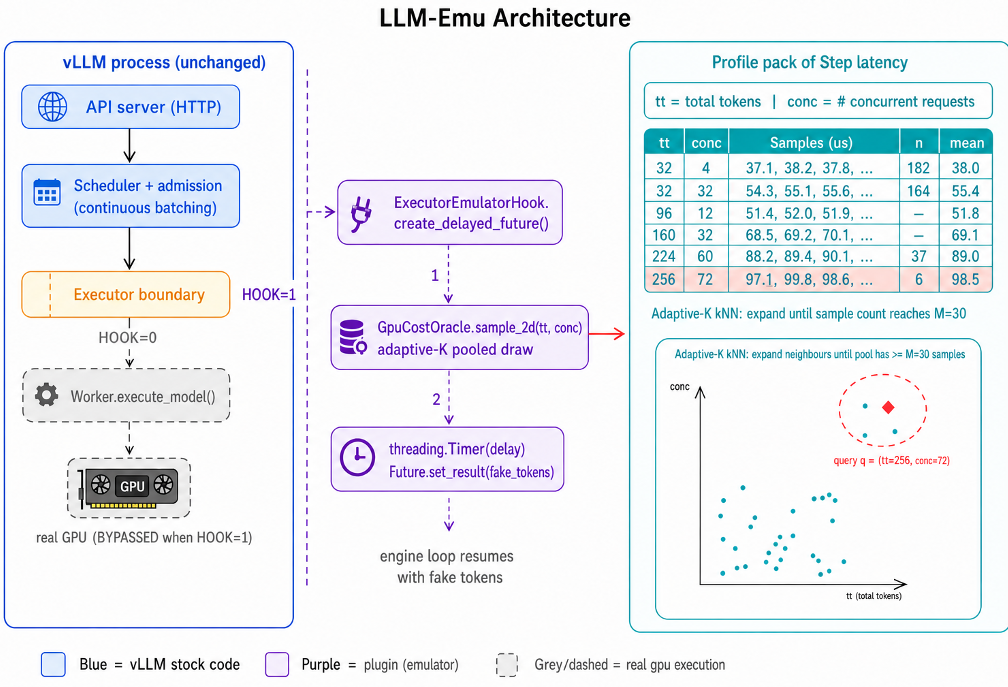 图 1:LLM-Emu 插件化设计,仅接管 Executor 边界,保留 vLLM 核心路径。
核心机制:Serving-Native Emulation
LLM-Emu 的核心直觉是:既然我们只想研究调度和排队行为,为什么不直接运行真实的 vLLM 代码,只是把最“慢”且最耗钱的 GPU 部分“骗”过去呢?
1. 密度感知延迟 Oracle (Density-aware Oracle)
作者并没有使用复杂的机器学习模型。他们发现,GPU 推理每一步(Step)的执行时间主要由两个因素决定:总 Token 数 (tt) 和 并发请求数 (conc)。
- 离线剖析 (Profiling):先在真实 GPU 上跑一遍不同负载,记录下 (tt, conc) 对应的延迟分布。
- Shepard 加权采样:如果在运行中遇到了没见过的 (tt, conc) 组合,算法会利用邻近的已知数据点进行加权。这保证了即使在极端负载下,模拟出的延迟依然具有物理意义。
2. 计时器解析的 Future (Timer-resolved Future)
这是 LLM-Emu 能够维持“墙钟时间 (Wall-clock time)”一致性的关键。它利用异步编程机制,在预测的延迟到期后才返回合成出来的 Token。这意味着 vLLM 的调度器会感知到和真实 GPU 同样的忙闲状态。
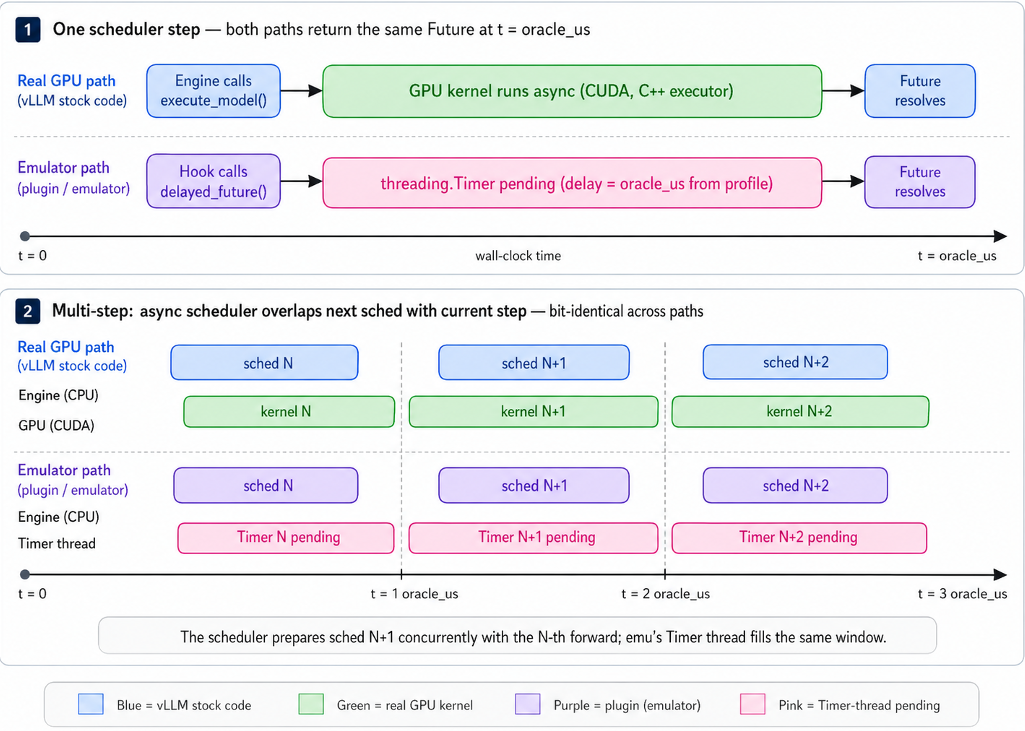 图 2:通过 Timer-based Future 保留调度器与 Worker 之间的重叠通信。
实验结果:足以乱真的仿真精度
LLM-Emu 在 RTX 8000 和 A40 等多种硬件,以及 Qwen3 和 Llama 3.1 等多个模型系列上进行了严苛验证:
- TPOT (Time per output token) 和 ITL (Iteration time latency):这些反映模型运行流畅度的指标,误差几乎可以忽略不计(< 4.8%)。
- 并发稳定性:即使在波动的突发负载(Bursty Workload)下,LLM-Emu 依然能准确预测系统的排队行为。
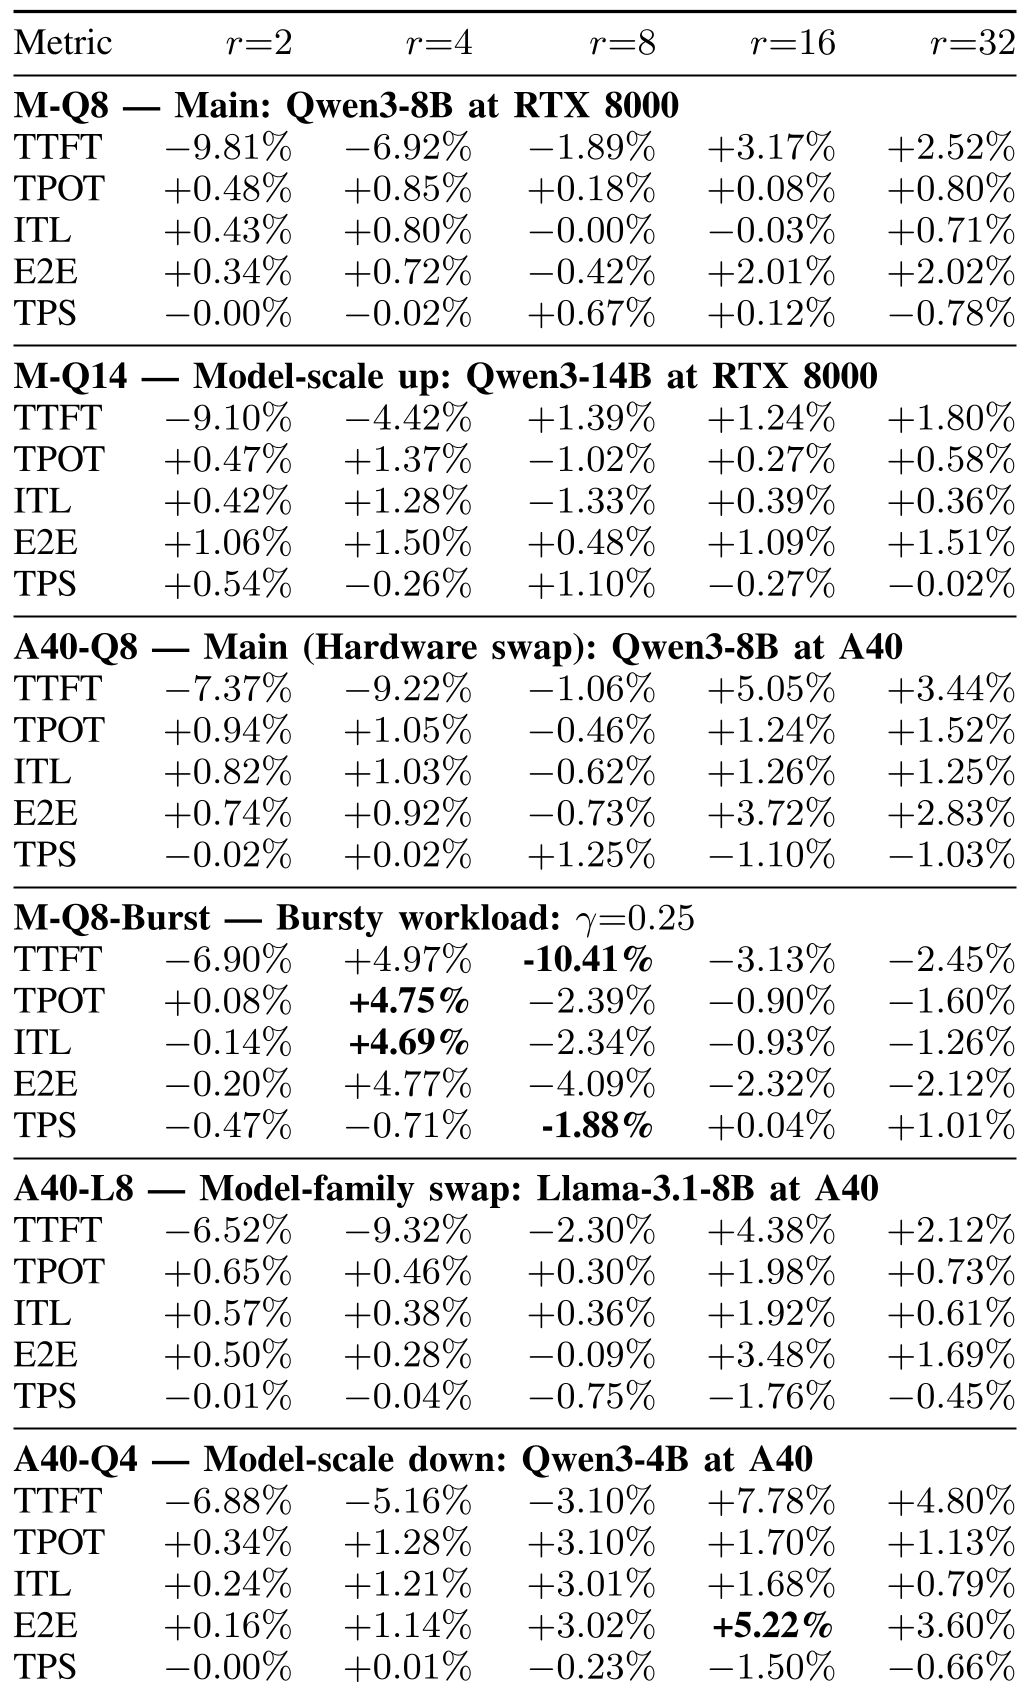 表 1:不同配置下的误差统计,可以看到大部分核心指标都在 5% 误差线以内。
局限性与展望
尽管精度惊人,LLM-Emu 目前仍存在局限:
- Profile 成本:虽然不需要每次都跑全量测试,但针对新硬件采集初始 Profile 仍需数小时 GPU 时间。
- 多机模拟:目前主要验证了单节点性能,多机分布式的多维度仿真将是未来的主战场。
总结
LLM-Emu 绕过了“重构系统”的深坑,通过“原生插件”这一巧妙的切入点,为 LLM 算力优化提供了一个高保真、低成本的调试器。这对于预算有限的实验室或需要快速验证调度算法的工程团队来说,无疑是一款利器。