
Lighthouse Attention:预训练长文本的高速公路,训练提速 21 倍且无损恢复
Long Context Pre-Training with Lighthouse Attention
本文提出了 Lighthouse Attention,一种旨在解决长文本训练瓶颈的对称选择性层次化注意力机制。该方法通过将 Q、K、V 对称池化为多级金字塔并进行子序列采样,使得在 512K 上下文下的前向训练速度提升高达 21 倍,且能通过简短的恢复训练完美适配标准全注意力模型。
TL;DR
Transformer 在超长文本下的 计算量一直是硬伤。Nous Research 提出的 Lighthouse Attention 打破了“稀疏注意力训练出的模型表现不如密集模型”的魔咒。它通过对 Q, K, V 进行对称的层次化池化采样,将训练复杂度降至近线性,并在 Blackwell B200 上实现了 512K 长度下 21 倍的前向加速。最黑科技的是:训练快结束时跑一小段(约 10% 进度)标准注意力,模型就能完全“变身”回标准的 FlashAttention 模型,效果甚至比纯靠硬练的基线还好。
痛点深挖:为什么稀疏注意力训练总是“差点意思”?
目前工业界处理长文本训练主要面临两个尴尬:
- 计算非对称的浪费:很多稀疏方法(如 DeepSeek-V3)为了保证精度,必须保留全分辨率的 Query,只对 Key-Value 降采样。这在推理时有用,但在预训练时,Query 的数量依然随长度 爆炸,限制了训练规模。
- 算子绑定的“牢笼”:大多数稀疏算法将索引逻辑写死了在 CUDA 内核里。这意味着你训练出来的权重只能配套那个特定的稀疏算子用,一旦你想在推理时切换回极致优化的 FlashAttention,效果往往会崩掉。
Lighthouse 的作者认为:我们应该在训练时极度省钱(对称压缩 QKV),但在模型心智成熟后,通过特定的“恢复训练”让它重归正途。
核心方法:金字塔池化与“外部选择”
Lighthouse 的架构极其简洁,它像一个“包装盒”一样套在标准 FlashAttention 的外面。
1. 对称金字塔池化 (Symmetric Pyramid Pool)
不同于前人只缩减 KV,Lighthouse 对 Q, K, V 进行同步的平均池化,构建多层金字塔。这意味着一个池化后的 Q 向量代表了一小块文本的“意图总和”。
2. 层次化选择器 (Hierarchical Selector)
利用无参数的 范数得分(或者扩张注意力得分),在每一层金字塔中挑选出最重要的 Top-K 条目。通过一个精心设计的 Chunked Bitonic Top-K 内核,可以在 GPU 上高效完成排序。
3. 标准 FlashAttention 调用
这是最精妙的一点:由于选出的 Q、K、V 已经组成了一个稠密的、保持因果律的子序列,Lighthouse 不需要任何自定义注意力内核,直接调 PyTorch 原生的 FlashAttention 即可。
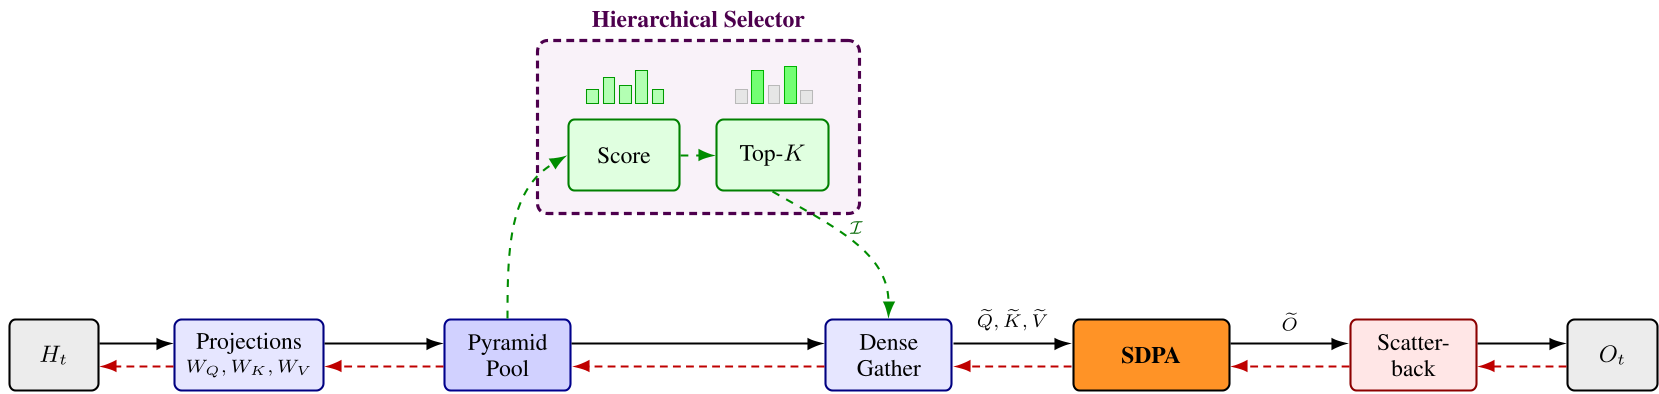 图注:Lighthouse 架构展示了从池化、选择到最终 Scatter-back 的全过程。虚线代表梯度流,避开了不可导的选择分支。
实验结果:速度与质量的双重飞跃
吞吐量:制霸长文本
在传统的密集注意力面前,随着序列长度超过 100K,计算量呈平方级崩塌。而 Lighthouse 利用 的子序列规模,将计算量维持在极低水平。
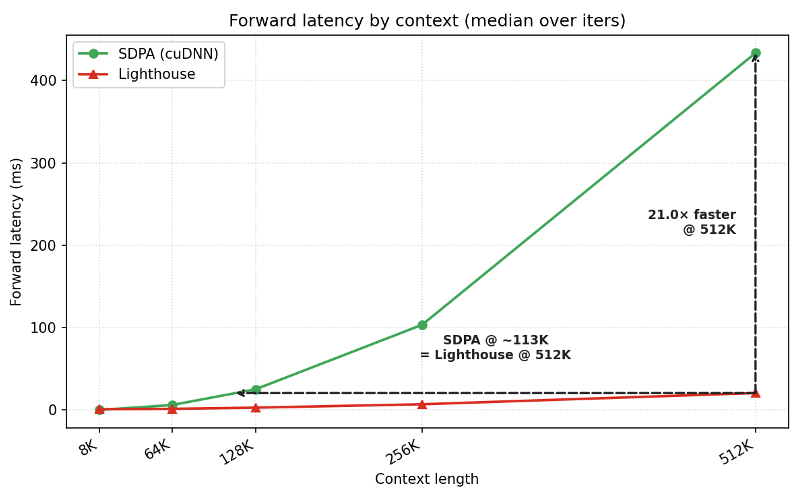 图注:在 B200 上,当上下文达到 512K 时,Lighthouse 的计算优势变得极其显著。
恢复力验证:两阶段训练的效果
作者进行了一个关键实验:先用 Lighthouse 训练 10k-12k 步,然后切换回标准 SDPA 继续跑几千步。
- 损失函数 (Loss):切换瞬间 Loss 会有小跳,但 1000 步内迅速收敛,最终 Loss(0.6980)竟然比全程硬磕 SDPA 的基线(0.7237)还要低。
- 检索能力 (NIAH):大海捞针测试显示,Lighthouse 预训练的模型在 98K 长度下的检索准确率(约 76%)同样优于密集训练基线(约 72%)。
深度洞察:为什么“对称采样”有效?
Lighthouse 成功的底层逻辑在于:梯度流的方向。 虽然 Top-K 选择过程本身不可导,但梯度可以通过 Scatter(写回)和 Gather(采集)操作,以及内部的标准 FlashAttention 流向 映射层。
这产生了一个有趣的诱导效应:模型由于知道只有部分条目会被选中,它会学习将最关键的信号编码进更强的向量范数中。而对称池化保证了 Query 也能在低分辨率空间找到对应的 Key。这种“层次化学习信号”可能比纯粹全局扫描起到了更优秀的正则化作用。
总结与启示
Lighthouse Attention 为长文本预训练提供了一条极为务实的路径:
- 无感集成:不需要写复杂的 CUDA 算子,兼容现有所有基于 FlashAttention 的优化策略(如 Context Parallelism)。
- 极速降本:在 1M 长度下,这可能是目前唯一能跑得动且不丢失模型精度的训练方案。
- 推理友好:最终得到的权重就是标准 Transformer 权重,部署不需要改一行代码。
局限性:虽然训练神速,但当前的实现尚未完全解决自回归推理阶段(Token-by-token)的稀疏适配问题。不过,正如作者所愿,这种两阶段策略已经足以改变大规模长文本模型的训练范式。