
LookWhen:精准捕捉时空“闪光点”,视频识别效率飞跃 6.7 倍
LookWhen? Fast Video Recognition by Learning When, Where, and What to Compute
本文提出了 LookWhen,一个专为视频识别设计的“选择器-提取器”(Selector-Extractor)架构。该方法通过轻量级选择器在时空维度定位关键特征,并由深度提取器处理极少数(Top-K)稀疏 Token,在保持 SOTA 准确度的同时,实现了 6.7 倍的推理加速。
TL;DR
在视频理解领域,Transformer 虽然强大,但其计算开销随着帧数和分辨率的增加呈超线性增长。LookWhen 提出了一种创新的“选择器-提取器”架构,不再死磕如何“消化”全量视频 Token,而是先用一个极轻量的网络判断“何时、何地”存在关键信息。通过对 90% 以上冗余 Token 的果断舍弃,LookWhen 在实际推理中比当前 SOTA 模型 InternVideo2 快了 6.7 倍,且在多个动作识别场景中保持了 Pareto 最优。
痛点深挖:为何视频计算总是“费力不讨好”?
视频本质上是高度冗余的数据。在一段 10 秒的视频中,大部分背景是静态的,很多帧之间的差异微乎其微。
- 计算浪费:主流模型如 VideoMAE 依然会对所有时空补丁(Patches)进行处理。
- 虚假加速:现有的 Token Merging(如 ToMe)算法虽然减少了 FLOPs,但因为涉及复杂的聚类操作且与高效算子(如 Flash Attention)不兼容,在 GPU 上的实际运行速度提升寥寥。
- 架构直觉:如果能建立一个“先预判,再精确提取”的流程,就能像人类视觉一样,只盯着有意义的动作看。
核心方法:LookWhen 的“降维打击”
LookWhen 的核心由两个子网络构成:
1. 架构解析 (The Selector-Extractor)
- Selector (选择器):接收低分辨率视频,仅含 3 层 Transformer,负责对数以千计的 Token 进行打分。
- Extractor (提取器):深度 Transformer,只处理得分最高的 Top-K 个 Token。
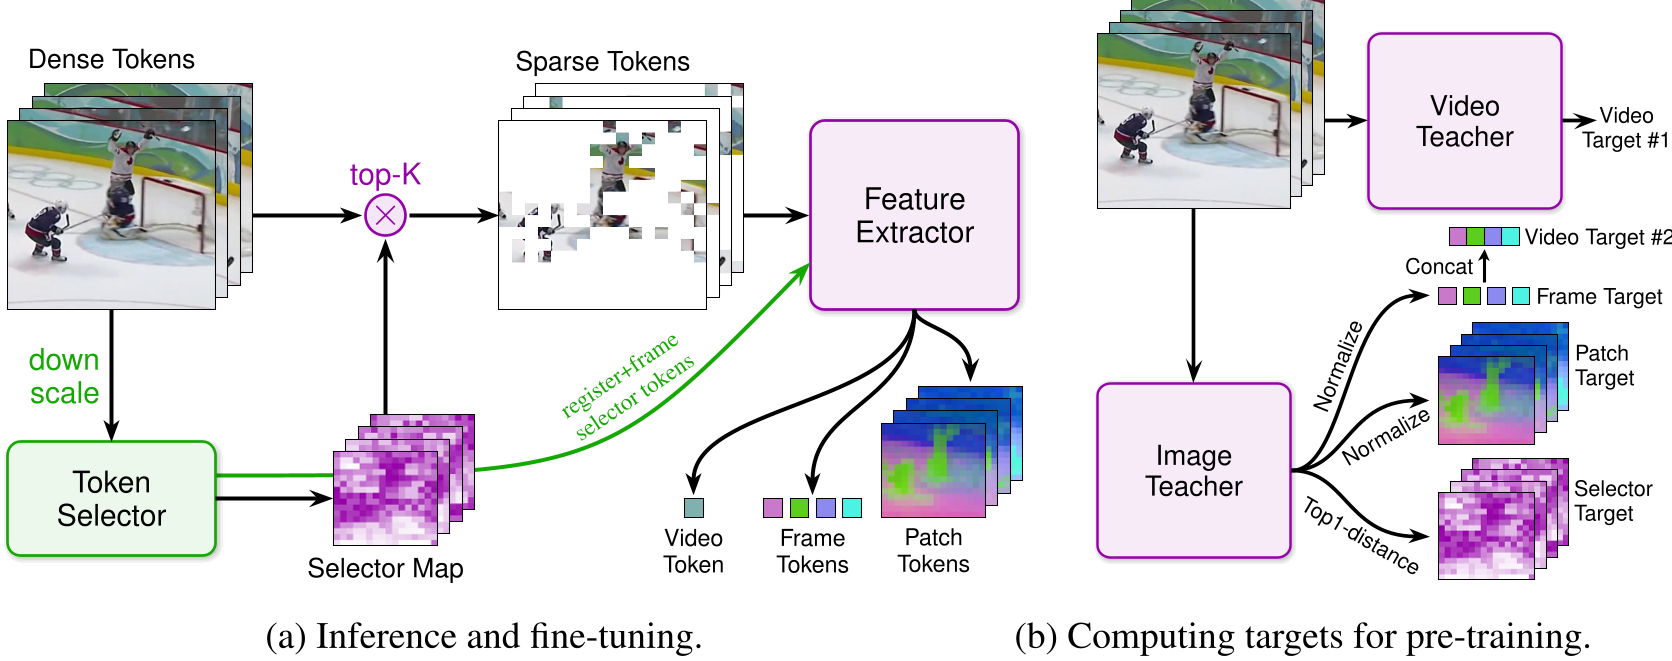 图 1:LookWhen 流程。左侧选择器根据“独特度”挑出关键点,右侧提取器进行高性能特征提取。
2. 独特度评分:Top1-Distance
如何教会模型什么是“重要”的?作者发现,传统的 Attention Map(注意力图)充满了伪影(Artifacts),不适合做监督信号。他们提出:独特即重要。 通过计算 Token 在特征空间中到其最近邻(Nearest Neighbor)的距离。如果一个 Token 离别人都很远,说明它包含了视频中不可替代的信息(如正在划水的肢体),必须保留。
3. 多教师蒸馏 (Multi-teacher Distillation)
为了让稀疏的 Token 能代表全量视频特征,LookWhen 同时向两个“大神”学习:
- InternVideo2:教会模型理解视频全局语义。
- DINOv3:提供精细的时空感知力。
实验与结果:真实的性能野兽
在 Kinetics-400 和 SSv2 等多项任务对比中,LookWhen 展现了统治级的效率。
- 吞吐量优势:如图 5 所示,在同等准确率下,LookWhen 的吞吐量远超 InternVideo2 及其各种变体。
- 消融验证:实验证明,如果不进行“时间归一化”,模型很难捕捉到细微的动作变化。加入特征标准化后,在 SSv2 这种强时序关联的数据集上,LP(线性探测)性能提升了 6.4%。
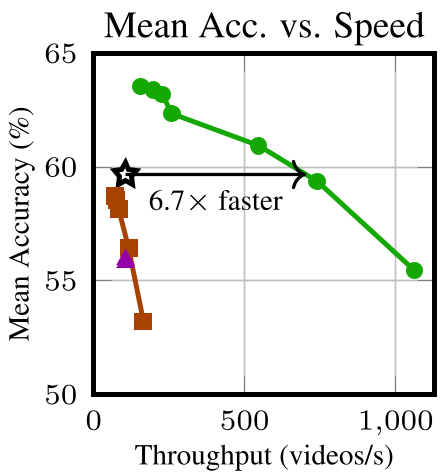 图 2:吞吐量对比,LookWhen 在横轴(速度)上表现极佳。
深度洞察:为什么 LookWhen 更有价值?
相较于以往的 Token 压缩技术,LookWhen 真正的贡献在于解耦了“感知”与“理解”。
- 工程友好性:它不再需要复杂的层间聚类,而是直接在输入端减少 Token 数量,这让它能完美适配现代 GPU 的加速指令集。
- 泛化能力:它学习的是视频的“冗余规律”而非特定任务特征。这意味着你可以用它在不重新训练选择器的情况下,快速适配到新的视频分类任务中。
局限性与展望
尽管在 ViT-Base 规模上取得了成功,但在超大规模模型(如 ViT-Huge)上的表现仍待验证。此外,如何处理极长视频(例如 LookThen 概念)将是未来的重要方向。
总结:LookWhen 向我们展示了,在视频 AI 走向长文本、高分辨率的今天,“聪明地挑选”比“蛮力地计算”更重要。它不仅是刷榜的 SOTA,更是迈向实时视频理解的重要一步。