
[CVPR 2026] LumosX:打破“张冠李戴”,实现多主体个性化视频生成的新高度
LumosX: Relate Any Identities with Their Attributes for Personalized Video Generation
本文推出了 LumosX,这是一个专门针对个性化多主体视频生成的框架。通过引入关系感知的数据构建流水线和改进的 Diffusion Transformer (DiT) 架构,实现在复杂场景下对多个主体及其属性(如人脸与衣着)的精准绑定与一致性生成。
TL;DR
在视频生成领域,让模型同时生成多个特定人物(如:你和你的朋友)并让他们穿着指定的衣服一直是个难题。阿里巴巴与浙大等团队推出的 LumosX 通过建立一套“关系属性感知”的架构,精准解决了多主体间的属性错位问题。它不仅能保真地还原人脸,还能确保“红衣服”穿在 A 身上而非 B 身上。
背景定位:从“能生成”到“精准控制”
虽然以 Sora、Wan2.1 为代表的视频生成模型已经能产出惊艳的效果,但在个性化定制 (Personalization) 场景下,一旦涉及多个主体,生成的逻辑往往会崩溃。现有的 DiT 架构模型在处理多个 Reference 图像时,常常将所有 Token 混合在一起,导致属性泄露(Attribute Leakage)。LumosX 的核心价值在于:它在 DiT 的底层交互逻辑中注入了显式的“人物-属性”绑定关系。
痛点深挖:为什么多主体生成这么难?
- 数据缺失:现有数据集(如 Panda70M)虽然有描述,但没有明确标注“哪个属性属于哪个主体”。
- 空间模糊:传统的 3D-RoPE 位置编码无法识别不同主体间的拓扑关系。
- 注意力混淆:在注意力机制中,A 脸的特征可能会在隐空间的交互中被“平均”到 B 脸上去,导致身份模糊。
核心方法论:LumosX 的双重约束
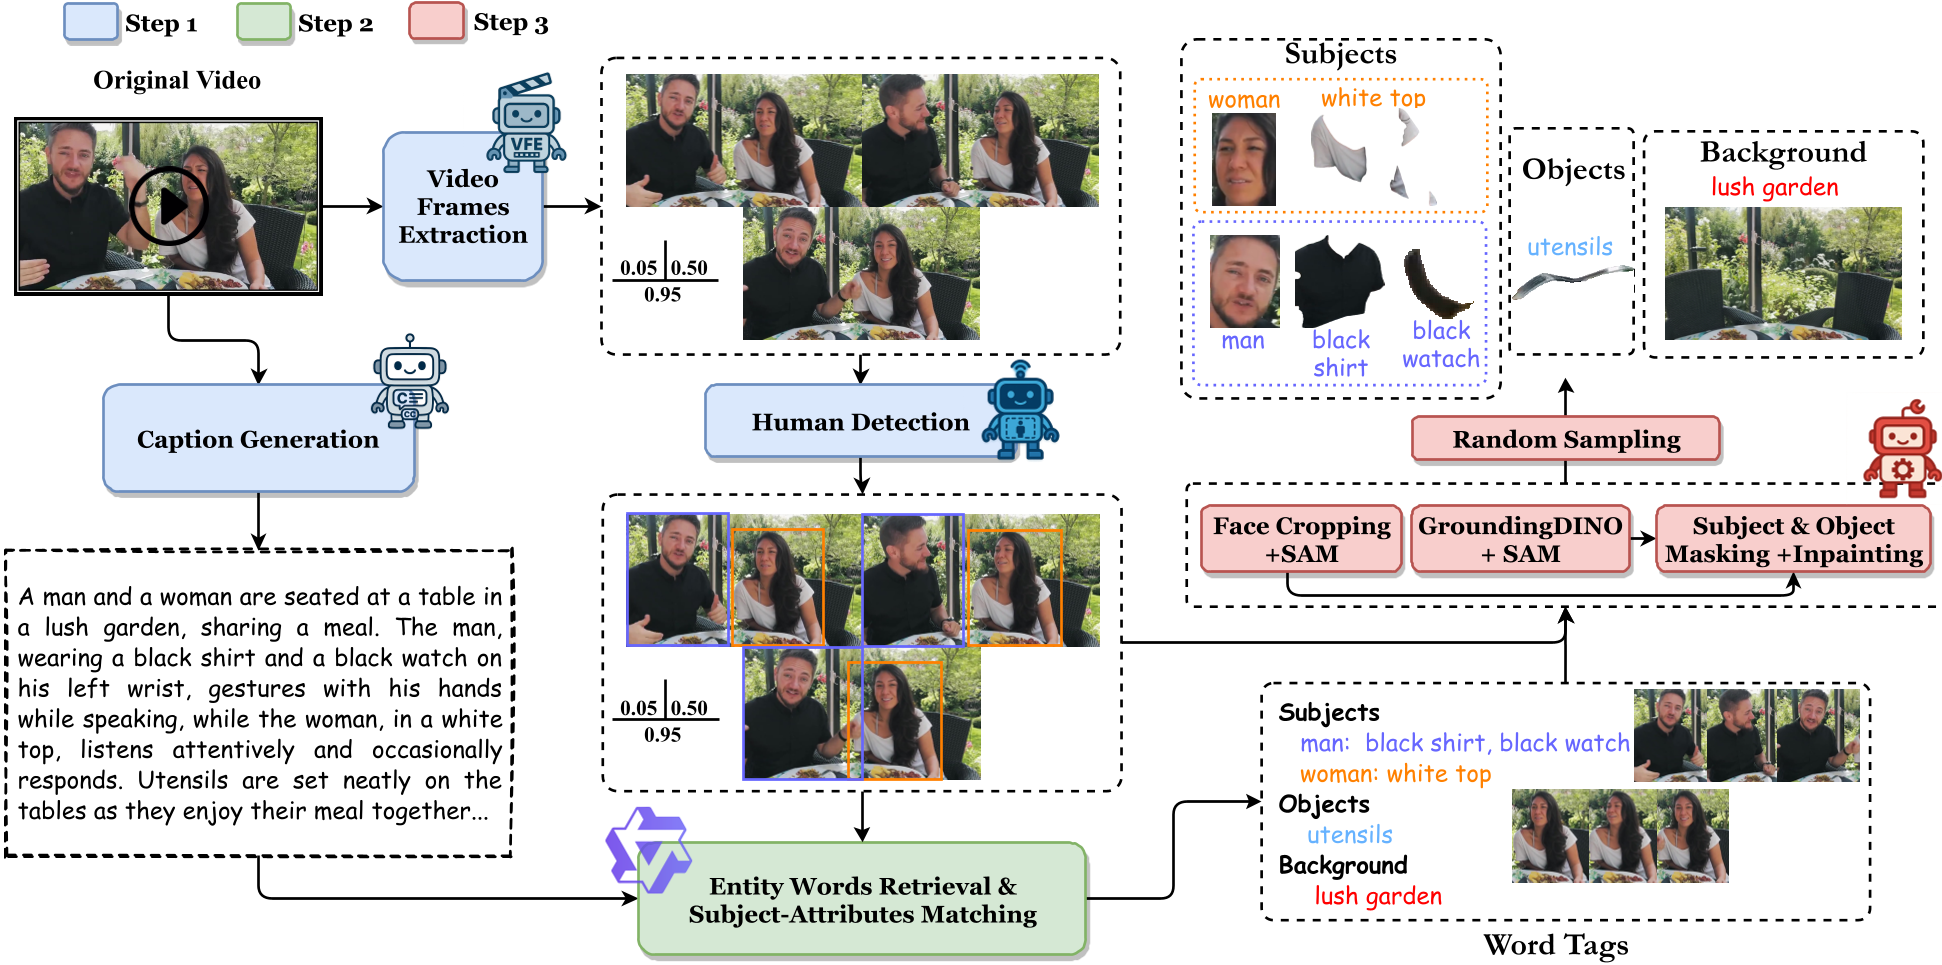
1. 关系感知的自动化数据流水线
为了训练模型,作者开发了一套自动化管线。核心在于利用 Qwen2.5-VL 强大的多模态理解能力,对视频帧进行“实体词提取”与“人脸-属性匹配”。
- 人脸剪裁 + SAM 分割:将人脸和衣物、配饰分别分割。
- 背景修复:使用 FLUX 对主体移除后的区域进行 Inpainting,得到纯净的背景参考图。
2. 关系位置编码 (R2PE) 与 Causal Mask
为了让模型知道 A 脸和 A 衣是一组,LumosX 修改了位置编码计算方式。在自注意力层,通过 Relational Rotary Position Embedding (R2PE),让同组的 Token 在空间索引上产生关联,并使用 Causal Self-Attention Mask (CSAM) 确保去噪过程能独立且高效地聚合条件信号。
3. 多级交叉注意力掩码 (MCAM)
这是 LumosX 解决语义对齐的核心。作者定义了三个层级的相关度:
- 强相关 (Strong Correlation):视觉 Token 与其对应的文本词汇(如:A 的图片对应标签“男人”)。
- 弱相关 (Weak Correlation):不同主体组之间的交互。
- 常态相关 (Correlation):默认的交互强度。 通过这种软约束,模型在生成时能显著减少跨主体的干扰。

实验战绩:SOTA 级的身份与语义对齐
在与 SkyReels-A2 和 Phantom 等强力基线的对比中,LumosX 展现了压倒性的优势。特别是在涉及 2-3 个主体的复杂任务中,LumosX 在人脸相似度 (ArcSim) 上保持了极高的水准。
| 方法 | 主体数量 | ArcSim (人脸一致性) ↑ | CLIP-I (图像相似度) ↑ |
|---|---|---|---|
| Phantom | 2 Subjects | 0.396 | 0.658 |
| LumosX | 2 Subjects | 0.443 | 0.699 |
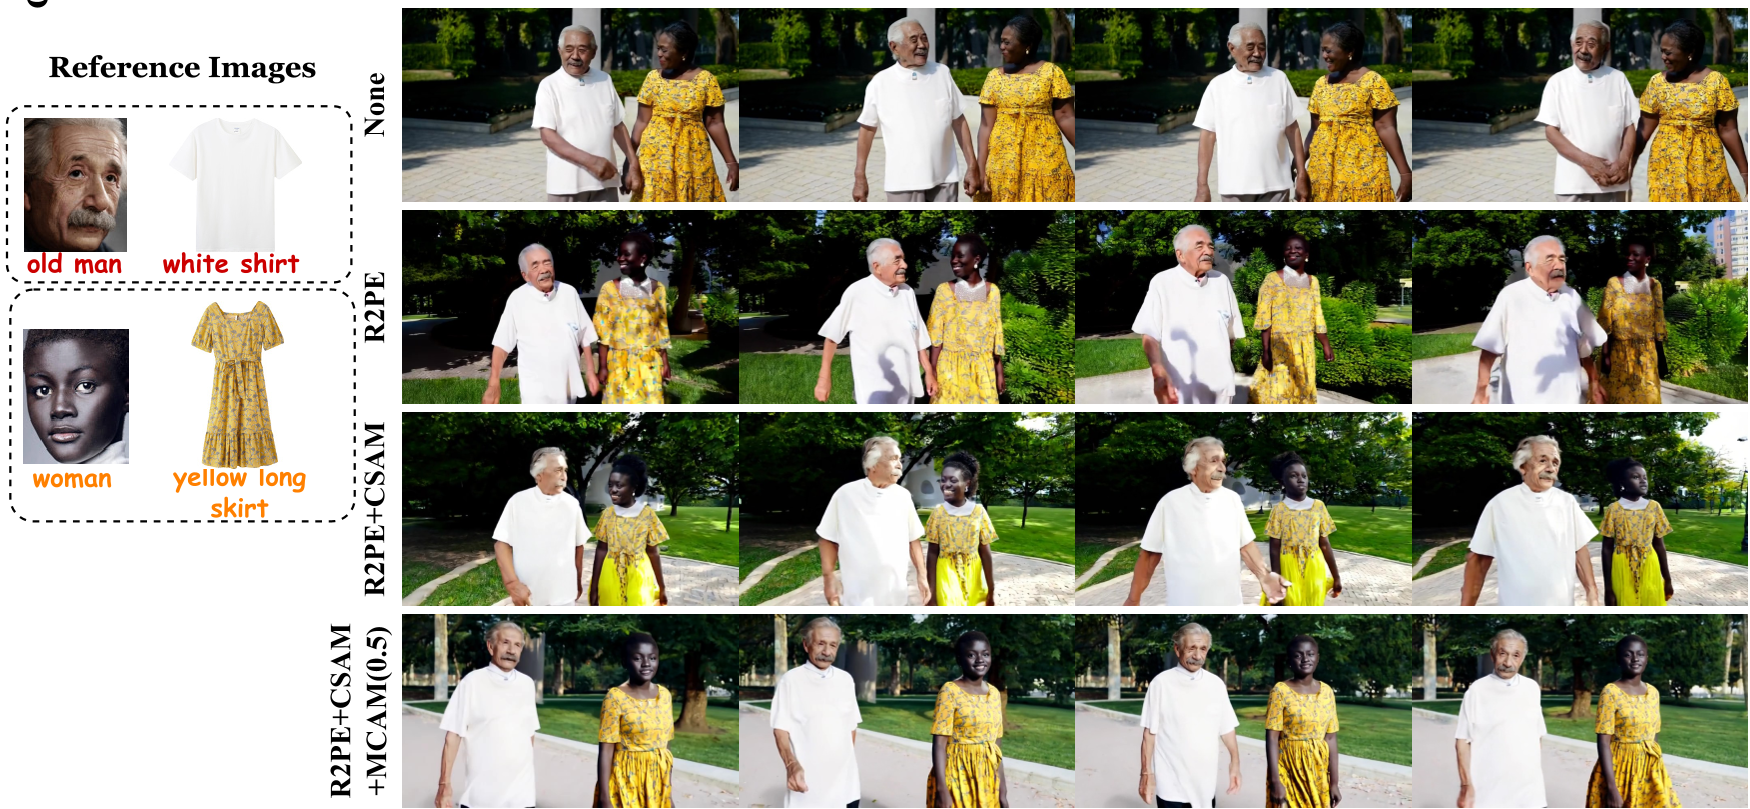
从消融实验可以看出,引入了 MCAM 后,人物的肤色、发色和服装不再会因为同框主体的存在而发生偏移,真正做到了“各美其美”。
深度洞察:对未来的启示
LumosX 的成功告诉我们,大模型时代的“暴力训练”虽能解决画质问题,但精细化控制仍需依靠对物理直觉的分层设计。其提出的关系掩码机制不仅适用于视频,在多主体图生图、虚拟试衣等领域同样具有极高的迁移价值。
然而,论文也提到了局限性:当主体数量超过 10 个时,基础模型(如 Wan2.1-1.3B)的表征能力会成为瓶颈,这预示着未来的突破点可能在于超大规模参数模型与更先进的位置外推(Length Extrapolation)技术的结合。
总结
LumosX 为个性化视频生成树立了新的标杆。它通过“数据+模型”的双轮驱动,解决了长期困扰多主体生成的属性绑定难题。对于追求高保真、强控制的开发者来说,这篇论文无疑是必读之作。