
光度红移预测:从黑盒回归到生成式宇宙学建模
Machine Learning Techniques for Astrophysics and Cosmology: Photometric Redshifts
本文系统综述了人工智能(AI)在星系光度红移(Photo-z)预测中的应用演进。重点介绍了从早期的判别式回归方法(如 ANNz)到当前前沿的生成式贝叶斯模型(如 GalSBI),并探讨了如何通过模拟推断(SBI)解决下一代宇宙学巡天(如 LSST 和 Euclid)对红移精度近乎苛刻的要求。
TL;DR
星系的光度红移(Photometric Redshift, Photo-z)是现代宇宙学的基石之一。本文深刻揭示了该领域的范式演变:我们正在告别单纯依赖光谱标签进行“点对点”拟合的判别式 AI 时代,全面拥抱以物理模型驱动、利用生成式 AI 构建先验的生成式分层建模时代。
背景定位:宇宙距离阶梯的“捷径”与“陷阱”
在宇宙学研究中,红移是测量星系距离、追踪宇宙膨胀历史的核心指标。虽然光谱观测最精确(利用原子谱线特征),但其耗时极长且对暗弱星系无能为力。相比之下,基于宽带图像颜色预测红移的 Photo-z 技术规模化程度极高,是 Vera Rubin (LSST) 和 Euclid 等先进巡天任务的唯一选择。
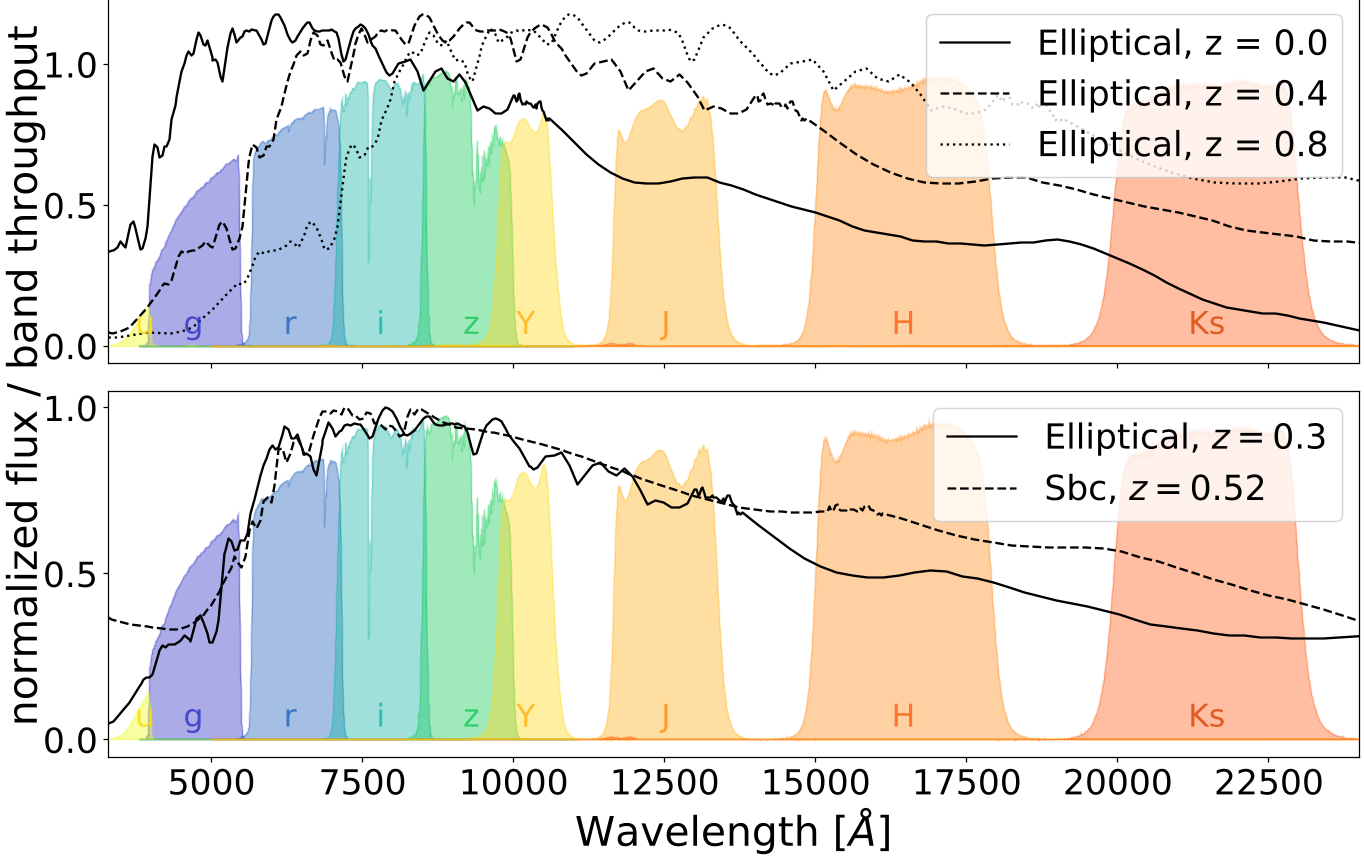
然而,Photo-z 存在致命的“简并”问题。如图 1.1 所示,不同红移下的不同类型星系(如低红移的 4000 Å 间断与高红移的 Lyman 间断)在测光空间中可能具有完全一致的颜色,这种“身份错位”会导致灾难性的红移预测错误。
痛点深挖:判别式方法的“天花板”
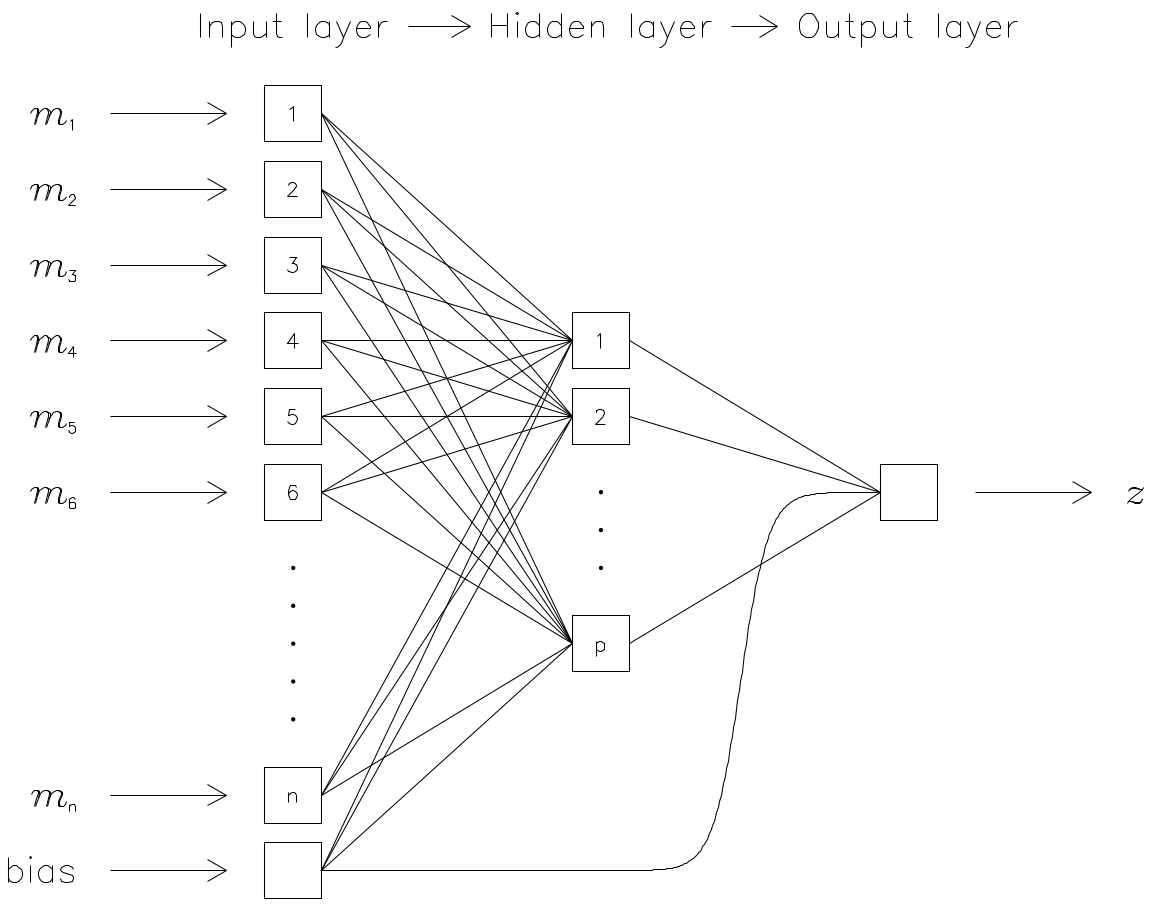
在过去的二十年中,机器学习几乎被等同于判别式回归:输入星系多波段亮度,输出预测红移。
- 方法论局限:无论是早期的多层感知机(MLP,如著名的 ANNz),还是后来的高斯过程、随机森林,都高度依赖于一支“高质量光谱训练样本”。
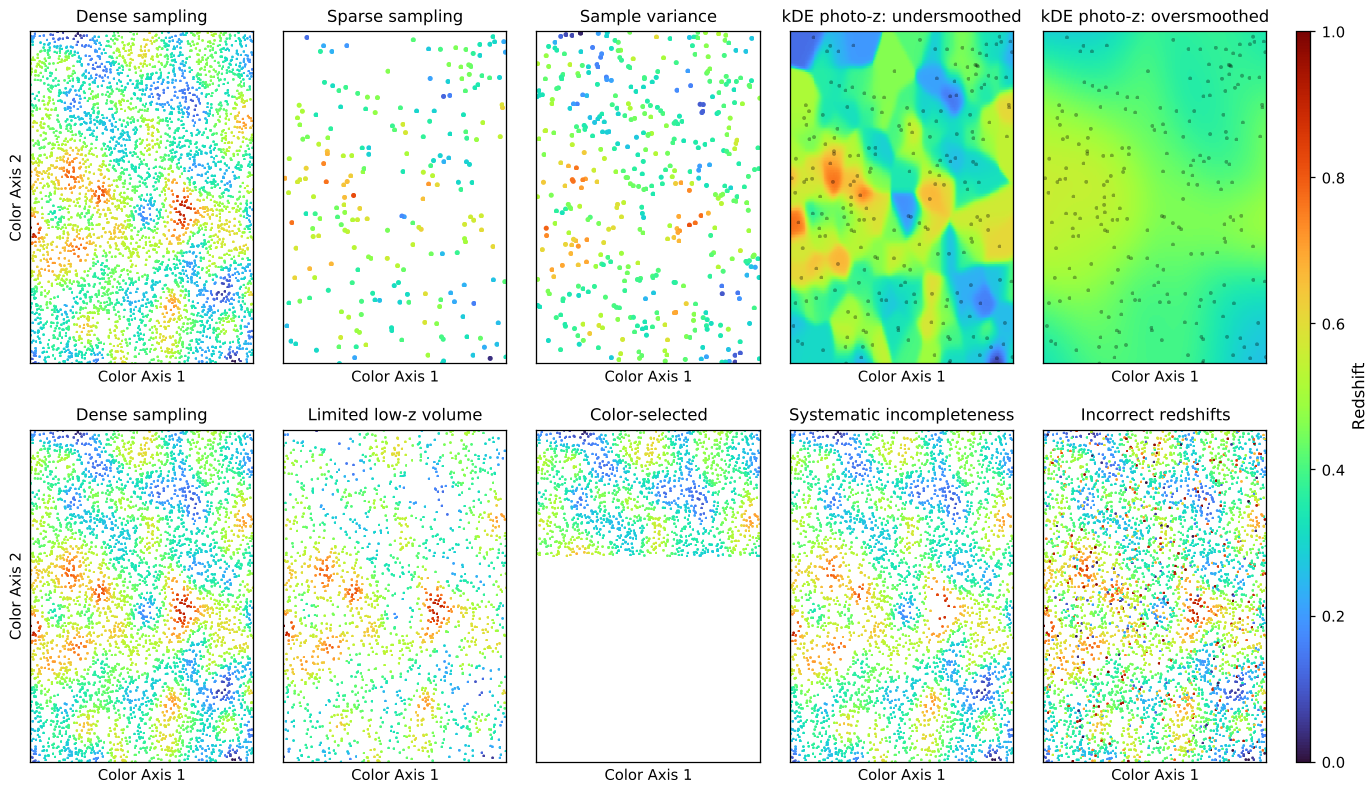
- 致命伤:真实宇宙中的暗弱星系往往没有光谱标签。如果机器学习模型只在亮星系(代表性极差的训练集)上训练,逻辑外推产生的偏置(Bias)将直接导致关键宇宙学参数(如 物质密度波动幅度)出现偏差,引发所谓的“宇宙学紧张局势”。
核心进阶:转向生成式 AI 与贝叶斯建模
作者提出,要达到 Stage IV 宇宙学实验要求的千分之一级别的精度,必须弃用“端到端黑盒”,转向正向模拟建模(Forward Modeling)。
1. 架构解析:显式贝叶斯框架
生成式方法不再直接求 ,而是模拟观测过程:
- 显式先验 :利用 Normalizing Flows 或 Diffusion Models 学习星系内在物理属性的分布,而非简单依赖不完整的训练集分布。
- 像素级 Likelihood:通过模拟器渲染出带有噪声、模糊(PSF)和星系混合(Blending)效应的图像,真正模拟“望远镜看到了什么”。
2. 多合一推断框架(GalSBI)
为了处理海量的计算量,作者引入了仿真推断(Simulation-Based Inference, SBI)。
- 神经模拟器:用神经网络替代昂贵的像素级物理仿真渲染。
- 摊销推断(Amortization):一次性训练好后,可以大规模应用于数十亿个星系,实现毫秒级推断。
实验结果与深度洞察
在针对 KiDS 等大规模巡天的重新校准中,这种新型生成式方法展现了惊人的威力。最核心的发现是:光谱样本不再仅仅是标签,而是作为约束星族演化物理模型的输入。
通过在模型中显式考虑星系演化、尘埃消光等物理参数,研究人员发现先前的 紧张局势大半源于红移校准的偏移。当校准通过生成模模型得到修正后(如图 1.3 所示的偏移对比),宇宙参数的测量值重新回到了标准宇宙学模型的框架内。
总结与展望 (Takeaways)
- 从拟合到模拟:未来的 Photo-z 研究不再是寻找更复杂的神经网络结构,而是构建更真实的星系演化模拟器。
- AI 的新角色:生成式 AI 在此扮演了“物理加速器”和“密度估计器”的双重角色,极大提升了贝叶斯推断在高维参数空间的效率。
- 局限性:模拟器如果未包含某些系统误差(如星系混合的极端情况),生成式模型依然会产生偏置。验证工作的重心将从传统的预测误差转移到“后验预测检查”。
这场“生成式革命”不仅是为了红移预测,更为整个数据驱动的天体物理研究提供了一套严谨的统计学范式。