
[CVPR 2026] MACRO:打破 5 张图限制,开启多参考图像生成的“长上下文”时代
MACRO: Advancing Multi-Reference Image Generation with Structured Long-Context Data
本文推出了 MacroData,一个包含 400K 高质量样本的大规模多参考图像生成数据集,支持多达 10 张参考图像。通过在该数据集上微调,开源模型在 Customization(定制化)、Illustration(插图)、Spatial(空间推理)和 Temporal(时序预测)四大任务上的长上下文一致性显著提升,达到了接近闭源模型的 SOTA 水平。
TL;DR
在 AI 绘画进入“由图生图”(In-Context Generation)的深水区后,如何让模型同时“读懂”10 张甚至更多参考图并保持一致性?港大 MMLab 与美团联合发表的 MACRO 给出了解法:一个包含 40 万样本、支持 10 图并行的 MacroData 数据集,以及配套的 MacroBench 评测基准。实验证明,只要数据喂得对,开源模型也能在多图定制和 3D 空间推理上硬刚闭源 SOTA。
痛点深挖:消失的参考图与崩坏的一致性
当前的开源模型(如 Bagel, OmniGen2)在处理 1-3 张图时表现尚可,但一旦用户要求“把这 5 个人的衣服换掉,并放在这张背景图里”,模型往往会陷入“顾此失彼”的窘境:
- Capacity Limit (容量限制):大多数模型硬编码了最多 5 张图的输入。
- Dependency Collapse (依赖崩溃):即便强行增加 Token 长度,模型也无法在 10 张图的复杂关系中理清谁是谁,导致 Identity 丢失或属性错位。
作者指出,这并非模型不行,而是现有的数据集太“短”太“碎”了。
Methodology:结构化长上下文数据的“四重奏”
为了教会模型处理复杂依赖,MacroData 并没有盲目堆砌图片,而是设计了四个极具代表性的维度:
- Customization (定制化):将人、物、景、衣、风五种元素跨图组合。
- Illustration (插图):根据长文描述和系列参考图生成具有叙事逻辑的新图。
- Spatial (空间推理):给定物体的多个视角,预测未见的视角(Outside-in & Inside-out)。
- Temporal (时序预测):根据视频序列帧预测下一帧,强调物理动态的一致性。
 图 1:MacroData 的四项核心任务及其参考图分布
为了保证数据质量,团队舍弃了嘈杂的网页抓取,而是采用 “强模型蒸馏 + 闭环过滤” 的方案:先用强 VLM 筛选海量视频/图片序列,再用闭源模型(如 Nano Banana Pro)生成目标图,最后用 LLM-as-Judge 进行双向一致性检查。
核心洞察:Token Selection 是效率良药
当输入图片达到 10 张,序列长度会达到数千个 Token。作者对比了三种 Token 压缩策略:
- Block-wise (块稀疏):保留注意力得分最高的块。
- Image-wise (图像筛选):根据相似度只选部分图(效果最差,因为损失了跨引用的信息)。
- Text-aligned (文本对齐):根据文本指令筛选最相关的视觉 Token。
结果表明,Text-aligned 策略在保留仅 30% Token 的情况下,依然能维持极高的生成精度,这为未来在受限显存下处理“超长视觉上下文”提供了参考路径。
实验战绩:开源模型的华丽变身
在 MacroBench 评测中,微调后的模型展现出了惊人的韧性。
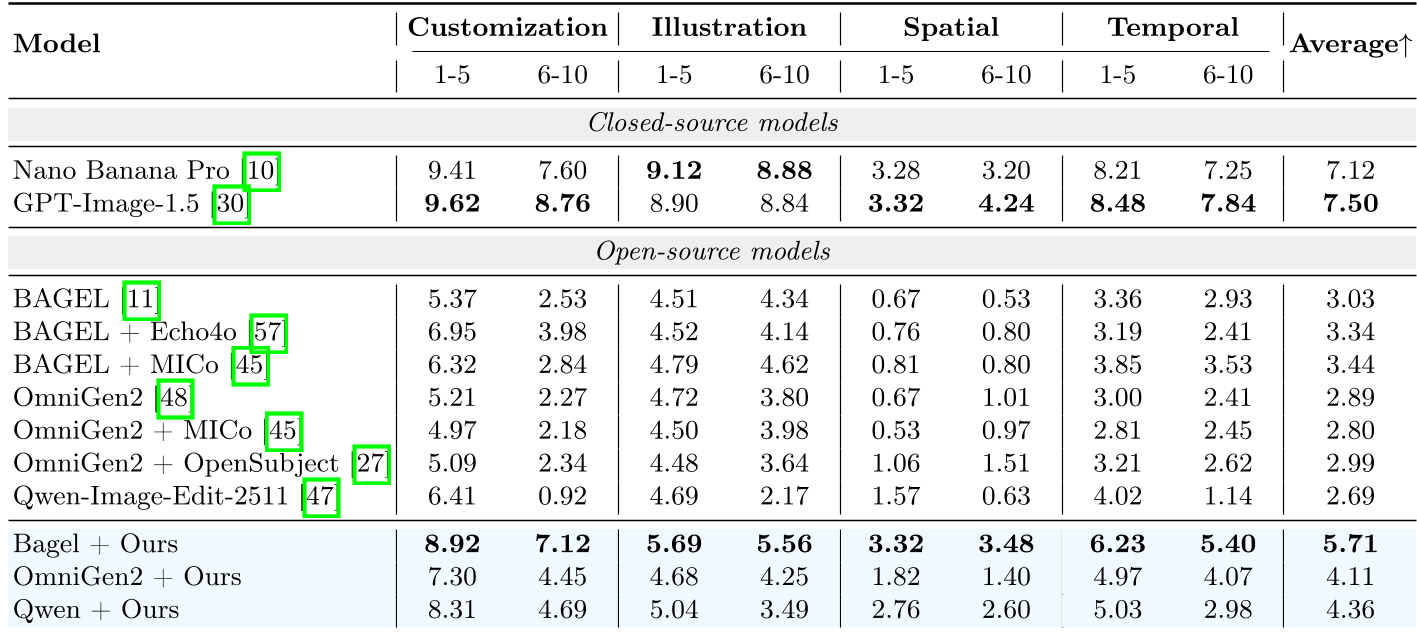 表 1:在不同参考图数量下的性能对比。注意:MacroData 对 6-10 张图场景的提升最为显著。
从表 1 可以看出,基线模型在 6-10 张图时几乎“罢工”(分数跌至 1.0 以下),而加入 MacroData 训练后的 Bagel 分数稳步维持在 5.0 以上。这意味着模型真正学会了如何在长上下文中“寻址”和“提取”特征。
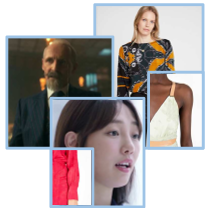 图 2:10 图输入的复杂定制案例。模型完美识别了不同参考图中的人脸、衣服、背景和物体。
总结与局限
Takeaway:MACRO 证明了“数据不仅要大,更要长”。通过结构化的多图依赖数据,模型可以突破单图生成的局限,实现真正的多模态逻辑推理。
局限性:尽管提升巨大,但在处理 8-10 张图时,模型仍偶尔会出现“引用消失”的现象(Failure Case 分析提到)。此外,模型在生成图像中的文字渲染(Text Rendering)方面仍有欠缺。
未来方向:作者表示将进一步探索专门针对多图生成的注意力机制,并扩大 MacroBench 的评测覆盖面。
本文由资深学术主编重构。