
MARCO:探索语义对应中那片“未见”的无限空间
MARCO: Navigating the Unseen Space of Semantic Correspondence
本文提出了 MARCO,一种基于 DINOv2 的统一语义对应(Semantic Correspondence)模型。通过引入轻量化适配器和从粗到精的训练框架,MARCO 在 SPair-71k, AP-10K 等主流基准上刷新了 SOTA 记录,且在参数量缩小 3 倍的同时,推理速度提升了 10 倍。
TL;DR
在计算机视觉中,语义对应(Semantic Correspondence)旨在找寻不同图像间语义对等区域的像素级匹配。虽然 DINOv2 与 Diffusion 模型的“联姻”在各基准榜单霸榜,但这些“重型坦克”往往面临泛化瓶颈——一旦遇到训练集中没见过的关键点,性能便断崖式下跌。本文介绍的 MARCO(语义对应导航模型)回归极简,仅凭单骨干 DINOv2 架构,通过创新的密集自蒸馏和从粗到精的退火策略,不仅在精度上全面碾压双编码器 SOTA,更在推理速度上实现了 10 倍的飞跃。
痛点深挖:稀疏监督的“陷阱”
目前的语义对应研究正陷入一个怪圈:为了追求 PCK 指标,模型变得越来越臃肿(如 Geo-SC)。更严重的问题是,现有的监督信号通常极度稀疏(每对图像仅有约 20 个点)。
- 表现坍缩:模型往往只会在标注过的关键点附近产生聚合,而忽略了物体表面的整体几何结构。
- 泛化缺失:这就导致了一个尴尬的现实——在 Benchmark 上表现优异的模型,在真实场景中由于查询点偏离了标注位置,往往无法工作。
核心机制:如何在稀疏中寻求稠密?
1. 架构的“外科手术”:适配器与上采样
MARCO 并没有盲目增加参数,而是在冻结的 DINOv2 Layer 15-24 之间插入了轻量级的 AdaptFormer 模块,并配合一个 ×4 的上采样头(Refinement Layer)。这种设计以不到 5% 的参数增量,显著增强了模型对子像素级(Sub-patch)空间细节的感知。
2. 从粗到精的定位退火 (Coarse-to-fine)
作者发现,使用固定的高斯核带宽(Sigma)存在 Trade-off:Sigma 过大会导致定位模糊,过小则难以收敛。MARCO 引入了余弦退火策略,训练初期用大 Sigma 学习区域对齐,后期逐渐收缩至 1 像素,强制模型学会精准定位。
3. 基于流量锚定的密集自蒸馏 (Methodology)
这是 MARCO 最具学术洞察力的部分。既然人工标注是稀疏的,能不能利用 DINOv2 本身的语义一致性生成伪标签?
- 发现可靠匹配:通过互近邻(MNN)寻找初步匹配点。
- 几何传播:利用 Delaunay 三角剖分,将零散的点连接成面,通过仿射变换计算出物体表面的稠密流场(Dense Flow)。
- 锚定过滤:用真实的 GT 关键点作为“锚”,剔除由于对称性(例如飞机的左翼被错配到右翼)导致的错误流量聚类。
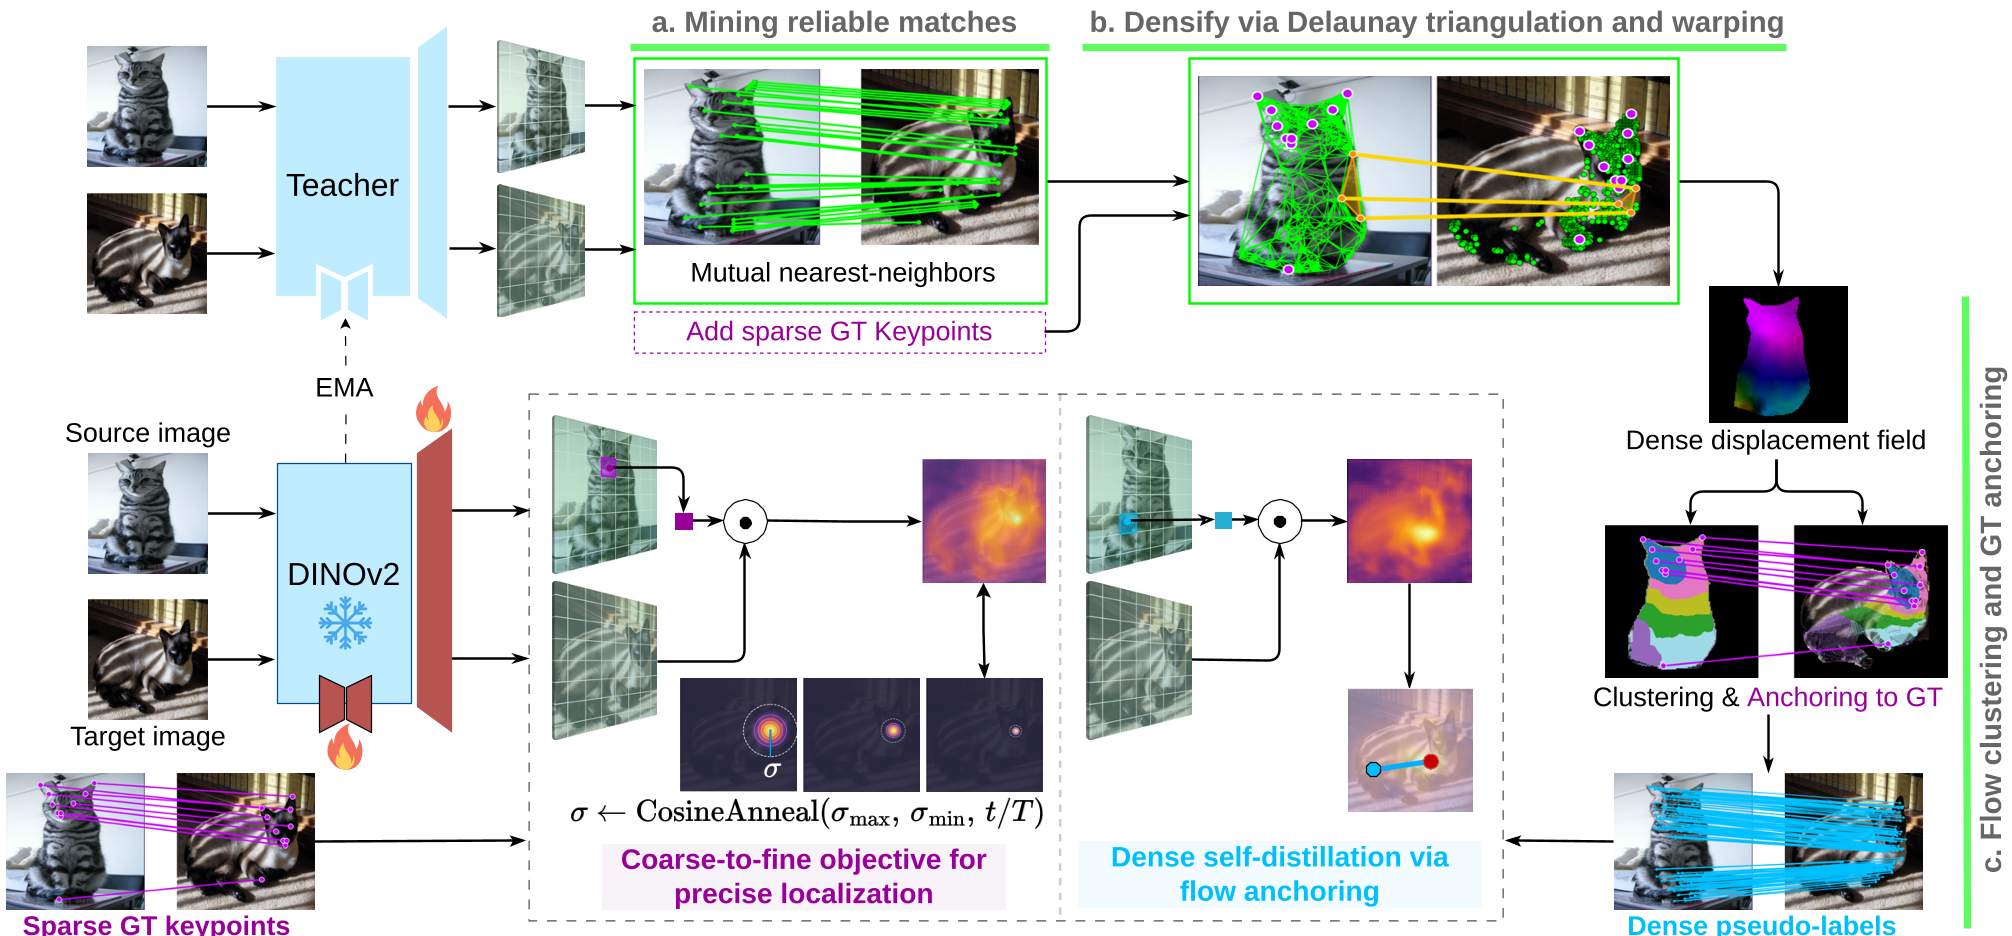 图 1:MARCO 架构概览。展示了轻量化适配器插入、上采样层以及通过流量锚定生成伪标签的过程。
实验战绩:全方位的统治力
在三项核心指标(PCK@0.01, 0.05, 0.10)对比中,MARCO 在几乎所有数据集上(SPair-71k, AP-10K, PF-PASCAL)均刷新了紀錄。
- 高精度定位:在 SPair-71k 上,PCK@0.01 达到 27.0%,远超之前 SOTA 的 21.7%。
- 零射泛化性:在专为测试泛化性设计的 MP-100 协议中,面对人脸、服装、家具等完全未见的类别,MARCO 展现出了更强的鲁棒性。
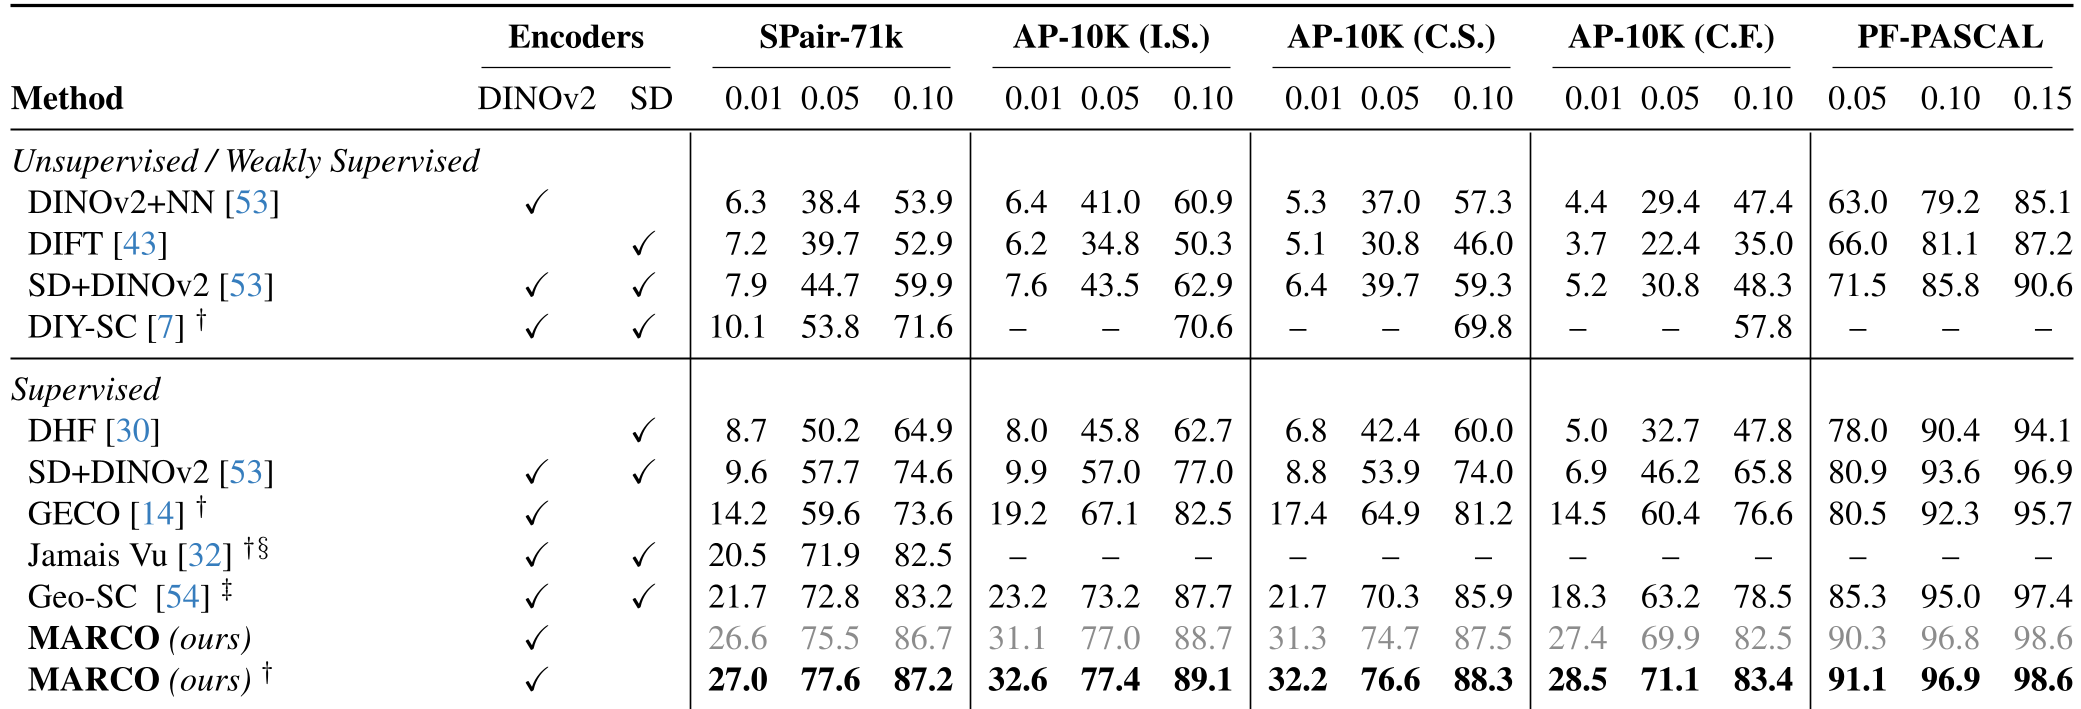 表 1:各数据集 SOTA 对比。注意 MARCO 在不同 PCK 阈值下的普适性优势。
深度洞察:为什么 MARCO 赢了?
- Inductive Bias 的正确引导:相比于直接回归坐标,MARCO 的分布式匹配目标(Gaussian RBF)能更好处理多模态分布。
- 打破过拟合:密集自蒸馏不仅提供了更多训练信号,更重要的是它强制特征空间在整个物体表面保持平滑性(Smoothness),这正是泛化性的来源。
- 效率即生产力:10 倍的提速意味着 MARCO 真正可以被部署在实时姿态估计和实时图像编辑任务中,而非仅仅躺在论文里。
总结与局限
MARCO 成功地平衡了精度、速度与泛化性。但正如作者坦言,模型仍然高度依赖高质量的初始基础特征(DINOv2)。未来的研究方向可能会进一步探索如何在完全无监督的情况下,摆脱对稀疏语义关键点的依赖,真正实现万物皆可对应。
Takeaway: 如果你想提升模型的泛化能力,不要急着加参数,先想想如何利用现有特征中的几何结构来生成更致密的自监督信号。