
MASPO:攻克多智能体协作中的“局部合规、全局失败”难题
MASPO: Joint Prompt Optimization for LLM-based Multi-Agent Systems
本文提出了 MASPO,一种针对基于大语言模型(LLM)的多智能体系统(MAS)的联合提示词优化框架。该方法通过多粒度联合评价、错位感知采样和自适应束搜索,实现了在不需要 ground-truth 标签的情况下,对复杂协作任务中的多个智能体提示词进行迭代改进,在数学、推理和代码等 6 个任务上取得了显著的 SOTA 性能提升。
TL;DR
在多智能体系统(MAS)中,提示词(Prompt)的设计决定了智能体的分工与沟通。然而,传统的提示词优化往往陷入“局部最优”的陷阱:每个智能体都按照指令行事,但整体结果却一塌糊涂。本文提出的 MASPO (Multi-Agent System Prompt Optimization) 框架,通过联合评价机制和错位案例挖掘,实现了多智能体提示词的协同演化,显著提升了系统在复杂逻辑推理中的整体表现。
痛点深挖:多智能体优化中的“信用分配”困局
在单智能体场景下,优化目标非常明确:输出是否符合预期?但在多智能体系统中,情况变得极其复杂:
- Local-Global Misalignment(局部-全局错位):中间智能体(如推理者、审阅者)的输出在局部看来是完美的,但由于其语气、格式或逻辑侧重点的细微偏差,可能导致下游智能体产生误解,最终输出错误答案。
- Non-stationarity(非稳态问题):当你在优化 Agent A 时,Agent B 的输入环境也在随之改变。这种耦合关系使得传统的独立优化方法(如 SPO)在 MAS 中表现乏力。
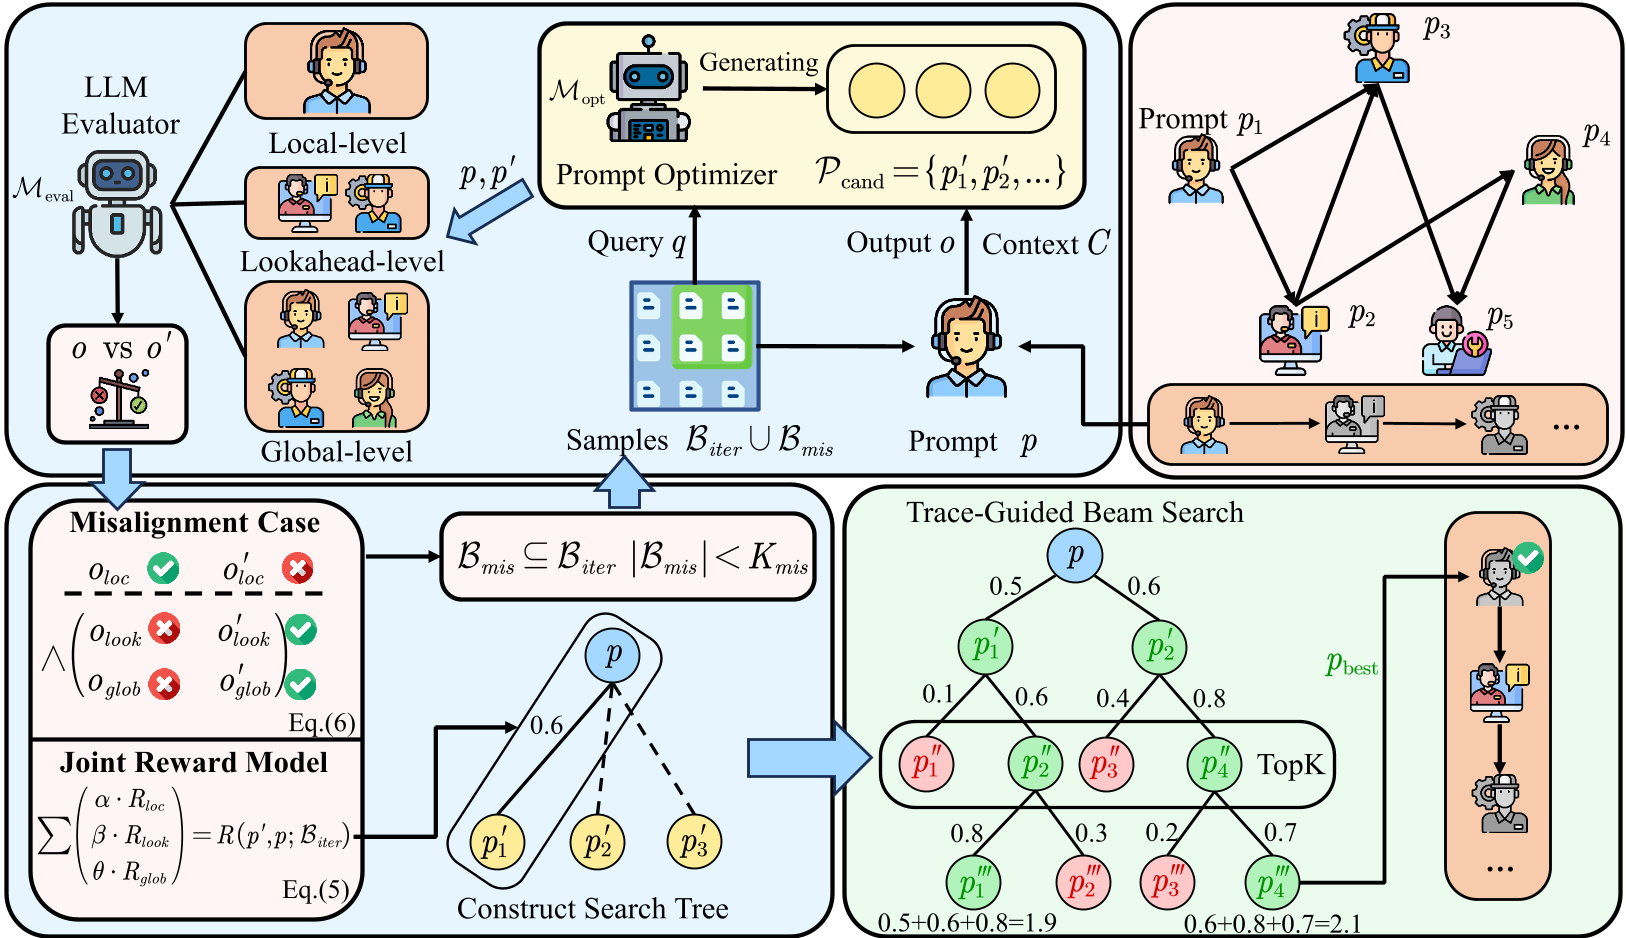 图1:MASPO 框架概览。包括拓扑调度、错位采样、联合评价和束搜索演化。
方法论详解:MASPO 的三把“手术刀”
为了手术般精准地修复智能体间的协作断裂,MASPO 设计了三套核心机制:
1. 多粒度联合评价 (Multi-Granularity Joint Evaluation)
MASPO 不再只盯着最终答案,而是通过一个加权公式来给提示词打分:
- Local Validity:智能体是否遵循了其角色的基本约束?
- Lookahead Potential (核心创新):智能体的输出是否让它的“邻居”变得更聪明了?
- Global Alignment:对最终系统输出的贡献。
通过引入 Lookahead Potential,MASPO 解决了 Credit Assignment 难题,让智能体在优化过程中自发地学会“为下游着想”。
2. 错位感知采样 (Misalignment-Aware Sampling)
作者敏锐地意识到,失败比成功更有教导意义。框架会专门收集那些 “局部表现优异但导致全局失败” 的负样本当作硬负样本(Hard Negatives)。在优化新一代提示词时,强制优化器分析这些案例,从而精准切断错误在因果链条中的传播。
3. 束刷新机制 (Beam Refresh)
由于上游智能体的行为在变,旧的候选提示词评分会“过期”。MASPO 在每一轮迭代前,会重新锚定(Re-anchor)所有的评分,清除陈旧分数,确保所有候选者都在最新的数据分布(Context)下公平竞技。
实验结果:全方位的性能碾压
MASPO 在数学(MATH-500)、逻辑推理(GPQA)和代码(HumanEval)等 6 个严苛的基准测试中展现了统治力。
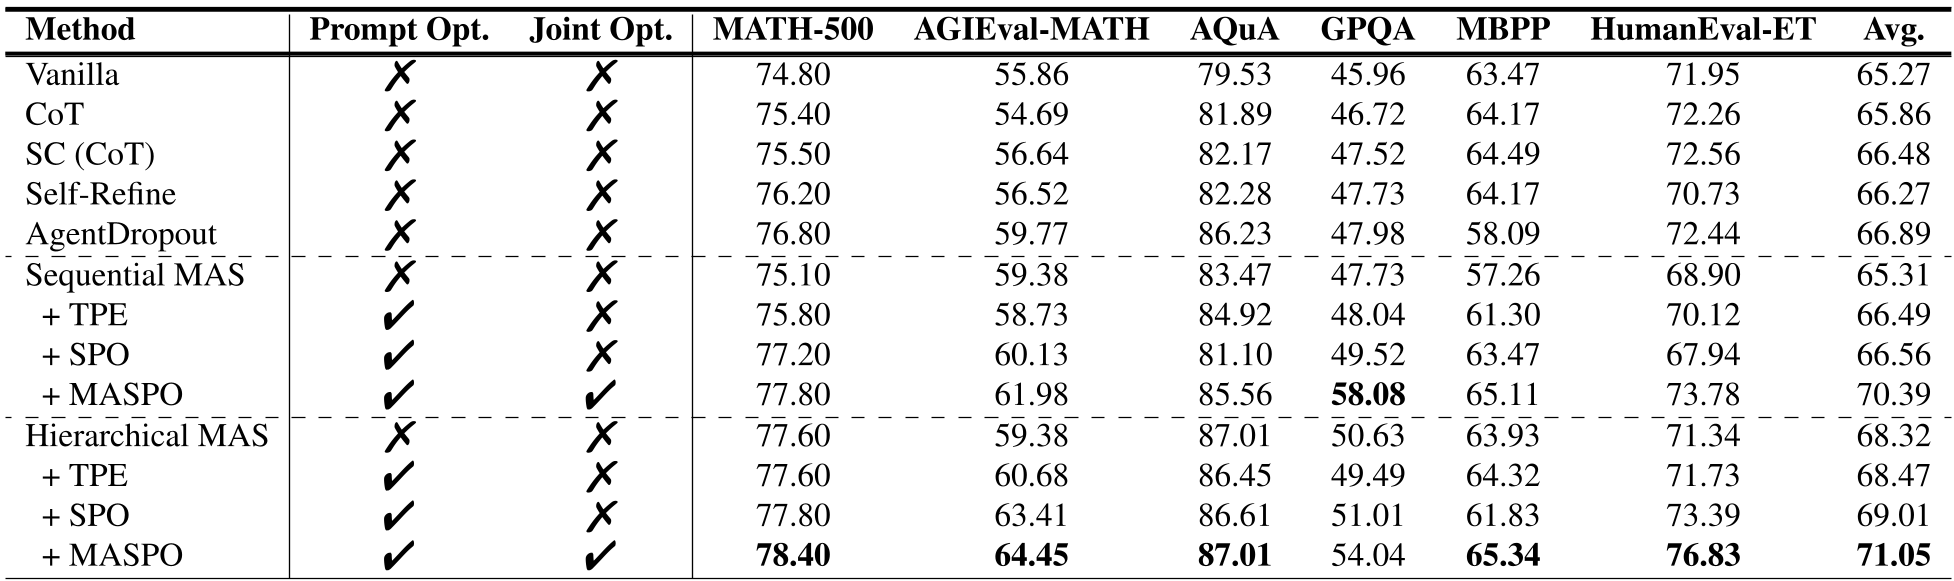 表1:MASPO 在不同任务上的表现。可见其在多智能体架构下均显著优于现有优化方法(如 TPE, SPO)。
关键发现:
- 拓扑无关性:无论是线性的 Sequential MAS 还是分层的 Hierarchical MAS,MASPO 都能平滑适配。
- 权重敏感度:实验发现,局部有效性和前瞻潜力的权重设计对稳定性至关重要,而全局对齐的权重反而可以稍低(见下图 2)。
图2:局部有效性(α)与前瞻潜力(β)的性能景观图。
深度洞察:跨模型迁移的惊喜
MASPO 最令人兴奋的特性在于其泛化性。研究者发现,在 Qwen3-8B 这种小模型上优化出来的提示词,直接丢给 DeepSeek-V3 甚至 Gemini-2.5-Pro,依然能获得显著的性能增益。这意味着:高效的机器协作逻辑在某种程度上是通用的。 开发者可以利用低成本的小模型作为“优化室”,打磨出一套精良的协作 Prompt,最后部署到昂贵的大模型集群中。
总结与局限
MASPO 为多智能体系统的“自动调参”指明了方向。它证明了:让智能体学会“看路”(Lookahead)比让它们学会“看答案”更重要。
不过,MASPO 依然依赖于一个强大的“元优化器”(如 Gemini 2.5 Pro)来生成候选提示词,且对于极深拓扑(如 10 层以上)的优化开销仍有待进一步压缩。未来,将这一机制与动态拓扑优化(Dynamic Routing)结合,或许能诞生真正意义上的“自组织 AI 兵团”。