
填补“人机鸿沟”:如何精准衡量并收窄真实与模拟用户的行为差异?
Measuring and Mitigating the Distributional Gap Between Real and Simulated User Behaviors
本文提出了衡量真实用户与模拟用户行为分布差异的方法,构建了包含 24 个大模型观测器的评估体系。通过对 Coding 和 Writing 任务的系统评估,揭示了大语言模型(LLM)作为用户模拟器时与真实人类行为之间存在的显著分布鸿沟(Distributional Gap)。
TL;DR
尽管 LLM 看起来越来越像人,但在模拟人类行为的历史长河中,它们真的抓住了人类行为的多样性吗?UIUC 与微软、伯克利的研究团队发表在 NeurIPS 的这项工作提供了一个严谨的框架,通过描述提取-量化聚类-散度测量的流程,量化了 24 种 LLM 模拟器与真实 WildChat 数据集中的行为分布差异。结果显示:即便是最强模型如 GPT-5.4,在模拟人类的简练、权威或反复无常的行为方面依然捉襟见肘。
痛点深挖:表面相似 vs. 统计忠实
传统的用户模拟器评估往往陷入了“图灵测试”的陷阱:只要模拟器的一句回答看起来像人就算成功。然而,对于训练 AI Assistant 而言,**分布(Distribution)**才是关键。
- 低召回 (Low Recall):模拟器只表现出“客气、详细”的理想行为,却漏掉了真实用户中大量的“语焉不详”或“极度简练”。
- 幻觉行为 (Hallucinated Behaviors):模拟器表现出真实人类几乎不会有的“过度热情”和频繁的社交辞令。 如果训练数据缺失了某种行为模式,最终的 AI 助手在现实场景中就会面临泛化失败的可能性。
方法论详解:行为的“离散量化”
为了从复杂的对话流中提取纯粹的“行为”,作者设计了一个三阶流水线:
- 多维度行为解构 (Behavioral Facets): 不仅看说了什么,更要看怎么说的。通过 6 个维度(Requests, Responses, Context, Communication Style, 以及 DAMSL/SGD 动作标签)由 LLM 生成总结性描述。
- 向量化与聚类: 利用 Embedding 模型将上述描述映射到语义空间,并通过 K-Means 将其聚类成 个“行为模式(Modes)”。
- 分布散度度量:
利用真实分布 和模拟分布 之间的 KL 散度来定义精度和召回率。
- Forward KL ():衡量模拟器漏掉了多少人类行为(Recall)。
- Backward KL ():衡量模拟器产生了多少非人类行为(Precision)。
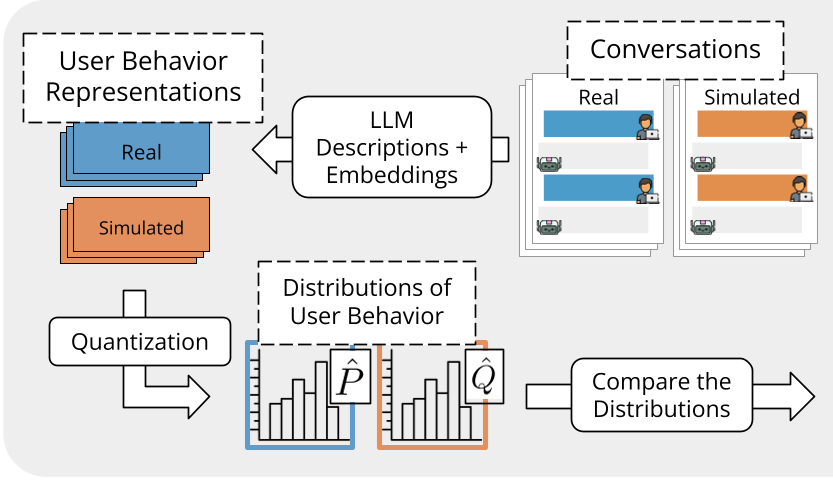 图 1: 通过行为表征提取与聚类,直观展现了 Gemini 与 Llama 模型在分布重叠度上的差异。
实验与结果:规模不是万能药
研究者通过对 24 个模型(包括闭源巨头、开源 LLM 以及专门训练的 UserLM)的测试,得出了几个颠覆直觉的结论:
- 性能梯队:GPT-5.4 和 Gemini 3.1 Pro 处于领跑位置,但专门针对行为对齐微调的小模型(如 UserLM-8b)在特定任务上竟然能与千亿级闭源模型平起平坐。
- 任务敏感性:Coding 任务由于逻辑性强且目标明确,相对容易模拟;而 Writing 任务中人类表现出的极大风格差异,让所有模拟器集体“破防”。
- 规模悖论:在某些模型系列中,较大的模型行为分布反而不如针对性微调的小模型。
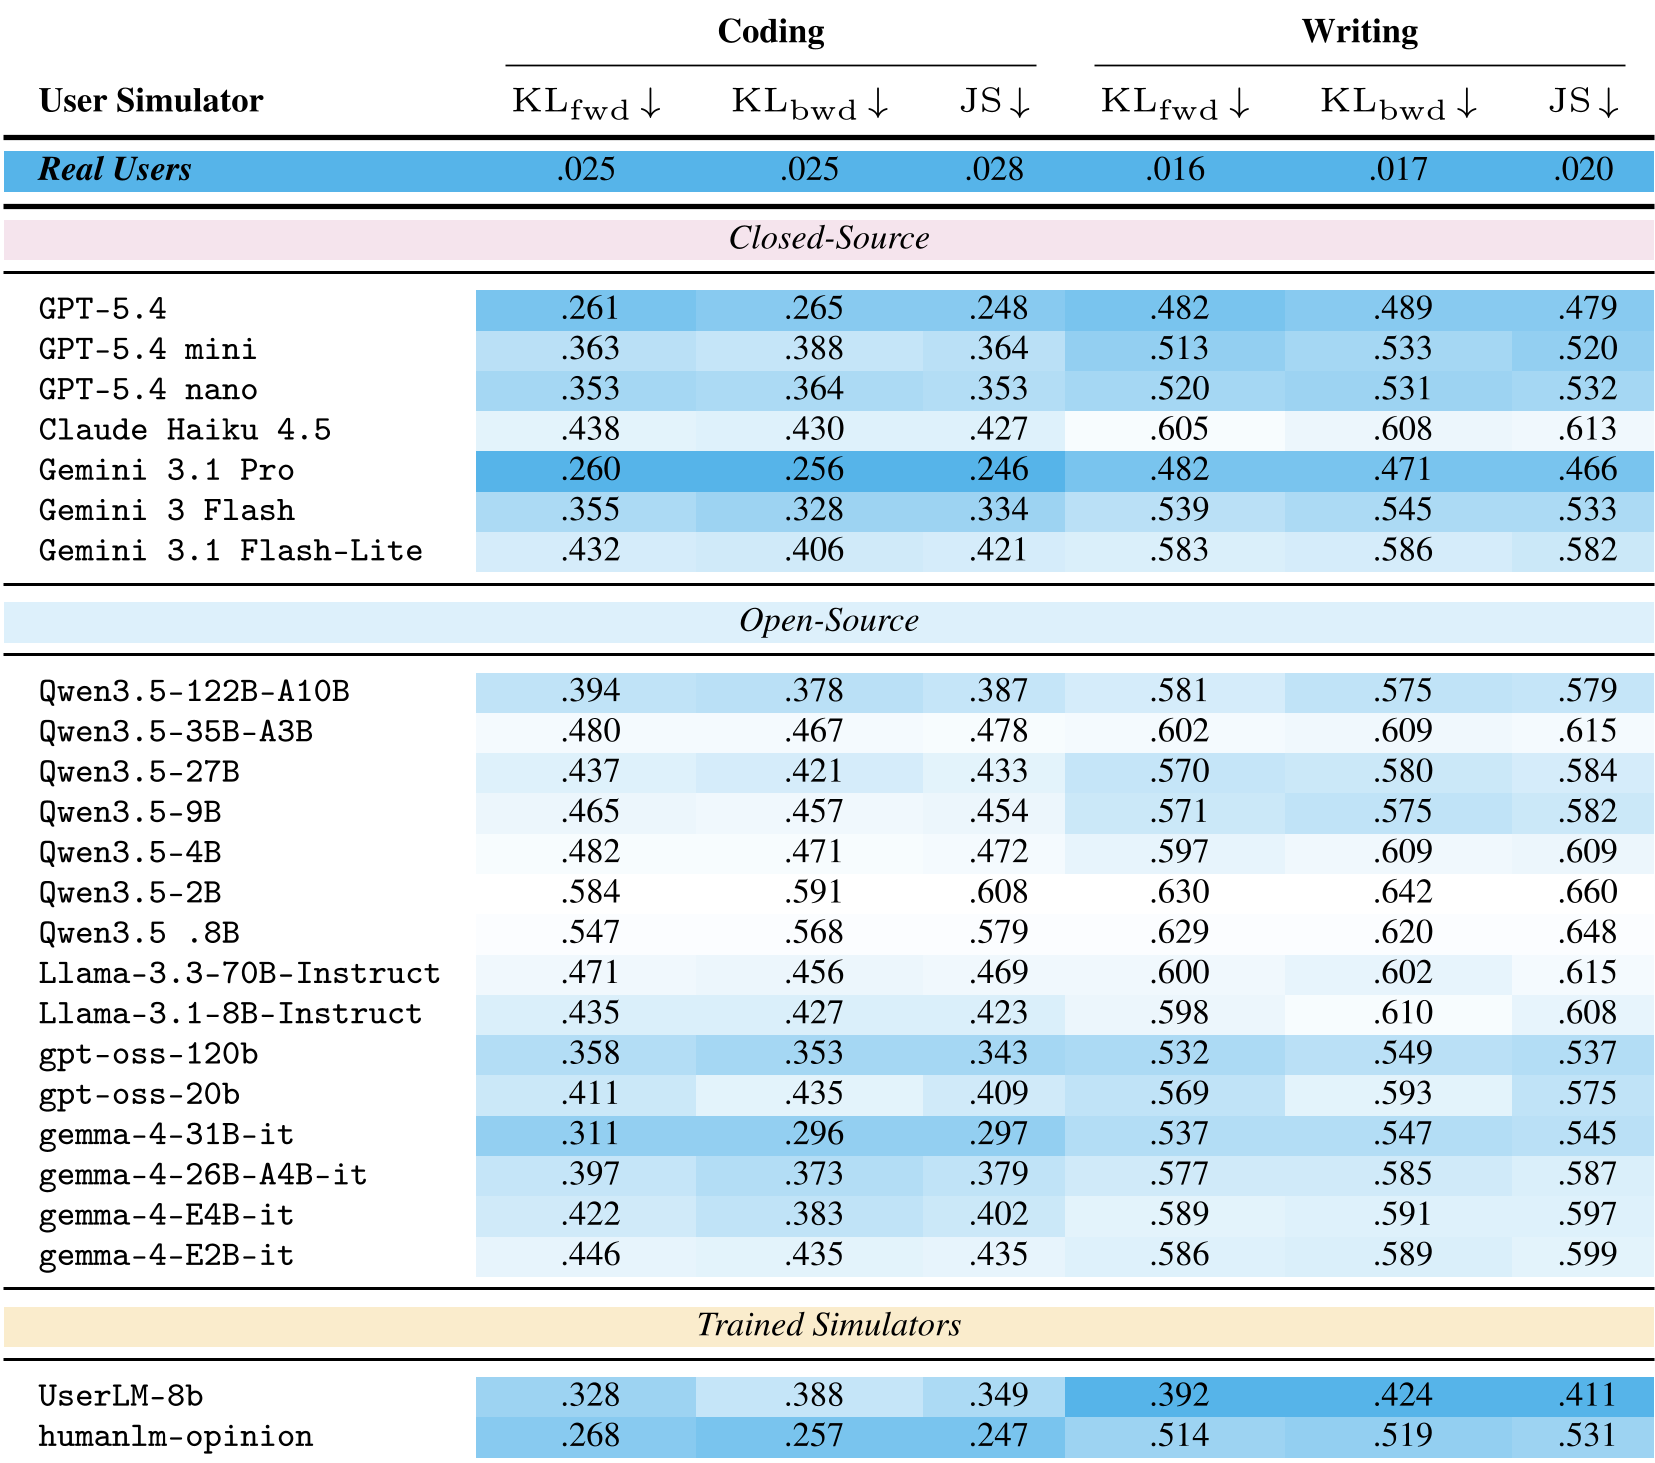 表 1: 不同模拟器在编码和写作任务上的分布式指标对比,展现了明显的 SOTA 指标差异。
深度发现:模拟器在“表演”人类
通过 TF-IDF 对聚类结果进行可解释分析(Word Clouds),研究者发现了一个有趣现象:
- Well-captured:模型能很好模拟“报告错误”、“寻求替代方案”等逻辑严密的行为。
- Missed:模型最难模仿人类那种“粗鲁”的、极其短促的(Terse)以及纯事务性的指令。
- Hallucinated:模型过度展示了“Wow, awesome!”、“Thanks a lot!”这类社交软化语。
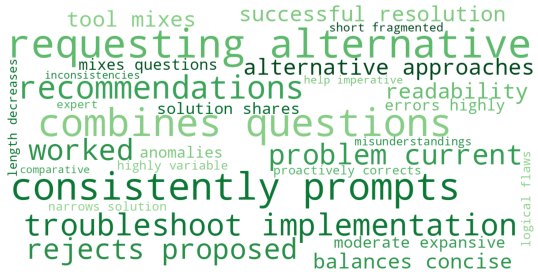 图 2: 关于 Gemini 3.1 Pro 在编码任务中捕捉、缺失与幻觉出的行为词云图。
深度洞察与总结
这项工作最有价值的启示在于:“行为互补性”。 实验证明,将 GPT-5.4 与 Gemini 或 UserLM 进行随机混合,其生成的行为分布会比单一模型更接近真实人类。这暗示了在模拟高度异质化的人类群体时,多专家混合(MoE)或者策略化的模型路由(Routing)可能是唯一的出路。
局限性: 目前的方法高度依赖于“提取器 LLM”的性能(本文使用的是 Qwen 3.5 122B)。如果用于分析结果的模型本身就具有行为偏置,可能会在聚类阶段引入系统性误差。
总之,这篇论文为构建“更像人的模拟器”确立了新的度量标尺,提醒我们:真正的智能不仅在于解决问题的能力,更在于复现人类那种非理想、甚至是不完美的多样性分布。