
MedHorizon:在 759 小时临床“废片”中捞取 0.1% 的救命证据
MedHorizon: Towards Long-context Medical Video Understanding in the Wild
本文推出了 MedHorizon,一个针对野外真实临床全过程的长视频理解基准。该基准包含 759 小时的全手术/检查视频和 1,253 道经过验证的多选推理题,目前表现最好的 Gemini-3.1-Pro-Preview 准确率仅为 41.1%。
TL;DR
在通用 AI 领域,处理长视频通常意味着理解电影情节或体育比赛;但在医疗领域,这意味着要在长达 30 小时的肠镜或手术视频中,精准捕捉到那一秒钟、仅占画面百分之一的病灶。本文提出的 MedHorizon 是首个挑战这种“大海捞针”式临床全过程理解的基准测试。实验证明,即使是最先进的 GPT-5.4 或 Gemini-3.1,面对这种极高视觉冗余、极低有效信息的挑战,依然表现得像个“新手”。
核心痛点:为什么医疗长视频是 MLLM 的“噩梦”?
目前的医疗多模态大模型(MLLM)在单张影像诊断上已颇有建树,但在真实临床复核中,我们需要模型像医生一样看完整个手术。
作者指出医疗长视频的三大“毒性”:
- 极度稀疏的证据 (Extremely Sparse):平均关键帧仅占 0.166%,比通用视频基准稀疏 169 倍。
- 高度视觉冗余 (High Redundancy):相邻帧的解剖结构几乎一模一样,导致模型产生“注意力漂移 (Attention Drift)”。
- 多跳逻辑依赖:诊断往往需要结合“在 A 位置看到病灶”、“在 B 阶段使用了止血夹”进行多时段聚合推理。
MedHorizon:基准构建的硬核逻辑
作者建立了一个包含 340 段视频(涵盖手术、内窥镜、超声等 7 类器官场景)的庞大语库,最大的亮点在于其 证据归因流水线 (Evidence-grounded Pipeline)。
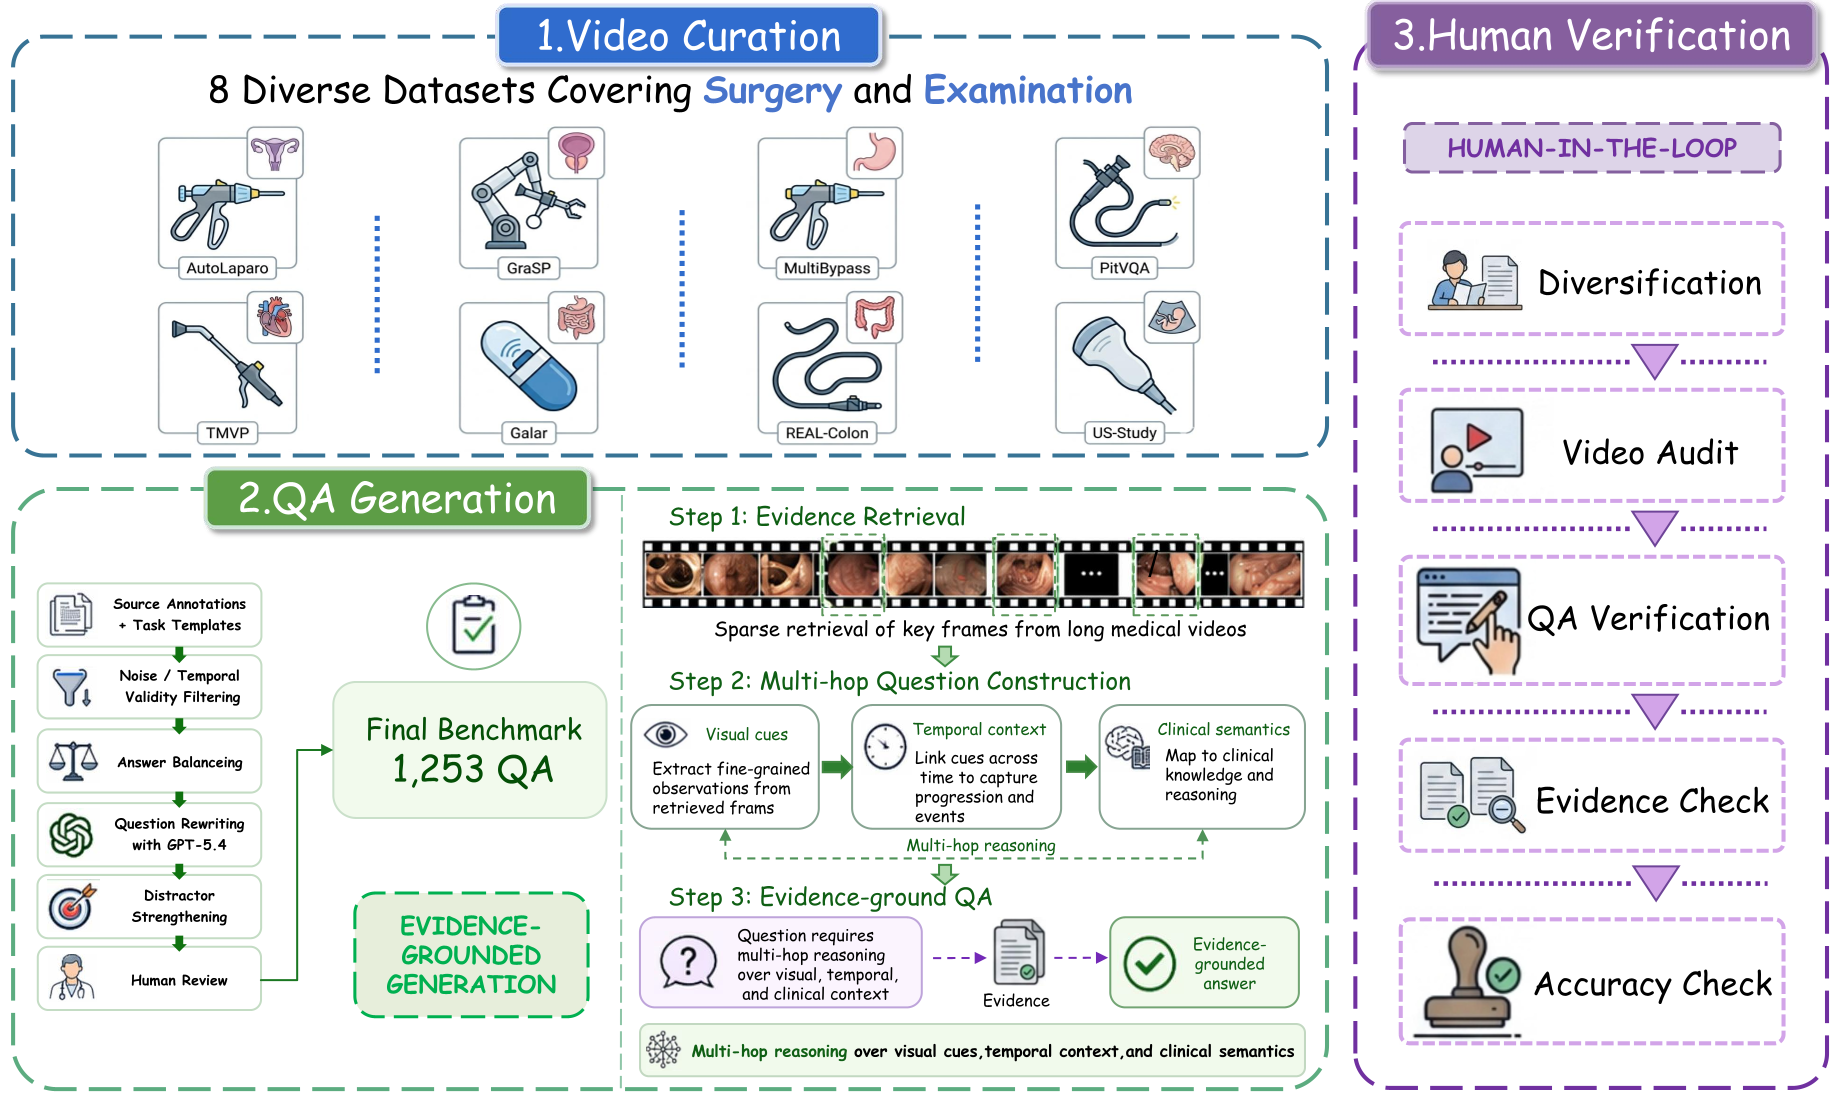
不同于以往“看图说话”的简单 QA,MedHorizon 设计了层层进阶的评测维度:
- 细粒度理解:识别手术阶段(PR)、定位解剖区域(RL)。
- 语义推理:包括一跳的工具识别(IR)、两跳的步骤排序(RSR),以及最具挑战性的三跳聚合推理——如计算某种病灶在全过程中的分布比例(CPR)。
深度诊断:加帧数真的管用吗?
作者对现有模型进行了“压力测试”,得出了三个反直觉的结论:
1. 扩缩失效 (Scaling Failure)
在通用模型中,采样帧数越多性能通常越好。但在医疗长视频中,增加帧数反而可能引入更多冗余干扰。如下图所示,MedGRPO 原本随着帧数增加准确率反而下降,这说明模型迷失在了相似的解剖图像中。

2. 注意力漂移 (Attention Drift)
模型无法集中精神。通过注意力图谱分析发现,当模型处理医疗视频时,注意力极其分散(Diffusion),大量注意力被分配给了毫无临床意义的冗余帧,而真正包含病灶的帧却没有获得显著的权重提升。
3. 时间顺序的“伪理解”
当作者将视频帧顺序打乱、翻转或局部洗牌时,模型的性能下降微乎其微。这揭示了一个令人不安的事实:现有的模型在处理医疗视频时,更多是靠“识别局部特征”在蒙答案,而没有真正建立起对临床流程(Workflow)的时间轴建模。
实验金标准:SOTA 对比
下表清晰展示了各流派模型在 MedHorizon 上的溃败。Gemini-3.1-Pro 虽以 41.1% 领跑,但在最难的临床分析(LA)任务中几乎交了白卷。

行业启示与未来展望
MedHorizon 的出现宣告了靠“暴力增加上下文”来解决医疗长视频问题的终结。作者的实验提示我们,未来的研究方向应聚焦于:
- 医疗先验感知的采样:不再是均匀抽样,而是根据视觉动态或解剖标志点进行智能检索。
- 显式的流程建模:强迫模型理解手术的阶段顺序,减少注意力在冗余帧之间的“漂流”。
这项工作为 MLLM 在真实临床环境中的部署设定了一个极具挑战性的目标:在嘈杂的、野外的长视频流中,像人类专家一样具备“检索-解释-聚合”的闭环能力。