
MELT:解耦算力与显存,开启常数级显存的深度迭代推理新纪元
Memory-Efficient Looped Transformer: Decoupling Compute from Memory in Looped Language Models
本文提出了 MELT (Memory-Efficient Looped Transformer),一种专为循环语言模型设计的显存优化架构。通过引入可学习的门控机制更新单层共享 KV Cache,MELT 成功将推理显存占用与推理步数(循环深度)解耦,在保持模型规模不变的情况下实现了高效的隐式推理。
TL;DR
在 AI 推理领域,增加推理步数通常意味着更高的显存消耗。Qualcomm AI Research 提出的 MELT (Memory-Efficient Looped Transformer) 彻底打破了这一诅咒。通过一种创新的门控更新机制,MELT 实现了推理深度增加而显存保持不变( 复杂度),在 1.6B 参数下展现出了超越传统 2B 级模型的强大推理性能。
背景:循环模型的“显存瓶颈”
当前的 LLM 正从“训练量缩放”转向“推理侧缩放”(Inference-time Scaling)。除了常见的思维链(CoT)生成中间 Token 外,循环 Transformer(Looped Transformers) 允许模型在隐藏空间内多次重复通过同一层参数进行“深思熟虑”。
然而,像 Ouro 这样的前沿模型面临一个致命缺陷:随着循环深度 的增加,KV Cache 会随之线性累积。这使得模型在处理复杂逻辑题时,即便参数量很小,也会因为 KV Cache 占满 VRAM 而无法处理长文本。
核心创新:从“追加”到“更新”
MELT 的直觉非常清晰:为什么我们要存储每一轮循环的 KV?难道不能像 RNN 更新隐状态那样,只维护一份最新的、最有意义的 KV 吗?
1. 架构:门控动力学 (Gated Dynamics)
MELT 并没有简单地抛弃旧 KV,而是引入了一个可学习的潜状态 。在每一轮循环中,模型利用门控信号 决定保留多少旧信息、吸纳多少新信息: 这种设计将显存复杂度从 降回了 。
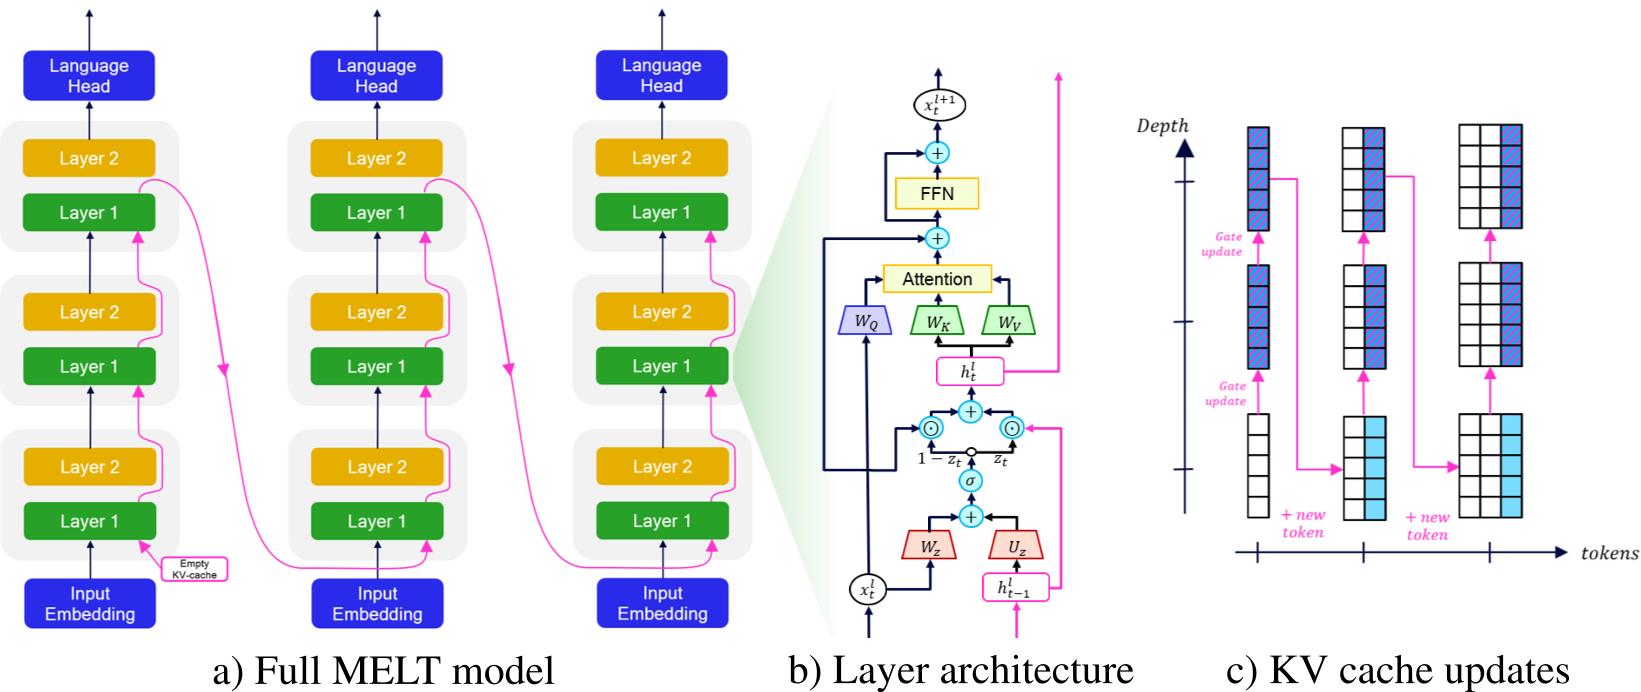 图 1:MELT 架构概览。注意ピンク(粉红色)箭头展示了 KV Cache 如何在不同 token 间流动,而在同一 token 的不同循环中则是被动态更新而非堆叠。
2. 训练:如何让模型学会“覆盖”?
由于改变了 KV 结构,直接冷启动训练非常困难。作者设计了一套复杂的“外科手术式”微调方案:
- 分块训练 (Chunk-wise Training):通过切分 Token 序列,平衡训练效率与推理时的自回归一致性。
- 插值过渡 (Interpolated Transition):引入系数 ,让模型从原始 LoopLM 逐渐缓慢过渡到 MELT 架构。
- 注意力对齐蒸馏:利用冻结的 LoopLM 作为老师,强制 MELT 的注意力输出(Post-attention)在每一层、每一轮循环都与老师对齐。
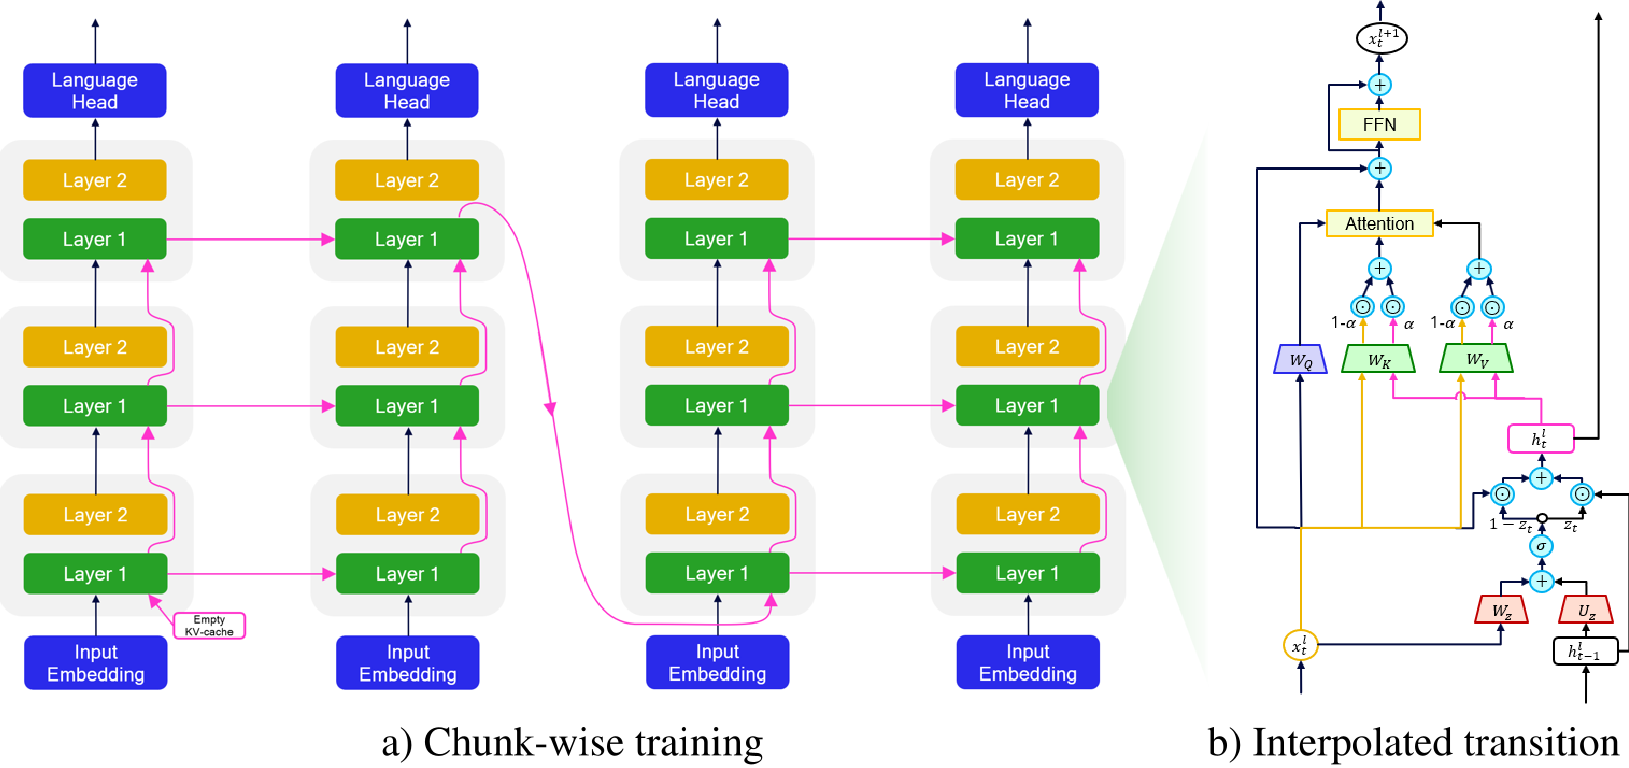 图 2:插值过渡与分块训练示意图,确保了从旧架构到新架构的无损迁移。
实验战绩:小轻快,但也更强
在 AIME24/25/26 等具有极高挑战性的竞赛数学榜单中,MELT-1.6B 的表现非常抢眼:
- 性能:它的平均数学得分(59.9)远超 Qwen3-1.7B(56.9)和 DeepSeek-R1-1.5B(46.9)。
- 显存:在 32k 上下文长度下,MELT 的显存占用仅为 9.49GB,而原始循环模型 Ouro 需要惊人的 27.97GB。
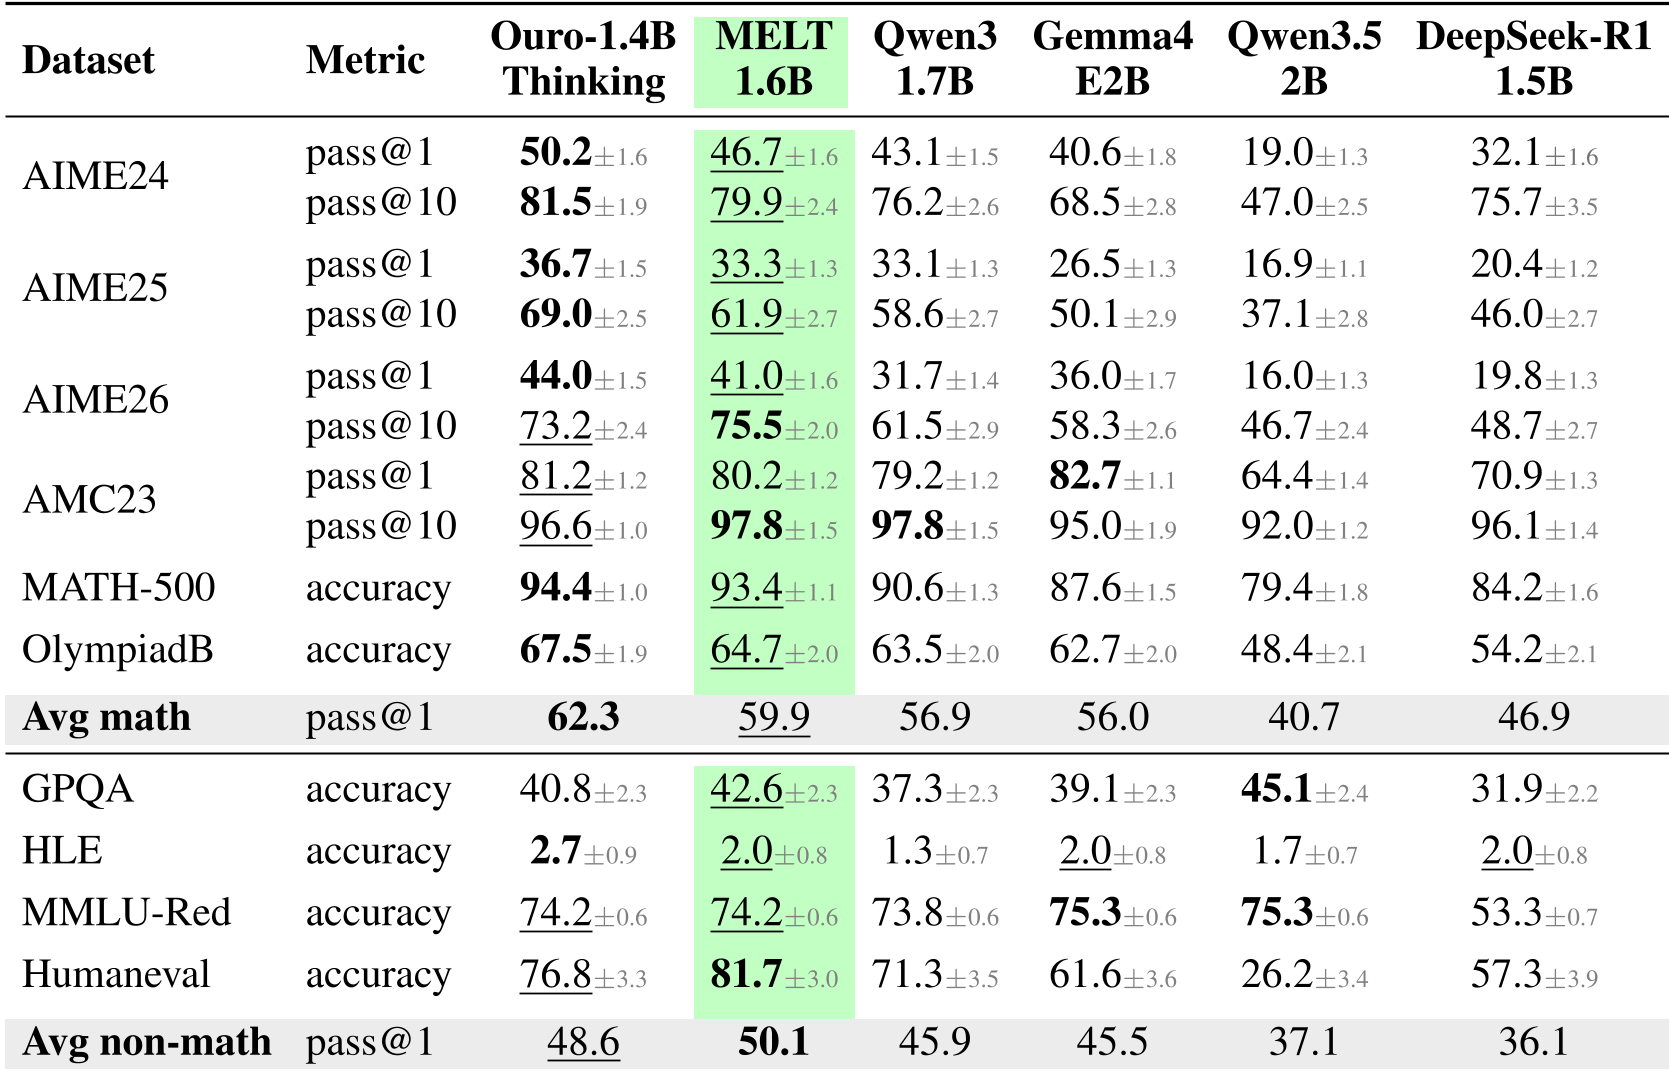 表 1:MELT 与各大主流小尺寸模型的性能对比,展现了其在数学推理上的统治力。
深度洞察:为什么 MELT 能奏效?
作者在附录中给出了数学上的解释:通过门控机制,MELT 实际上建立了一条**“梯度高速公路”(Gradient Superhighway)**。当门控饱和时(),雅可比矩阵接近单位阵,这使得梯度可以无损地穿透极深的循环层,解决了传统 RNN 容易出现的梯度消失问题。
总结与局限
MELT 是业界首个证明“深度迭代推理”可以与“常数级显存”并存的工作。尽管目前它还不支持多查询注意力(MQA),且每一轮循环步数在推理时是固定的,但它为未来实现自适应推理深度(Adaptive Depth)打下了坚实的架构基础。
对于想要在手机、电脑等本地设备上部署强力理由模型的开发者来说,MELT 展现出的 显存特性无疑是目前最完美的解决方案之一。