
[2026 技术前瞻] Meta-TTRL:开启 UMM 自进化时代,让文生图模型在测试时“边做边学”
Meta-TTRL: A Metacognitive Framework for Self-Improving Test-Time Reinforcement Learning in Unified Multimodal Models
本文提出了 Meta-TTRL,这是首个针对统一多模态模型(UMM)文生图任务的元认知测试时强化学习框架。该方法通过模型内部的元知识生成监控信号来优化测试时参数,在 Janus-Pro、BAGEL 和 Qwen-Image 等多个 SOTA 模型上显著提升了组合推理能力。
TL;DR
传统的文生图模型在生成时就像是在做“一次性买卖”,即便通过增加采样次数提升了质量,模型本身并没有变得更聪明。Meta-TTRL 改变了这一现状:它首次将测试时强化学习(TTRL)引入统一多模态模型(UMM),通过模型自有的元认知能力指导参数微调。实验显示,这一框架能显著增强模型在空间、数量和纹理等复杂组合推理任务中的表现,让模型具备了“自我进化”的能力。
背景定位:从 Test-Time Scaling 到 Test-Time Learning
在 AI 领域,Scaling Law(缩放定律)不仅存在于训练阶段,在推理阶段(Test-time)同样有效。目前的 TTS 方法如 Best-of-N 采样或迭代细化,虽然能提升当前图片的质量,但属于“治标不治本”——模型参数未动,知识没有累积。
Meta-TTRL 的核心野心是实现 Capability-level Improvement(能力级提升)。它不仅要生成一张好图,还要让模型在处理完这个 Prompt 之后,变强到足以应对后续所有类似的请求。
核心直觉:元认知协同 (Metacognitive Synergy)
为什么不直接用一个更大的模型(如 GPT-4o)来当老师教小模型?作者发现了一个有趣的现象:强力外援未必是好老师。
实验证明,如果监控信号超出了基础模型的优化范畴(即信号不匹配),学习效率反而会下降。Meta-TTRL 提出的“元认知协同”认为:最好的奖励信号来自于模型内部。 只有当模型的“理解力”能精准识别出“生成力”的错误时,才能触发最有效的参数更新。
方法论:双层架构与监控-控制环
Meta-TTRL 的运行机制可以抽象为一个四步走的闭环过程:
1. 元级准则构建 (Rubric Construction)
模型先“自省”,将复杂的 Prompt 分解为具体的维度(对象、属性、计数、空间关系等),生成一组 Yes/No 的验证问题。
2. 对象级生成
模型作为生成器,产生一组(G 个)候选图片。
3. 内部监控 (Intrinsic Monitoring)
模型切换到“内省者”模式,利用自身的 VQA(视觉问答)能力,根据第一步构建的准则给这组图片打分。
4. 策略控制 (Policy Control)
使用 GRPO (Group Relative Policy Optimization) 算法。它不看绝对分,而是对比同一组内图片的相对优劣。表现好的图会引导梯度更新,促使模型改进生成策略。
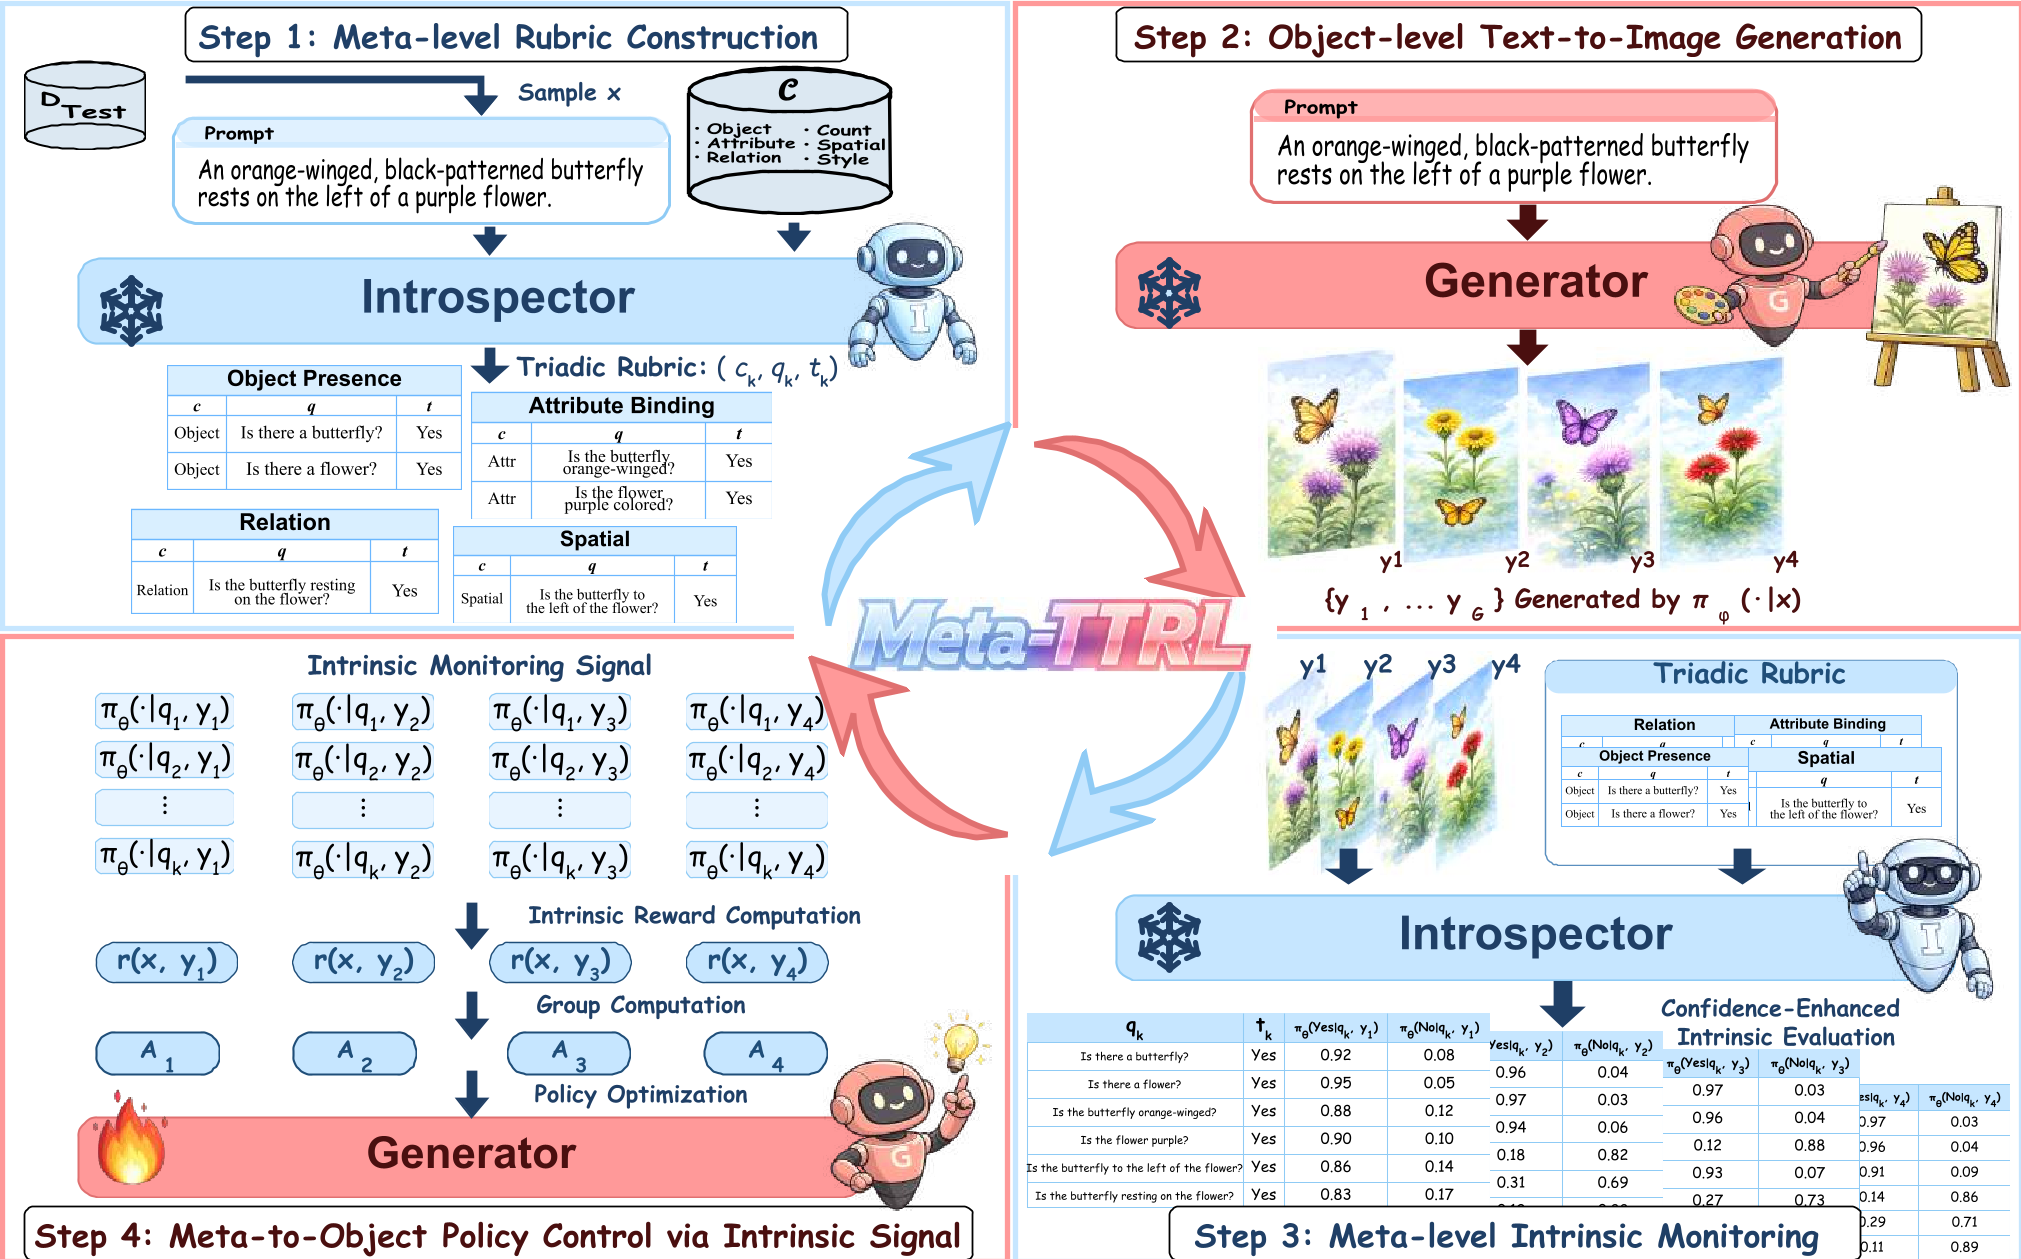 图 1: Meta-TTRL 的四个步骤,展示了从准则构建到梯度更新的完整闭环。
实验战绩:化腐朽为神奇
Meta-TTRL 在 Janus-Pro-7B 这一基线模型上的表现最为惊人。在 T2I-CompBench++ 测试中,它在原本薄弱的 2D 空间推理任务上提升了 106.36%,在颜色和纹理任务上也实现了超过 50% 的飞跃。
 表 1: 在三个主流基准测试中,Meta-TTRL 均展现了显著的性能增益,尤其是较弱的基座模型受益最大。
深度洞察:为什么不选 UnifiedReward 等成熟奖励模型?
作者做了一组有趣的对照实验(图 5),发现 Meta-TTRL 的内部奖励信号竟然优于专门训练的外部奖励模型。
- 理由:外部奖励模型可能存在“分布偏移”,而内部信号天生与模型的 Embedding 空间更加契合,避免了强化学习中常见的“奖励作弊(Reward Hacking)”现象。
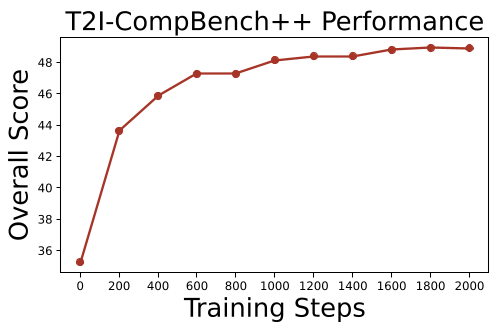 图 2: 随着训练步数的增加,内部奖励与实际 Bench 所测得分同步增长,证明了信号的有效性。
总结与展望
Meta-TTRL 的成功证明了,多模态模型的预训练参数中潜藏着巨大的“自愈”潜力。
- 未来的启示:我们可能不再需要无休止地堆砌超大规模的训练集,而是通过设计精巧的自省机制,让模型在部署后的每一次交互中动态进化。
- 局限性:目前该方法需要访问权重(White-box),对于闭源 API 模型尚无法直接应用。未来的研究方向或许是如何通过 Prompt Engineering 或知识蒸馏将这种自进化能力外溢到闭源模型中。
资深主编点评:本工作最深刻的直觉在于强调了“能力匹配”的奖励信号。在追求 AGI 的道路上,Meta-TTRL 展示了“反求诸己”可能比“外求导师”更能触及模型能力的边界。