
[ICLR 2026] MetaClaw:让 Agent 在野外自主进化的持续元学习框架
MetaClaw: Just Talk – An Agent That Meta-Learns and Evolves in the Wild
本文提出了 MetaClaw,一个面向部署环境的 LLM Agent 持续元学习框架。该框架通过结合基于提示词的“技能驱动快速演进”和基于 RL 的“机会主义策略优化”,使 Agent 能够在真实的非平稳任务流中自主进化,在 MetaClaw-Bench 上将 Kimi-K2.5 的任务完成率提升了 8.25 倍。
TL;DR
传统的 LLM Agent 在部署后通常是“冻结”的,面对不断变化的实际任务容易显得力不从心。MetaClaw 提出了一种创新的持续元学习范式:它像人类一样,既能在失败后迅速总结出一套“避坑指南”(技能演进),也能在闲暇深夜默默“苦练内功”(参数微调)。这种双螺旋式的进化能力,使得即使是性能稍弱的模型,也能在实际使用中快速进化到 SOTA 级别。
痛点深挖:静态 Agent 难以应对动态世界
在 OpenClaw 等真实平台上,Agent 每天面对的任务分布会剧烈漂移。例如,用户本周还在处理文件系统操作,下周可能就转向大规模邮件工作流。
现有方法存在三大硬伤:
- 冗余性:简单的记忆存储(Memory-based)只是在堆砌原始轨迹,缺乏跨任务的可复用性。
- 割裂性:现有的技能库方法将“提示词技能”与“模型权重”视为孤岛,无法形成互补。
- 可用性:在线微调通常意味着昂贵的 GPU 开销或服务停机,这对 24/7 运行的个人助理来说是不可接受的。
核心机制:MetaClaw 的双尺度演进
MetaClaw 的核心在于将 Meta-Model 拆分为两个维度进行协同演进:
1. 技能驱动的快速适应 (Skill-Driven Fast Adaptation)
当 Agent 任务失败时,它会立即调用一个“演变器(Evolver)”来分析失败原因,并将其转化为一条通用的 Markdown 技能(例如:“在修改文件前必须先备份 .bak”)。
- 即时性:通过 Prompt 注入,无需微调,零延迟生效。
- 泛化性:从一次失败中提炼的规则,可以瞬间覆盖后续所有同类任务。
2. 机会主义策略优化 (Opportunistic Policy Optimization)
为了让模型底层逻辑更稳健,MetaClaw 会在后台积累“高质量数据”。但这里有两个精妙的设计:
- OMLS 调度器:它会盯着你的 Google Calendar、键盘活跃度和睡眠时间,趁你不在的时候偷偷在云端跑 LoRA 训练(基于序列策略优化算法 GRPO)。
- 版本隔离机制:这是一个严谨的学术设计。系统会严格区分“旧技能背景下的失败数据”和“新技能下的成功轨迹”,通过版本标记自动清洗掉会造成训练污染的陈旧样本,确保 RL 始终是在优化“已经适应后的行为”。
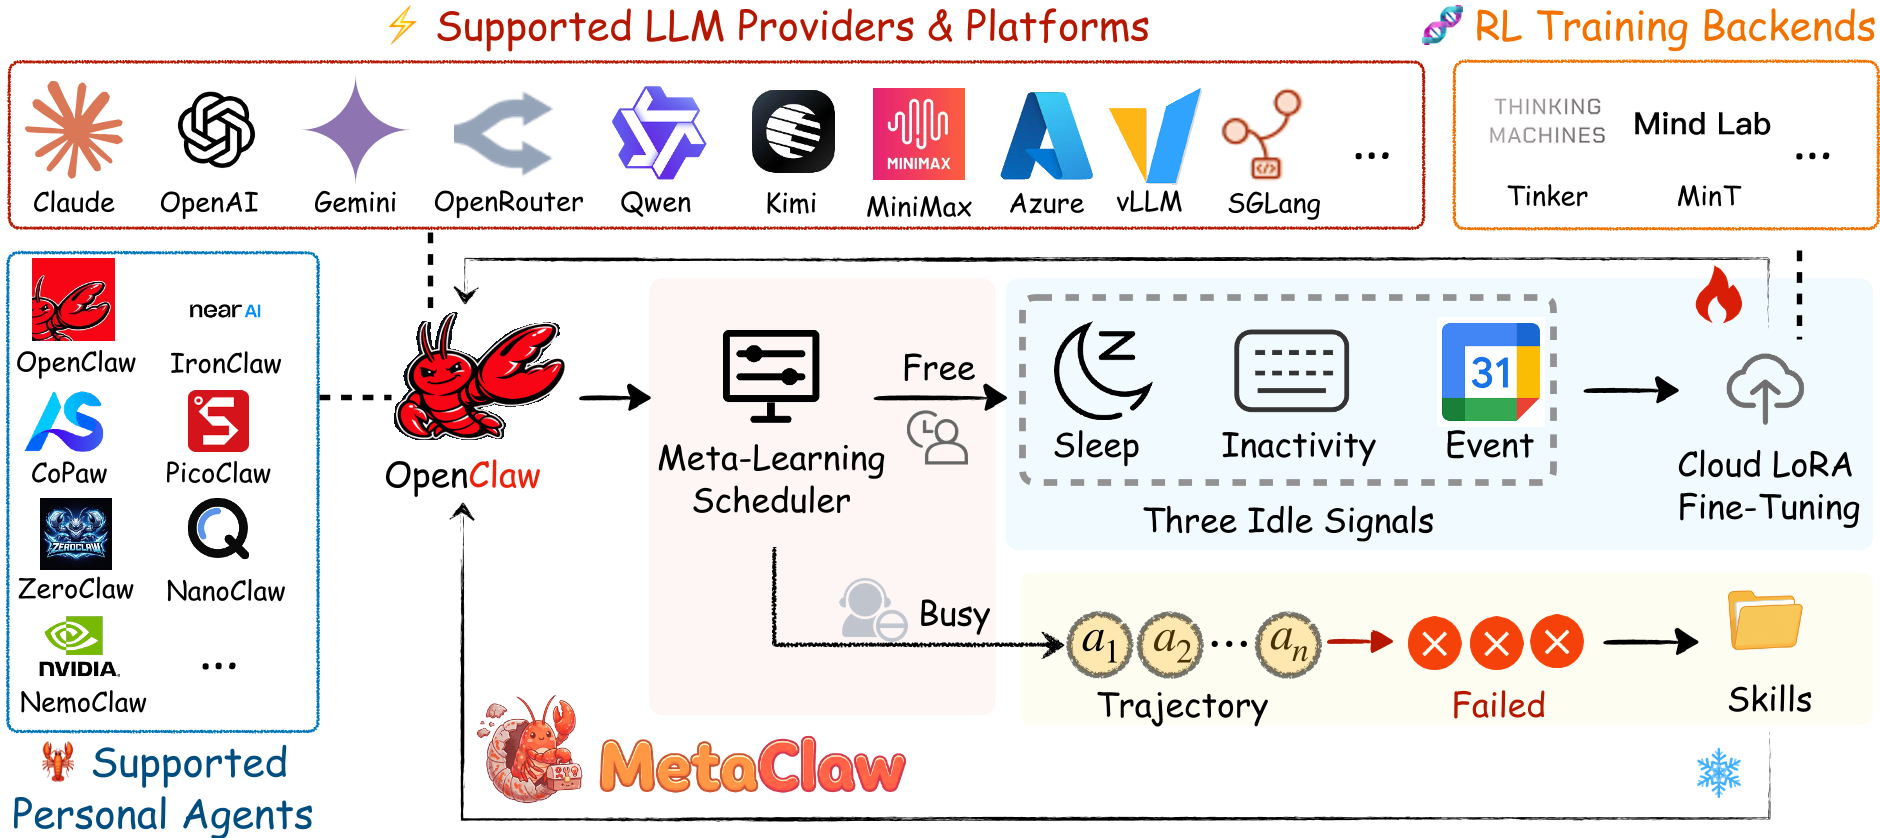 图 1:MetaClaw 的双环进化逻辑:左环通过失败分析实现技能瞬时演进,右环利用用户空闲期进行参数微调。
实验与战绩:弱模型的逆袭
论文在包含 44 个模拟工作日的 MetaClaw-Bench 上进行了极具挑战性的测试。
- 性能飞跃:Kimi-K2.5 在经过 MetaClaw 的全流程进化后,准确率从 21.4% 翻倍至 40.6%,几乎追平了顶级闭源模型 GPT-5.2 的出厂水平。
- 端到端突破:单纯的技能辅助(Skills-only)虽然能提高正确率,但只有结合了 RL 权重优化(Full),模型才能在复杂的 CLI 多步操作中展现出极高的“执行可靠性”。
- 跨领域泛化:在全自动学术研究任务(AutoResearchClaw)中,MetaClaw 无需任何领域微调,直接将系统的复合鲁棒性提升了 18.3%。
 表 1:各模型在不同配置下的性能对比,可见 MetaClaw (Full) 对 Kimi-K2.5 的巨大提振。
深度洞察:为什么 MetaClaw 有效?
MetaClaw 验证了一个深刻的直觉:技能(Skills)提供了显性的确定性规则,而策略(Policy)提供了隐性的执行直觉。
在实验中可以看到,技能库在进化早期(前 8 天)起主导作用,快速纠正诸如“ISO 8601 时间格式”这类显式错误。而随着 RL 训练在第 8 天左右完成权重热替换(Hot-swap),Agent 展现出一个明显的性能拐点(Inflection Point),这标志着模型已经从“背诵规则”进化到了“内化规则”。
局限与展望
尽管 MetaClaw 实现了高度的自动化,但 OMLS 对用户空闲期的检测仍依赖于用户日历等隐私配置,在极其高频使用的场景下可能缺乏足够的训练窗口。未来,如何利用边缘计算在本地更高效地消化这些演进梯度,将是该领域的一大看点。
总结:MetaClaw 为我们描绘了一个“越用越好用”的 Agent 未来——它不再是被工厂预定义的死板程序,而是一个能伴随用户工作习惯共同生长的智能体。