
填补评估空白:从 10,000 份学生提交看 AI Tutor 的真实有效性
The Missing Evaluation Axis: What 10,000 Student Submissions Reveal About AI Tutor Effectiveness
本文提出了一个结合“教学法质量”与“学生参与度行为”的双维 AI Tutor 评估框架。通过分析 UC Berkeley 超过 10,000 份学生编程提交记录,研究对比了 BaselineTutor 和引入错误认知识别的 MisconceptionTutor,证明了行为数据在衡量 AI 辅导有效性方面的核心价值。
TL;DR
在 AI 辅助教育领域,我们往往过度关注“AI 说了什么”(教学法质量),却忽略了“学生做了什么”。本文通过对 UC Berkeley 大规模课程数据的深度挖掘,提出了一套基于学生行为参与度的新型评估框架。研究发现,AI 反馈即使在教学法上完美,如果不能转化为学生的正确行动,其价值也将大打折扣。
核心速览
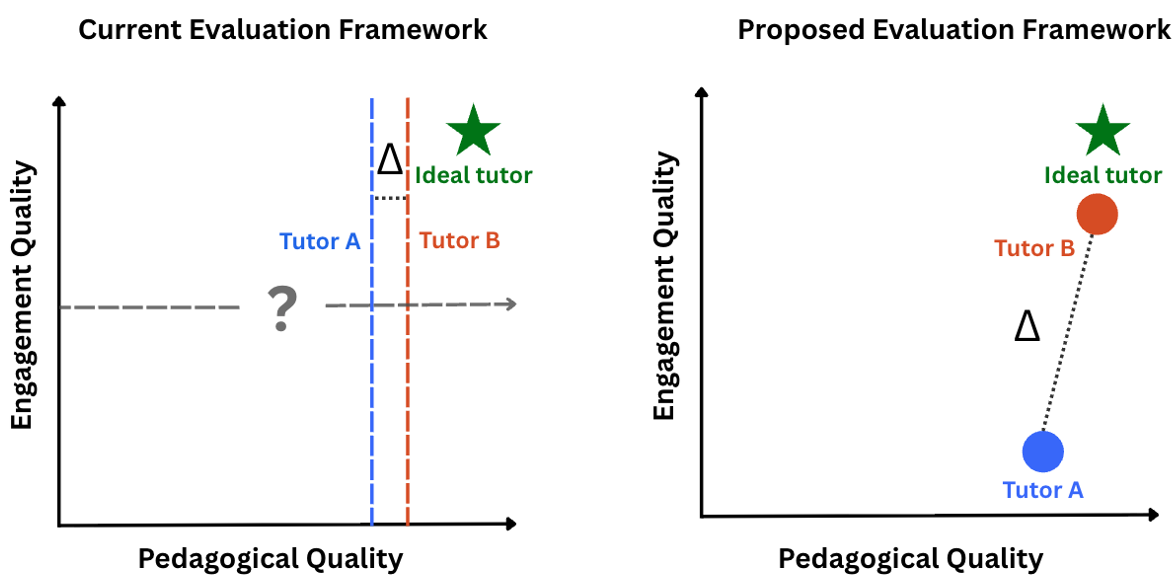
本文是来自 UC Berkeley 团队的实证研究,旨在解决 AI Tutor 评估中的“单轴局限性”问题。作者指出,当前的 SOTA 模型(如 GPT-4)在遵循教学准则方面已经做得很好,导致传统的教学法评估(Pedagogy-only)出现了瓶颈。通过引入行为维度的 RelScore(关联得分) 和 SuccScore(成功得分),研究者成功区分了两个表现接近的 AI Tutor 系统,并发现了教学法指标无法捕捉到的、对学生满意度影响更大的关键因子。
痛点深挖:教学法真的代表一切吗?
过去几年,学术界涌现了诸如 MathTutorBench 和 MRBench 等评估框架,它们主要评估:
- 反馈是否清晰?
- 是否直接给出了答案(通常被视为不好的教学法)?
- 语气是否鼓励?
然而,作者通过观察发现一个悖论:一个严格遵循教学法、拒绝透漏答案的 AI,可能因为反馈过于抽象导致学生完全无从下手(低 RelScore);而一个“违规”给出答案的 AI,虽然 SuccScore 很高,但学生只是在机械复制,而非真正学习。这种细微的动态平衡,在静态的文本评估中是完全缺失的。
方法论详解:行为维度的量化
为了捕捉这种动态性,作者利用 LLM 作为“观察员”,分析学生在收到反馈前后的两份代码草稿( 和 )。
评估框架双轴:
- 教学法轴 (Pedagogical Axis):使用 DAMR 指标,涵盖错误识别、位置定位、答案保留、引导性等 8 个维度。
- 参与度轴 (Engagement Axis):
- RelScore:反馈中每一句话是否引起了代码的变化?
- SuccScore:由反馈引发的变化是否解决了问题?
实验与结果:MisconceptionTutor 的降维打击
研究对比了两个版本:
- BaselineTutor:直接基于 GPT-4 指导。
- MisconceptionTutor:增加了一个显式的步骤——先识别学生背后的错误认知(Misconception),再针对性生成反馈。
关键发现 1:教学法评分的“欺骗性”
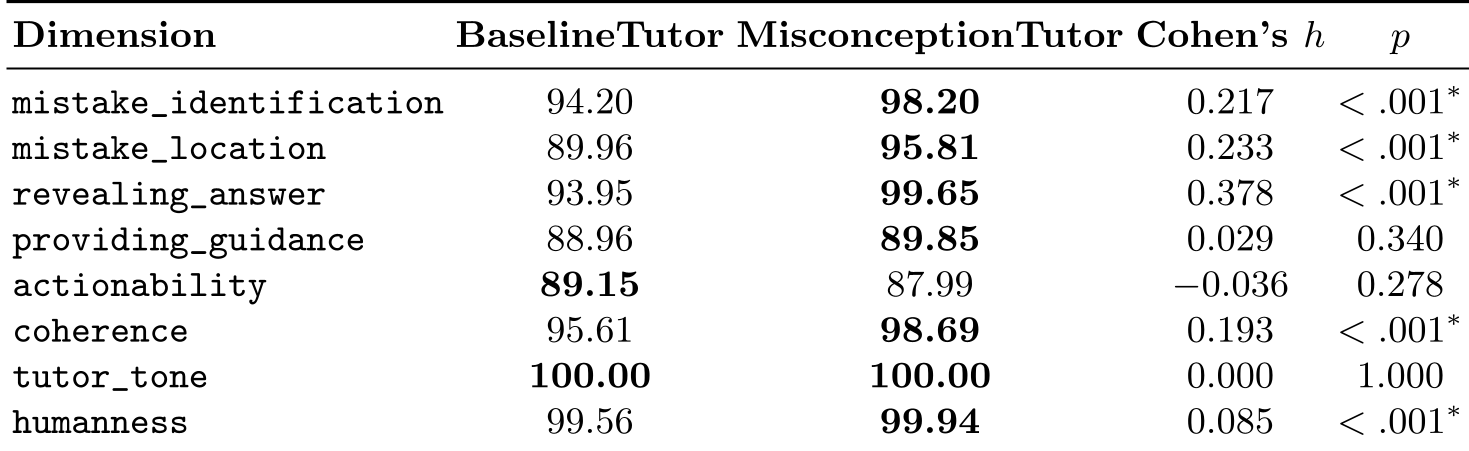
从下表可以看出,MisconceptionTutor 在大多数教学维度上仅有微弱提升,甚至在“可操作性(Actionability)”上有所下降,因为它的反馈更偏向启发式而非指令式。
关键发现 2:参与度评分的显著差异
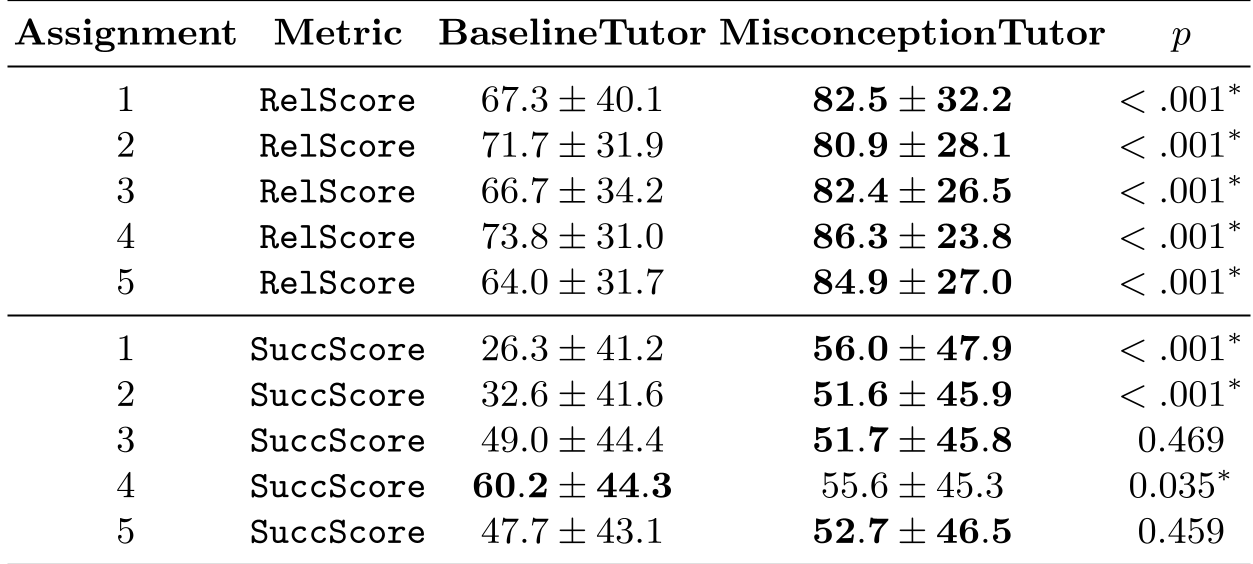
而在行为维度上,MisconceptionTutor 在所有作业中都展现出了显著更高的 RelScore。这意味着:虽然它看起来不那么“手把手”,但它成功激发了学生去思考和修改代码。
关键发现 3:满意度的真实驱动力
通过逻辑回归分析发现,RelScore 和 SuccScore 是预测学生满意度最强有力的指标。有趣的是,在教学法维度中,只有“提供引导(Providing Guidance)”对满意度有显著正贡献,而“识别错误(Mistake Identification)”竟然呈现负相关——这暗示学生讨厌只被指错而没有出路的感觉。
深度洞察:未来的 AI Tutor 应该如何卷?
- 警惕“假成功”:高 SuccScore 可能是因为模型直接泄露了答案(Revealing Answer)。评估者必须检查 SuccScore 是否源于高质量的引导而非简单的复制粘贴。
- 平衡保守与激进:MisconceptionTutor 证明了,即便为了教学原则变得“保守”,只要反馈能触动学生的思考点,参与度依然会更高。
- 闭环评估是必然趋势:未来的教育 AI 研发不能再闭门造车,必须通过 Log 记录学生的实时反应,将行为数据反馈到 Prompt 优化周期中。
总结
这篇论文为 AI 教育领域敲响了警钟:模型生成的文本美感不等于实际的教学效果。通过 RelScore 和 SuccScore 这套可落地的行为度量工具,我们终于有了一把尺子,去衡量那些隐藏在代码提交记录背后的“思维火花”。
局限性注记:目前的研究主要关注短期反馈采纳,未来的工作需结合长期后测(Post-test)来验证这些即时行为是否真的转化为了学习增益。