
PSRD:精准打击!捕捉语义切换瞬间,多模态幻觉降低 50%
Mitigating Multimodal Hallucination via Phase-wise Self-reward
本文提出了 PSRD (Phase-wise Self-Reward Decoding),一种针对多模态大模型(LVLMs)幻觉问题的推理阶段自奖励框架。该框架通过轻量化奖励模型在每个语义阶段的起始点动态触发干预,在 LLaVA-1.5-7B 上将幻觉率降低了 50.0%,刷新了多项 SOTA。
TL;DR
在多模态语言模型(LVLM)的世界里,“一本正经胡说八道”的幻觉问题始终是挥之不去的阴影。来自哈工大与鹏城实验室的研究团队发现:幻觉并非随机产生,而是在模型进入新的语义阶段时最容易掉链子。基于此直觉,他们提出了 PSRD (Phase-wise Self-Reward Decoding),通过一个轻量化“哨兵”模型在关键节点实时纠偏,无需任何微调便将 LLaVA 的幻觉率砍掉了一半。
1. 深度洞察:幻觉的“阶段性”爆发
研究者通过严谨的数据分析发现了一个极其有趣的物理现象:在生成一段描述语的过程中,幻觉的发生频率呈现出周期性的脉冲分布。
 如图 2 所示,幻觉率在每个语义段落(Phase)的开头达到顶峰。
背后的直觉(Insight): 每当模型开始描述一个新物体或新属性时(即进入新 Phase),它必须重新锚定视觉特征与文本序列之间的对齐关系。这个“重新对齐”的瞬间是模型意志最薄弱的时候,一旦起头错,后面的描述就会由于自回归机制不断累积误差。
2. 核心架构:蒸馏“内在智慧”
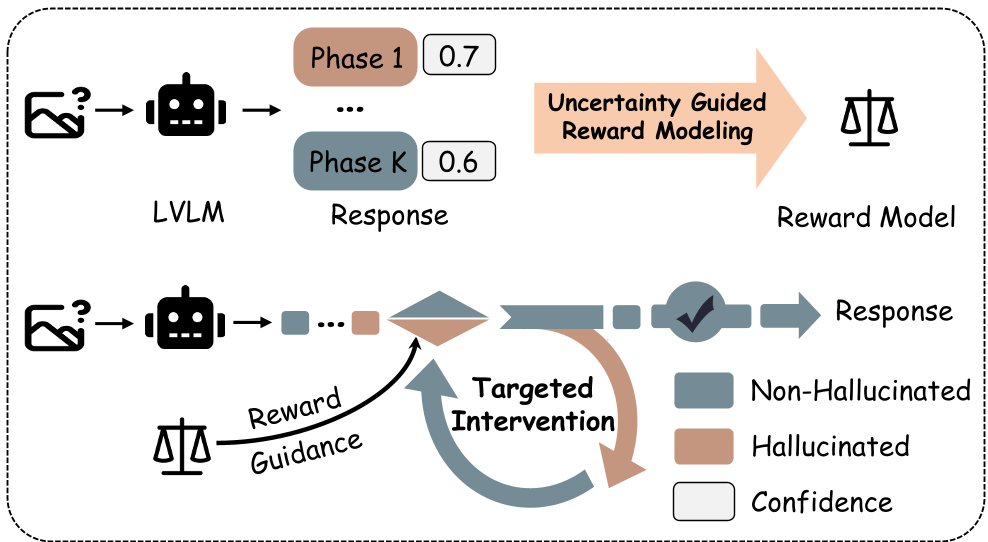
为了在不大幅增加推理开销的前提下进行纠偏,PSRD 引入了两步走的策略:
2.1 蒸馏判别器(Self-Reward Model)
LVLM 本身其实是有“自知之明”的。作者通过指令诱导模型产生幻觉,并提取模型内部的置信度作为“不确定性信号”。随后,这些信号被用来训练一个基于 CLIP 的轻量级奖励模型 。
- Discriminative Alignment (DA) Loss:强化模型区分真实描述与幻觉描述的能力。
- Margin Enforcement Loss:在正负样本间强制拉开距离 。
- Hallucination Consistency (HC) Loss:让不同类型的幻觉表征聚在一起,增强判别稳定性。
2.2 Scout-and-Project:高效搜索
在解码时,每进入一个新的语义阶段,PSRD 会启动两步搜索:
- Scouting (侦察):先看 Top-K 个候选 Token,哪个初始奖励高。
- Project (投影):在最有潜力的路径上,利用割线法(Secant Method)快速找到合适的干预强度 ,确保生成结果能通过奖励模型的“法眼”(阈值 )。

3. 实验战绩:全线飘红
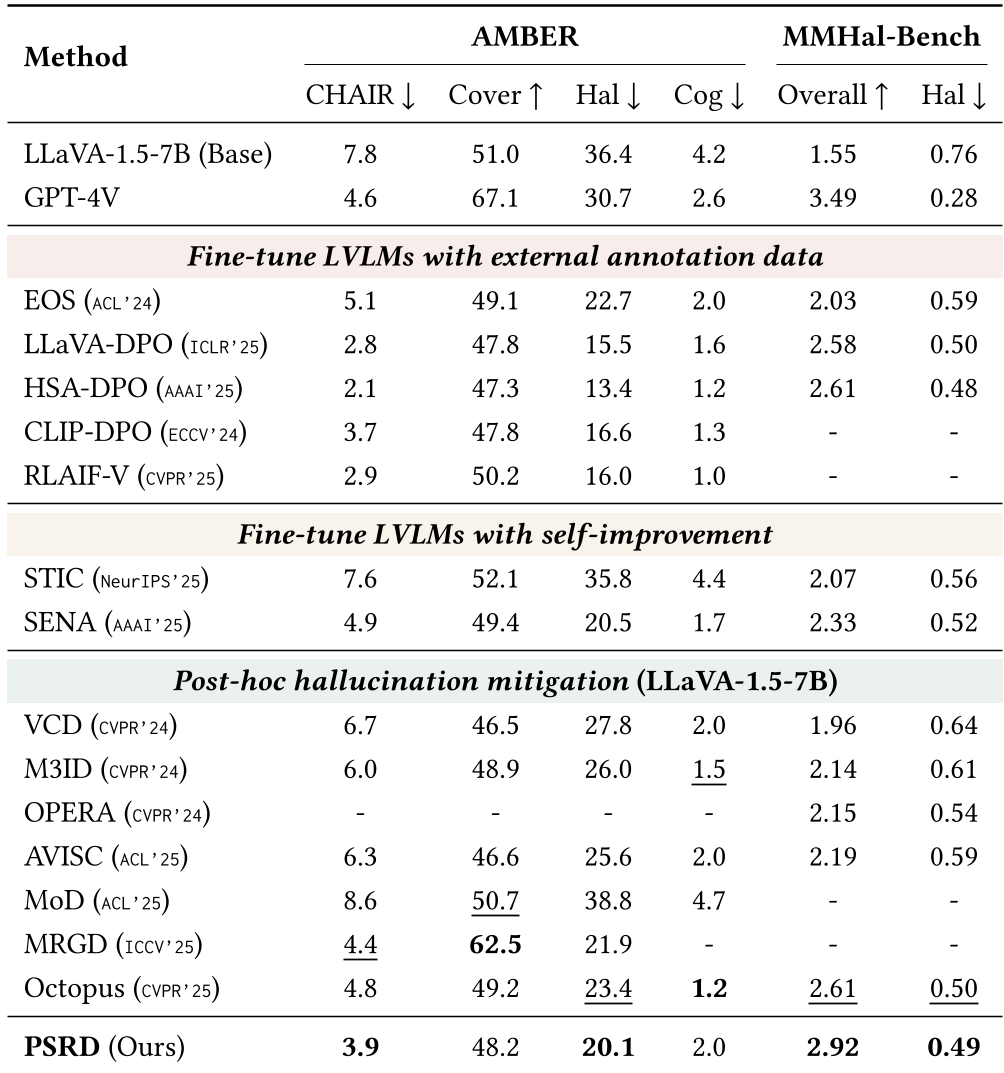
在 AMBER 和 MMHal-Bench 等多个硬核榜单上,PSRD 的表现令人惊叹:
- 显著减损:在 LLaVA-1.5-7B 上,CHAIR 指标降低了 50%。
- 阻止传播:相较于基线模型,其幻觉传播率(Propagation Rate)降低了 7 倍。这意味着 PSRD 成功在源头上掐灭了幻觉的火苗。
- 逻辑泛化:即便是在从未见过的 InstructBLIP 或 13B 规模的模型上,直接套用这个轻量级奖励模型依然能取得立竿见影的纠偏效果。
4. 深度洞察与总结
PSRD 给我们的最大启发在于:判别比生成更容易(Discrimination is simpler than Generation)。 与其花费巨大资源试图教会生成器“永不犯错”,不如训练一个敏锐的判别器坐在旁边,在它即将误入歧途的关头(Phase Start)轻轻推一把。
局限性: 尽管 PSRD 极大提高了准确合规性,但由于涉及多步搜索,其推理时间相比原始模型有约 4 倍的增长。未来的方向在于如何进一步加速这种“慢思考”过程。
总结: 这一研究为构建更可靠、更具自省能力的多模态智能体提供了一条高度可控且低成本的进化路径。