
Mix3R:当生成先验遇上前馈对齐,定义 3D 重建的新高度
Mix3R: Mixing Feed-forward Reconstruction and Generative 3D Priors for Joint Multi-view Aligned 3D Reconstruction and Pose Estimation
本文提出了 Mix3R,一种将前馈重建(Feed-forward Reconstruction)与生成式 3D 先验(Generative 3D Priors)相结合的 3D 重建框架。该方法通过 Mixture-of-Transformers (MoT) 架构实现了像素级对齐的 3D 生成与精确的相机位姿估计,在保持几何完整性的同时极大地提升了输入对齐度。
1. 核心速览 (Executive Summary)
TL;DR:Mix3R 是一项突破性的 3D 重建研究,它通过一种创新的 Mixture-of-Transformers (MoT) 架构,成功地将“前馈回归”的像素级对齐能力与“生成式模型”的全局几何想象力合二为一。它不仅能从极少量的视角生成完整的 3D 资产,还能做到几乎完美的纹理对齐与位姿估计。
背景定位:该工作属于 3D 重建与生成技术的顶尖融合之作,解决了长期以来基于生成的 3D 模型“虚假繁荣”(好看但不准)以及前馈模型“支离破碎”(准但不全)的痛点,是当前 3D 资产生成领域的重要 SOTA。
2. 痛点深挖 (Problem & Motivation)
目前的 3D 重建领域存在两个截然不同的派系:
- Feed-forward 派 (例如 π3, VGGT):像是个稳重的速写师,能准确画出眼睛看到的东西,但背面看不见的地方完全抓瞎,且在视角稀疏时容易崩溃。
- Generative 派 (例如 TRELLIS):像是个富有想象力的画家,只要给一张图,就能脑补出整个物体的样子,但往往“画得像但对不准”,不仅比例会错位,相机的位姿也经常估偏。
作者敏锐地发现:这是一个“鸡生蛋,蛋生鸡”的问题。如果生成模型知道相机的精确位置,就能对齐纹理;如果回归模型知道物体的全局形状,就能更好地预测位姿。Mix3R 便是为了打破这种孤立而生的。
3. 方法论详解 (Methodology)
Mix3R 的核心魔法在于其 两阶段对齐架构:
3.1 阶段一:MoT 混合特征交互
作者没有简单地堆叠模型,而是采用了 Mixture-of-Transformers (MoT) 架构。它将 TRELLIS 的 3D 生成分支和 π3 的 2D 图像特征分支交织在一起。
- 双向获益:2D 分支为生成过程提供具有几何信息(Point Map)的局部特征;3D 分支则提供全局形状先验,帮助 2D 分支稳定相机位姿。
- 架构设计:通过巧妙的 Block Matching(块匹配)策略,将两种不同深度的 Transformer 进行强制对齐,并插入 MoT 自注意力层。
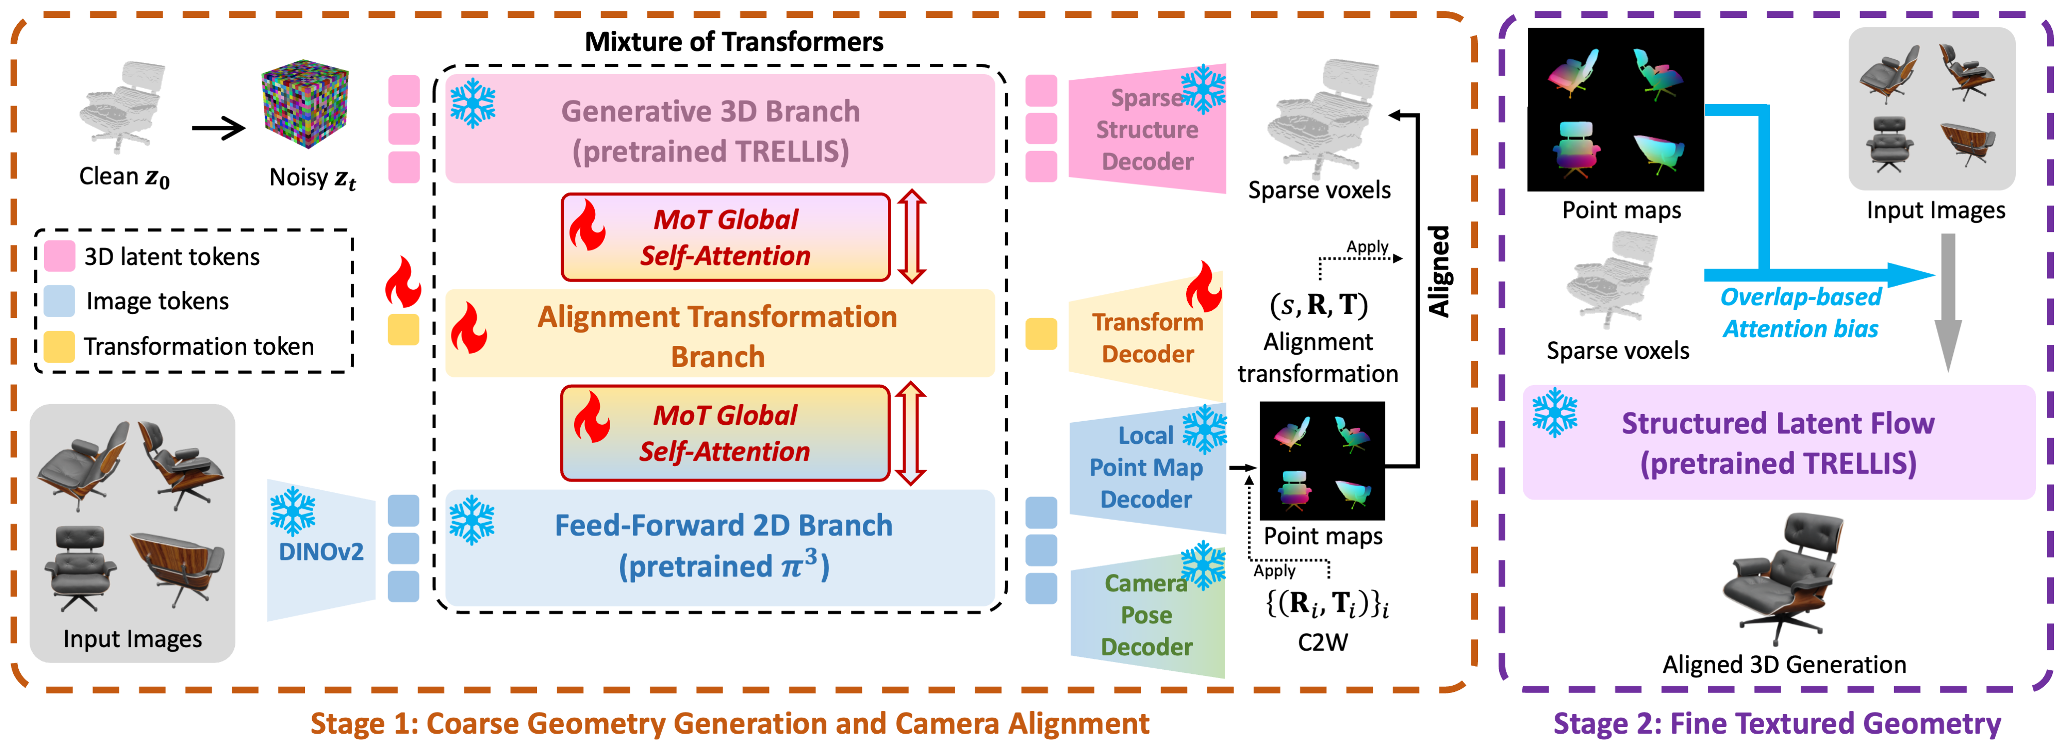 图 1:Mix3R 两阶段框架图。左侧为 MoT 驱动的联合推理模块,右侧为精细纹理生成模块。
3.2 阶段二:计算驱动的 Attention Bias
为了让生成的纹理完美贴合,作者引入了一种 Training-free(无需训练) 的优化方案。利用第一阶段预测的对齐点图,计算 3D 像素(Voxel)与 2D 图像块(Patch)之间的重叠度,并将其转化为 Attention Bias 注入到 Flow-matching 模型中。这强制模型在生成某个 3D 区域时,“更专注”于那些确实覆盖了该区域的图像块。
4. 实验与结果 (Experiments & Results)
Mix3R 在多个维度上展现了统治力:
4.1 像素级对齐神技
通过将生成的物体投影回原视角,Mix3R 的渲染图与原图的重合度极高。在 Toys4k 实验中,PSNR 指标比以往最好的方法(ReconViaGen)提升了 18% 以上。
 图 2:重投影对齐效果对比。可以看到 Mix3R 在保留物体复杂结构和位姿解析上的精准度。
4.2 几何与纹理精度
甚至在被遮挡的部分,Mix3R 也能生成比 TRELLIS 更精准的几何形状。Chamfer Distance (CD) 的量级降低意味着物体的比例更加忠于原作。
| Dataset | Metric | TRELLIS | ReconViaGen | Ours |
|---|---|---|---|---|
| Toys4k | PSNR ↑ | 23.93 | 24.49 | 27.17 |
| Toys4k | CD ↓ | 7.99 | 1.94 | 0.74 |
5. 深度洞察与总结 (Critical Analysis & Conclusion)
核心价值 (Takeaway): Mix3R 成功的关键在于它不再把 3D 重建看作是一个简单的“图像到几何”的平移任务,而是一个“先验引导下的精细对齐”任务。 MoT 架构作为一种高度灵活的插件式设计,为未来融合更多模态(如激光雷达数据、热成像)进 3D 生成提供了巨大的想象空间。
局限性 (Limitations):
- 视角敏感度:如果输入的视角极其离群(例如从未训练过的怪异仰角),π3 分支的失效可能会误导生成分支。
- 材质挑战:目前仍难以处理极高反光或透明的材质,这受限于底层 TRELLIS VAE 的表征能力。
展望: 随着更强大的基座模型(如 Hunyuan3D 2.0/2.5)出现,Mix3R 这种融合“确定性前馈”与“可能性生成”的思路,将成为生产高质量 3D 工业资产(Asset-level objects)的主流路径。