
MPFM:打破单峰假设,利用混合原型流匹配重塑异常检测边界
Mixture Prototype Flow Matching for Open-Set Supervised Anomaly Detection
本文提出了混合原型流匹配(MPFM)框架,用于解决开集监督异常检测(OSAD)任务。该方法通过引入高斯混合模型(GMM)作为流匹配的目标先验,成功在多个基线数据集上实现了 SOTA 性能,尤其在 AITEX 数据集上 AUC 提升了 5.5%。
TL;DR
在开集监督异常检测(OSAD)领域,如何利用极少数已知异常并泛化到未知异常是核心挑战。本文提出的 MPFM (Mixture Prototype Flow Matching) 框架,首次将高斯混合模型 (GMM) 与流匹配 (Flow Matching) 结合。它摒弃了传统方法中“正常数据是单峰分布”的错误假设,通过建模多模态正常模式,显著提升了模型对未知异常的判别力,在 9 个主流 benchmark 上刷新了 SOTA。
1. 痛点:被忽视的“多模态”正态分布
在工业缺陷检测或医学影像分析中,所谓的“正常”往往由多种截然不同的模式组成(例如:不同颜色、纹理或解剖结构的正常样本)。
- 现有方法的局限:如 DPDL 等 SOTA 工作通常将正常数据映射到一个单中心的高斯先验。
- 直觉偏差:这种“强行归一”会导致那些处于分布边缘的罕见正常模式被误判为异常(False Positives),就像试图用一个大圆圈包住几个散落的小点,由于圈子太模糊,异常样本很容易混进来。
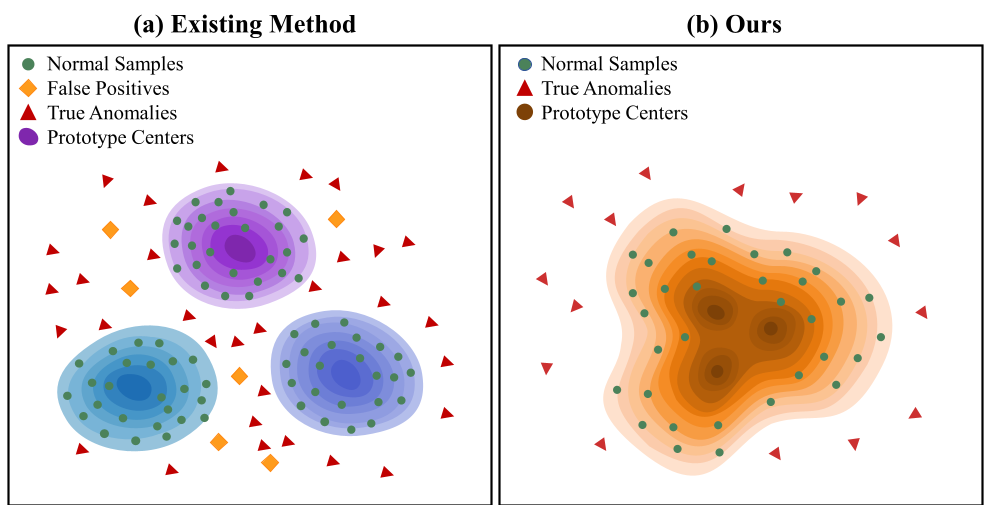 图 1:(a) 传统单峰方法决策边界模糊;(b) MPFM 通过多模态原型捕捉细粒度特征。
2. 核心方法论:从独立原型到连续流转换
MPFM 的核心贡献在于它不仅仅学习了几个孤立的聚中心,而是构建了一个连续的生成桥梁。
2.1 混合原型流学习 (MPFL)
作者没有采用传统的扩散模型,而是选择了效率更高的 Flow Matching。模型学习一个速度场 ,将正常特征 输送到预定义的 GMM 目标空间。其创新点在于速度场本身也是参数化的 GMM: 这种设计允许模型在推理时实现闭式采样 (Closed-form Sampling),无需复杂的数值 ODE 积分,保证了推理的高效性。
2.2 互信息最大化正则器 (MIMR)
为了防止所有的 个高斯组件相互重叠导致“原型坍缩”,作者引入了 MIMR 损失函数:
- 降低条件熵:确保每个特征都能被自信地分配到某一个原型中心。
- 最大化边缘熵:确保所有原型都能被均匀使用,避免模型偷懒只演化出一个聚类。
提示:此处建议补充论文中的整体架构图,展示特征提取、流转换与 GMM 先验的交互流程。
3. 实验结果:全方位的 SOTA
MPFM 在包括 MVTec AD, AITEX, Hyper-Kvasir 在内的 9 个数据集上进行了验证。
3.1 量化提升
- 通用场景:在 10-shot 设定下,MPFM 在 AITEX 上的 AUC 达到了 0.992,相比之前的最强基线提升明显。
- 难例场景 (Hard Setting):即测试集中包含训练时从未见过的异常类别。MPFM 在 Mastcam 数据集上实现了 6.3% 的惊人提升,证明了混合原型对未知模式的建模厚度。
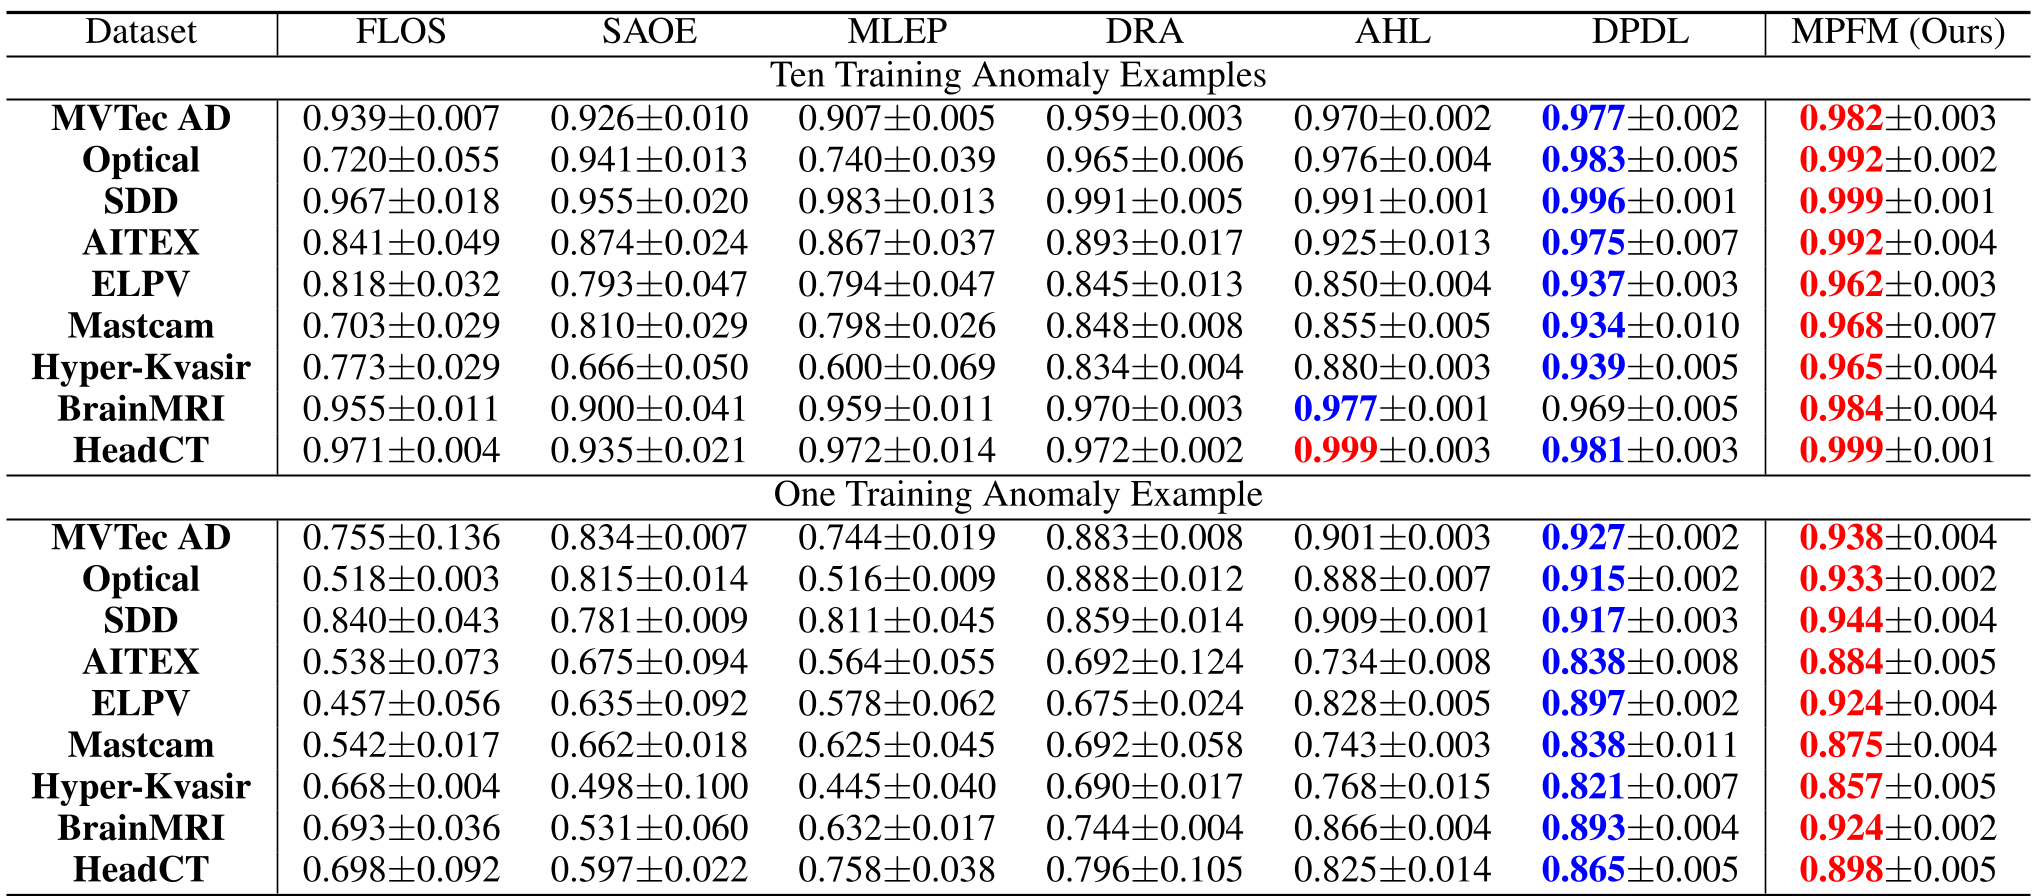 表 1:MPFM 与 DRA, AHL, DPDL 等 OSAD 方法的性能对比。
3.2 消融实验分析
消融研究显示,Mg (Global Likelihood Scorer) 是性能的基石。这说明,仅仅学习分布是不够的,将流转换后的似然值作为评分依据,是捕捉全局模式偏差最有效的方法。
4. 深度洞察
MPFM 成功的本质在于它在特征判别性与生成连续性之间找到了平衡。传统的分类方法只管“推开”异常,而 MPFM 通过 Flow Matching 实际上在学习如何从底层分布上“理解”什么是正常。
局限性分析: 虽然 GMM 的组件数 在实验中被设定为 32,但对于极端复杂(如自动驾驶城市场景)的数据,固定 是否存在瓶颈,以及如何自适应地选择组件数量,仍是未来值得探索的方向。
总结
MPFM 为 OSAD 提供了一个优雅且强大的工具。它告诉我们:在异常检测中,对“正态”的精细化建模(Multi-modality)往往比单纯地去搜索“异常”更具泛化潜力。