
MoLS:破解 Adam 优化黑盒,利用信噪比实现 LLM 模块化训练加速
Revealing Modular Gradient Noise Imbalance in LLMs: Calibrating Adam via Signal-to-Noise Ratio
本文提出了 MoLS (Module-wise Learning Rate Scaling via SNR),一种针对大语言模型(LLMs)的自动化模块级学习率校准方法。通过在训练初期估算各功能模块的信噪比(SNR),MoLS 能够自动调整不同模块的学习率,显著提升了 Adam 类优化器的收敛速度和泛化性能。
TL;DR
Transformer 并非铁板一块,Embedding 层、Attention 层和 MLP 层的优化难度天差地别。本文提出的 MoLS 揭示了 LLM 训练中严重的模块信噪比(SNR)失衡问题,通过在训练初期自动化配置各模块的学习率,实现了媲美专家级手动调优的收敛效率,且几乎零开销、零显存占用。
1. 痛点:被“一视同仁”杀死的训练效率
在训练超大规模模型时,我们习惯于给所有参数设定一个全局学习率。尽管 Adam(W) 能够针对每个参数做自适应调整,但它存在一个被长期忽视的缺陷:噪声抑制赤字 (Noise-Damping Deficit)。
作者研究发现,Adam 的更新公式在物理直觉上可以近似为: 这意味着,如果一个模块(如 Embedding 或 Output Head)的梯度噪声极大(SNR 极低),它的有效更新步长会被严重抑制。与其说它在学习,不如说它在原地“踏步”,形成训练中的结构性瓶颈。
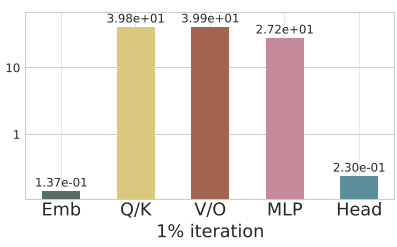 上图显示:Attention 相关模块处于高 SNR 区间,而 Embedding 和 Head 层的 SNR 极低,且这种差距在训练初期尤为显著。
2. 核心直觉:信噪比定价权
既然不同的模块“信号质量”不同,为何不按质论价?
MoLS 的核心方法论非常优雅:
- 轻量化采样:在 Warm-up 阶段利用极少量样本(约 32 次迭代)估算各模块的平均 SNR。
- 信号平衡原理:选取 SNR 表现最好的模块作为基准(通常是 VO 映射层),定义缩放因子 :
- 自动化调价:对低 SNR 模块给予更大的学习率补偿,而高 SNR 模块维持原状,从而让所有模块在“有效信号步长”上达成共识。
(算法伪代码:在 Warm-up 结束前平滑地将各个模块的学习率切换至计算出的目标值,避免 Loss Spikes。)
3. 实验战绩:全线飘红
MoLS 的强大之处在于其通用性和“即插即用”的特性:
- 加速收敛:在 LLaMA-1.3B 预训练中,MoLS 将最终验证 perplexity 降低了 1.06,收敛速度提升 1.2x 以上。
- 大模型扩展性:在 7B 规模下,其优化效果依然稳健,PPL 降低达 1.69。
- 完美兼容性:它能直接套用在 Adam-mini、GaLore 等显存优化器上,甚至在 LoRA 微调任务中也能带来显著提升。
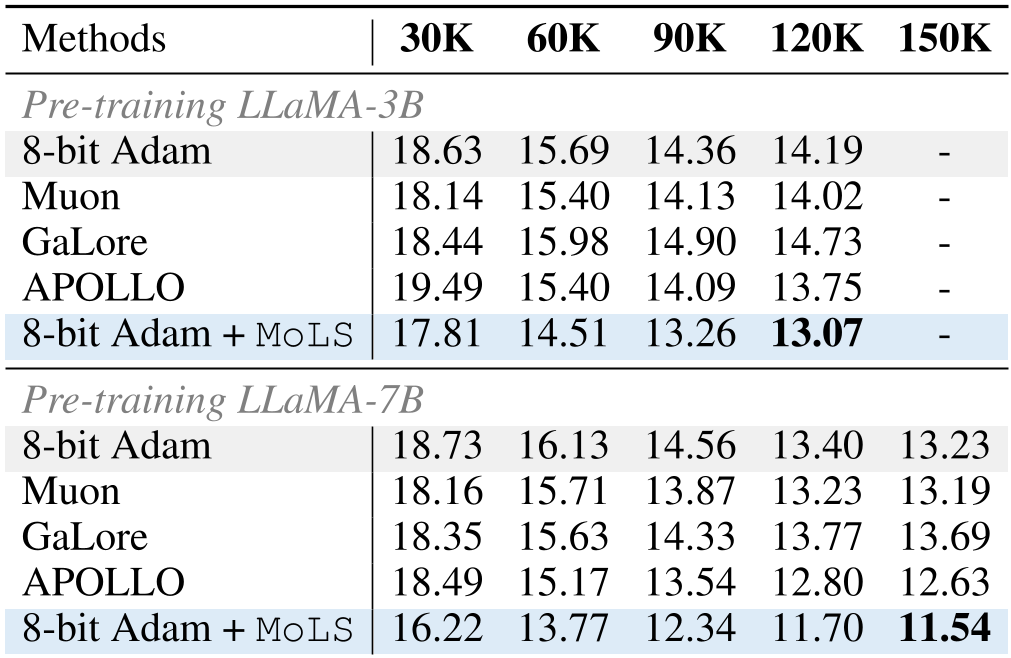 实验证明,MoLS 的这种自动化校准,效果已经非常接近于耗费大量算力资源才调优出来的手动模块学习率组合(见报告 Figure 3)。
4. 深度洞察:为什么这很重要?
长期以来,学术界一直在争论 Transformer 是否需要复杂的二阶优化器。MoLS 实际上提供了一个中间路线:它利用梯度的一阶/二阶矩来估计“信号质量”,并以此修正一阶优化器的局限。
局限性分析: 尽管 MoLS 是一次重大的效率升级,但其当前版本采用的是静态缩放(Warm-up 后固定因子)。在训练极后期,随着所有梯度逐渐萎缩,SNR 的分布可能会发生漂移。此外,对于 MoE 等稀疏激活架构,模块的划分可能需要更细粒度的动态策略。
##总结 MoLS 证明了在 LLM 优化中,“结构化思维”优于“参数化孤立”。通过简单的 SNR 校准,我们不再需要昂贵的网格搜索来寻找各层负载的最优解,AI 训练正在从“炼金术”向“精密工程”持续进化。