
MolmoAct2:打破闭源垄断,为现实世界部署重塑具身推理模型
MolmoAct2: Action Reasoning Models for Real-world Deployment
本文推出了 MolmoAct2,这是一个完全开源的视觉-语言-动作(VLA)推理模型系列。它基于专门强化的 Molmo2-ER 骨干网络,通过离散分词预训练与连续流匹配(Flow-matching)动作专家后训练相结合,实现了在多种低成本机器人平台(如 YAM, SO-100, DROID)上的高效部署,并在 13 项具身推理基准上超越了 GPT-5 和 Gemini-ER。
TL;DR
机器人领域长期以来缺乏一个既能像 GPT 系列那样“思考”,又能高效输出连续动作,且完全开源的“大脑”。由 Allen Institute for AI (AI2) 领衔开发的 MolmoAct2 填补了这一空白。它不仅不仅开源了权重,还开源了代码和包含 720 小时双臂操作数据的 MolmoAct2-BimanualYAM 数据集。通过创新的分层 KV 耦合架构和自适应深度推理,它在保持极低延迟的同时,大幅提升了机器人在复杂环境下的作业成功率。
痛点深挖:为什么 VLA 难以走出实验室?
尽管 Vision-Language-Action (VLA) 模型进展迅速,但它们往往在“闭源”与“效率”之间挣扎:
- 黑盒化严重:前沿模型(如 Google 的 Gemini-ER)不提供训练细节。
- 效率悖论:增加推理步骤(如 Chain-of-Thought)能提高准确度,但会导致推理延迟(Latency)激增,让机器人变得“反应迟钝”,无法应对动态环境。
- 成本壁垒:许多开源工作强绑定在数万美金的硬件上,阻碍了研究的普及。
架构解析:如何兼顾“逻辑”与“动作”?
MolmoAct2 并没有简单地在 VLM 后面挂一个动作头,而是采用了一种 “专才-通才”混合架构。
1. 具身强化的骨干:Molmo2-ER
作者首先利用 330 万个样本训练了一个专精于空间感知的 VLM。它能理解像素级的坐标、深度信息以及多摄像头之间的视角转化。实验显示,这个骨干网络在具身推理任务上甚至超越了 GPT-5 等闭源模型。
2. 连续与离散的深度耦合
MolmoAct2 巧妙合成了离散 Token(用于推理和预训练)与连续流匹配(Flow-matching,用于精准动作控制):
- 预训练阶段:使用 OpenFAST Tokenizer 将动作离散化,像处理语言一样预测下一刻动作。
- 后训练阶段:引入一个 DiT 风格的动作专家模块,通过每层 KV 缓存连接直接提取主干网络中不同层级的语义和几何特征。
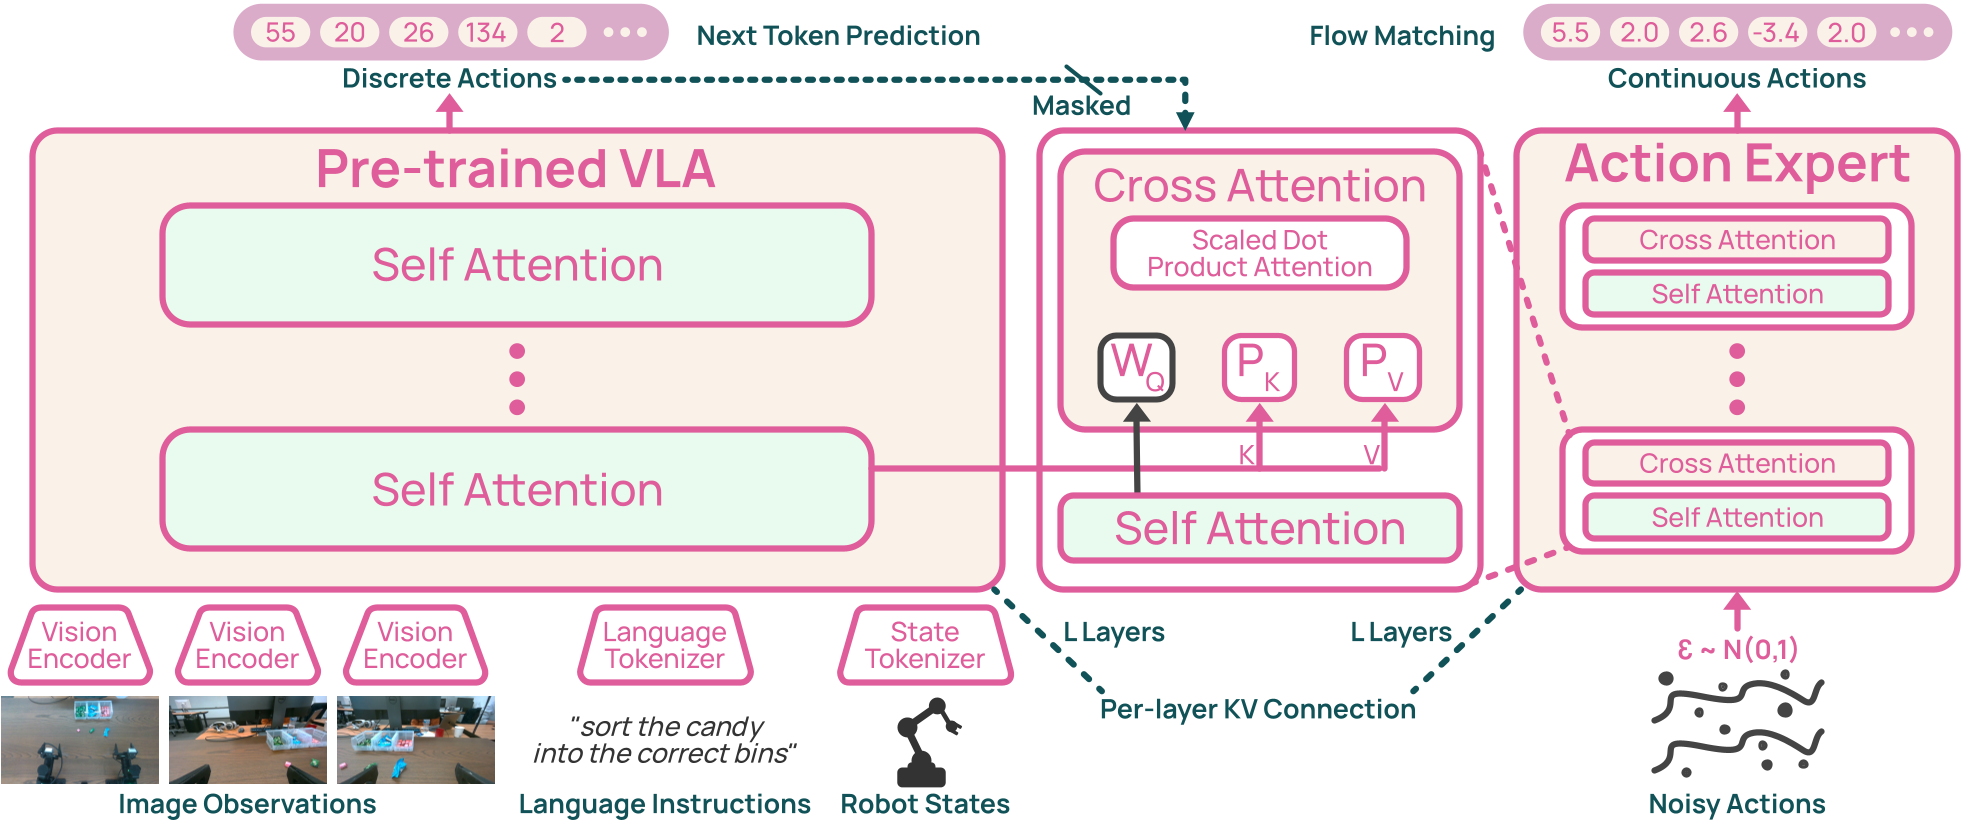 图 1:MolmoAct2 的分层 KV 连接架构,展示了动作专家如何从 VLM 骨干中吸取特征
3. MolmoAct2-Think:自适应“思考”
之前的模型(如 MolmoAct)在动作前会生成完整的深度预测序列。MolmoAct2-Think 引入了时空冗余性优化:它只针对 RGB 画面中发生变化的区域更新深度 Token。如果场景没变,它就会复用缓存,这使得推理开销与场景的动态程度成正比,而非固定高延迟。
实验与结果:全方位的 SOTA 战绩
MolmoAct2 在模拟器(LIBERO)和真实世界任务中均表现强劲。
- 真实世界泛化:在清洗碗盘、倒茶等 8 项极具挑战的真实任务中,其成功率高达 50.1%,比此前的开源标杆 π0.5 和 OpenVLA 提升了约 15%。
- 部署效率:通过 CUDA Graph 优化,MolmoAct2 在 H100 上的运行频率可达 55.79 Hz,完全满足实时控制(一般要求 >10-20 Hz)的需求。
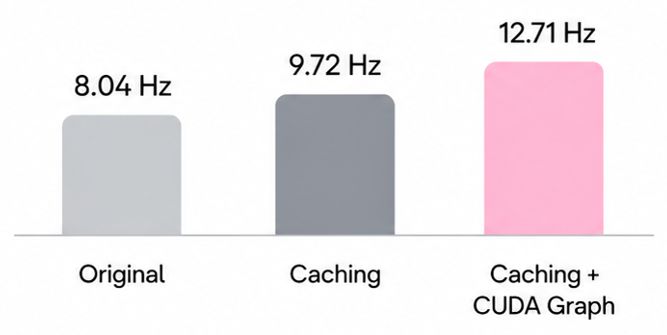 图 2:经过缓存与 CUDA Graph 优化后的推理频率提升显著
深度洞察:为什么这篇论文值得关注?
MolmoAct2 的核心价值在于它证明了 “空间推理能力”是 VLA 模型性能的上限。通过引入显式的深度/几何引导,模型不再只是盲目地模仿人类的轨迹,而是真正“理解”了物体间的空间关系。同时,自适应推理机制的成功也预示着:未来的 VLA 可能会根据任务难度自动调节计算资源的分配(即 Test-time Compute Scaling)。
总结与展望
MolmoAct2 为机器人社区贡献了迄今为止最完整的开源基石。无论是它提出的每层 KV 连接架构,还是其自适应深度的设计思路,都对低成本硬件上的自主操作具有重要的指导意义。唯一的局限性可能在于其对高算力显卡(如 H100)的训练依赖,但随着 OpenFAST Tokenizer 等工具的成熟,在更广泛的硬件上实现高效微调已指日开待。