
MotionCache:打破“全有或全无”,运动感知让自回归视频生成提速 7 倍
Motion-Aware Caching for Efficient Autoregressive Video Generation
本文提出了 MotionCache,一种针对自回归视频生成设计的运动感知缓存加速框架。通过引入基于帧间差异(Intra-chunk Frame Difference)的像素级运动评分,MotionCache 在保持视觉质量的同时,在 SkyReels-V2 和 MAGI-1 模型上分别实现了 7.26x 和 2.07x 的推理加速。
TL;DR
在自回归视频生成领域,如何平衡推理速度与画面质量始终是核心痛点。传统的缓存加速方案往往“一刀切”,强制整个视频块同步更新。由字节跳动、厦门大学等机构提出的 MotionCache 另辟蹊径:它通过像素级的**运动感知(Motion-Aware)**策略,让模型聪明地识别出哪些区域在动、哪些在静。实验证明,该方法在基本不损失画质的前提下,将生成速度最高提升了 7.26 倍。
背景定位:自回归视频生成的计算瓶颈
自回归视频模型(如 SkyReels-V2, MAGI-1)通过将长视频切割成 Chunk,利用 KV Cache 将计算复杂度从平方级降至线性,理论上支持无限长度生成。然而,迭代去噪(Iterative Denoising)的巨大开销依然让 7 秒钟的视频往往需要近半小时的 A800 推理时间。
目前的加速方案(如 TeaCache)主要集中在步级跳过,即根据输入差异决定是否跳过整一步计算。但这种“粗粒度”做法在处理复杂运动时会产生严重后遗症:静态背景虽然省了,但动的物体也跟着“糊了”或“飘了”。
核心直觉:残差不稳定性与运动的数学联系
作者首先建立了一个严谨的数学视角:缓存误差(Caching Error)本质上由残差的不稳定性(Residual Instability)决定。
简单来说:如果连续两步之间模型的输出残差变化剧烈,强制复用旧缓存就会引入巨大误差。通过分析发现,这种不稳定性与视频中的运动量高度正相关。基于此,作者提出了以**帧间差异(Frame Difference)**作为计算 Token 重要性的轻量级代理。
方法论详解:三位一体的加速方案
MotionCache 的核心架构逻辑分为三个步骤:
- 运动感知 Token 评分:利用当前 Chunk 内相邻帧的 L1 距离,为每个 Token 生成热力图(Importance Map)。
- 加权累积更新策略:高运动区域的 Token 会迅速累积“误差预算”,从而被频繁触发完整计算;静态区域则由于权重低,会更多地复用缓存残差。
- 双阶段推理调度(Coarse-to-Fine):
- Phase 1(结构化升温):在去噪初期执行固定步数的全量计算,确保全局语义(如构图、主体位置)稳定。
- Phase 2(细节精修):进入 Token 级稀疏更新模式,只计算那些“动起来”的像素。
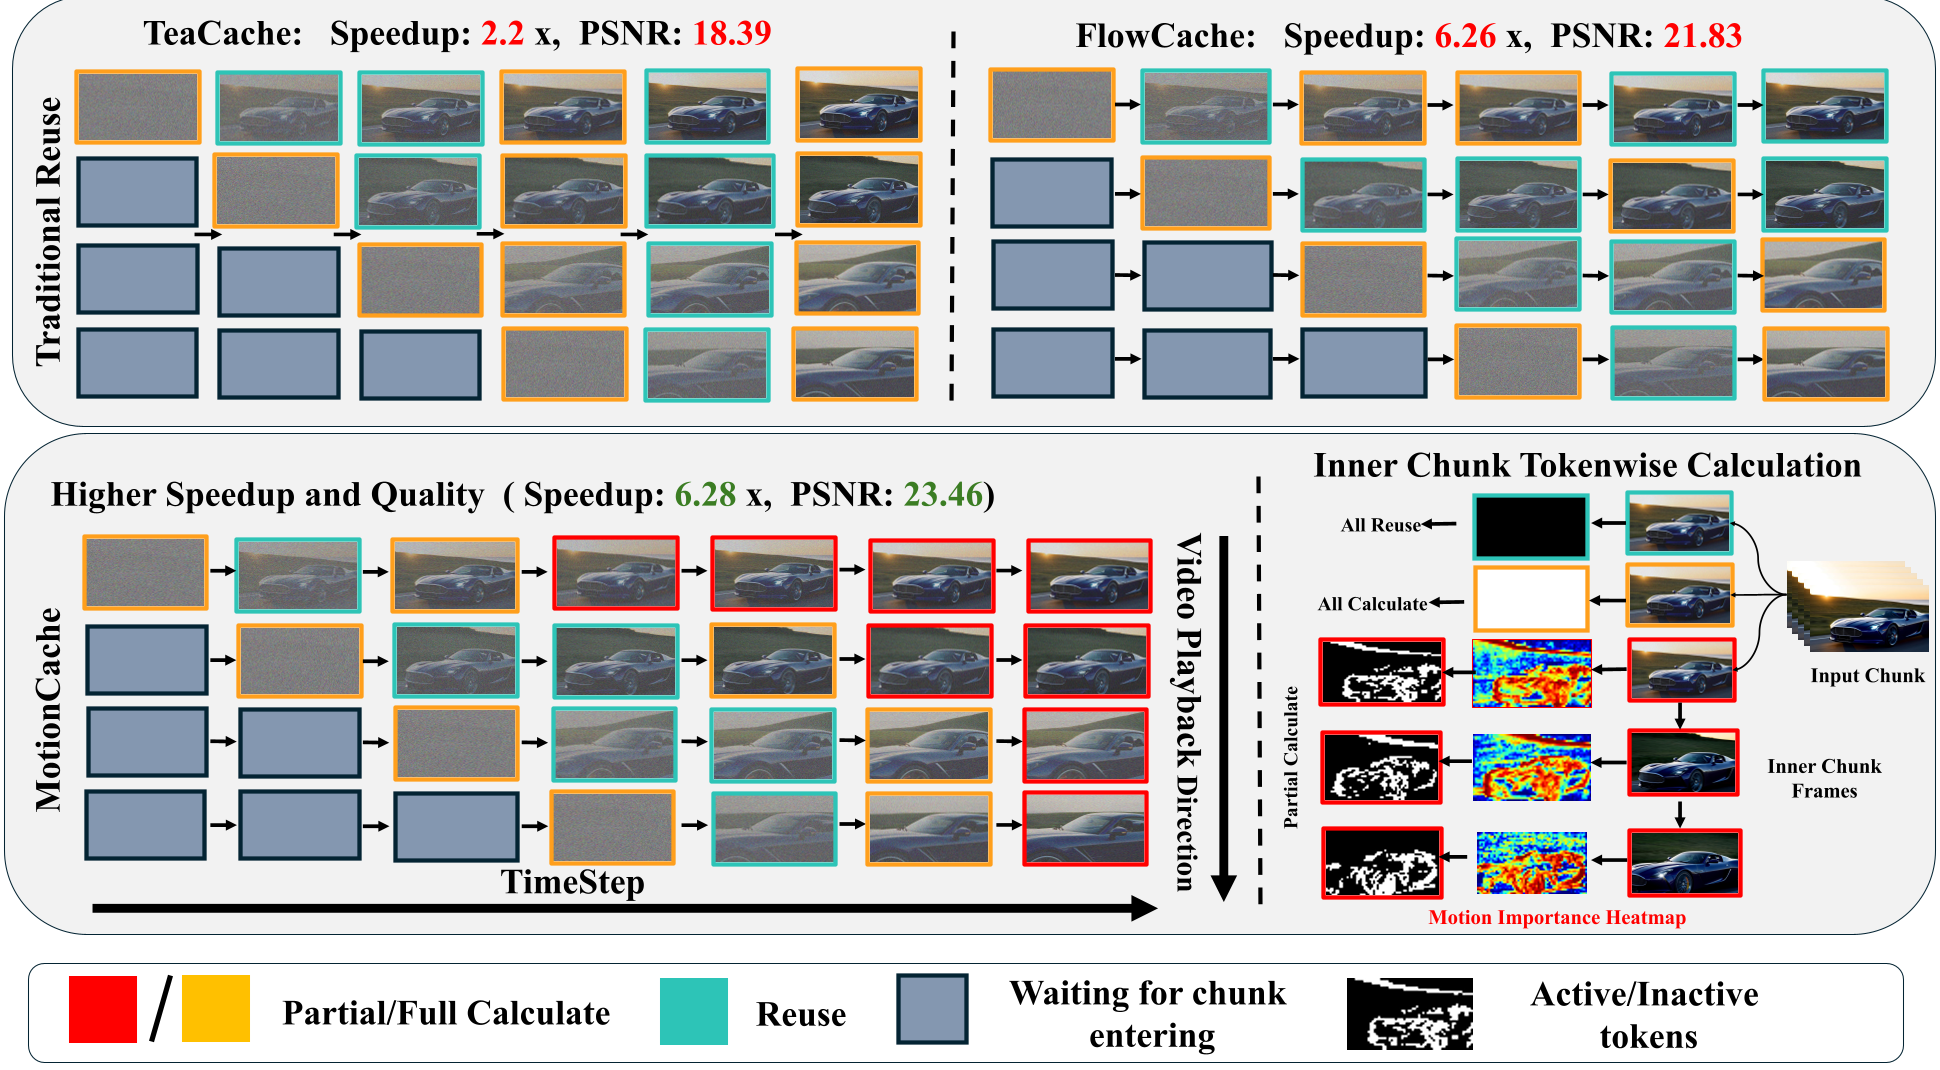 图 1:MotionCache(下方)与传统方法的对比。可以看到 MotionCache 能够根据运动分量生成非均匀的二进制计算掩码(Mask)。
实验战绩:速度与画质的“既要又要”
在多个 SOTA 模型上,MotionCache 展现了统治级的加速效率:
- SkyReels-V2 (1.3B):加速比达到 7.26x,PSNR 从基线的坍缩水平提升至 21.78,显著优于 TeaCache。
- MAGI-1 (4.5B):在 720p 分辨率下实现 2.07x 加速,同时在 VBench 长期视频评测中保持了最高的保真度。
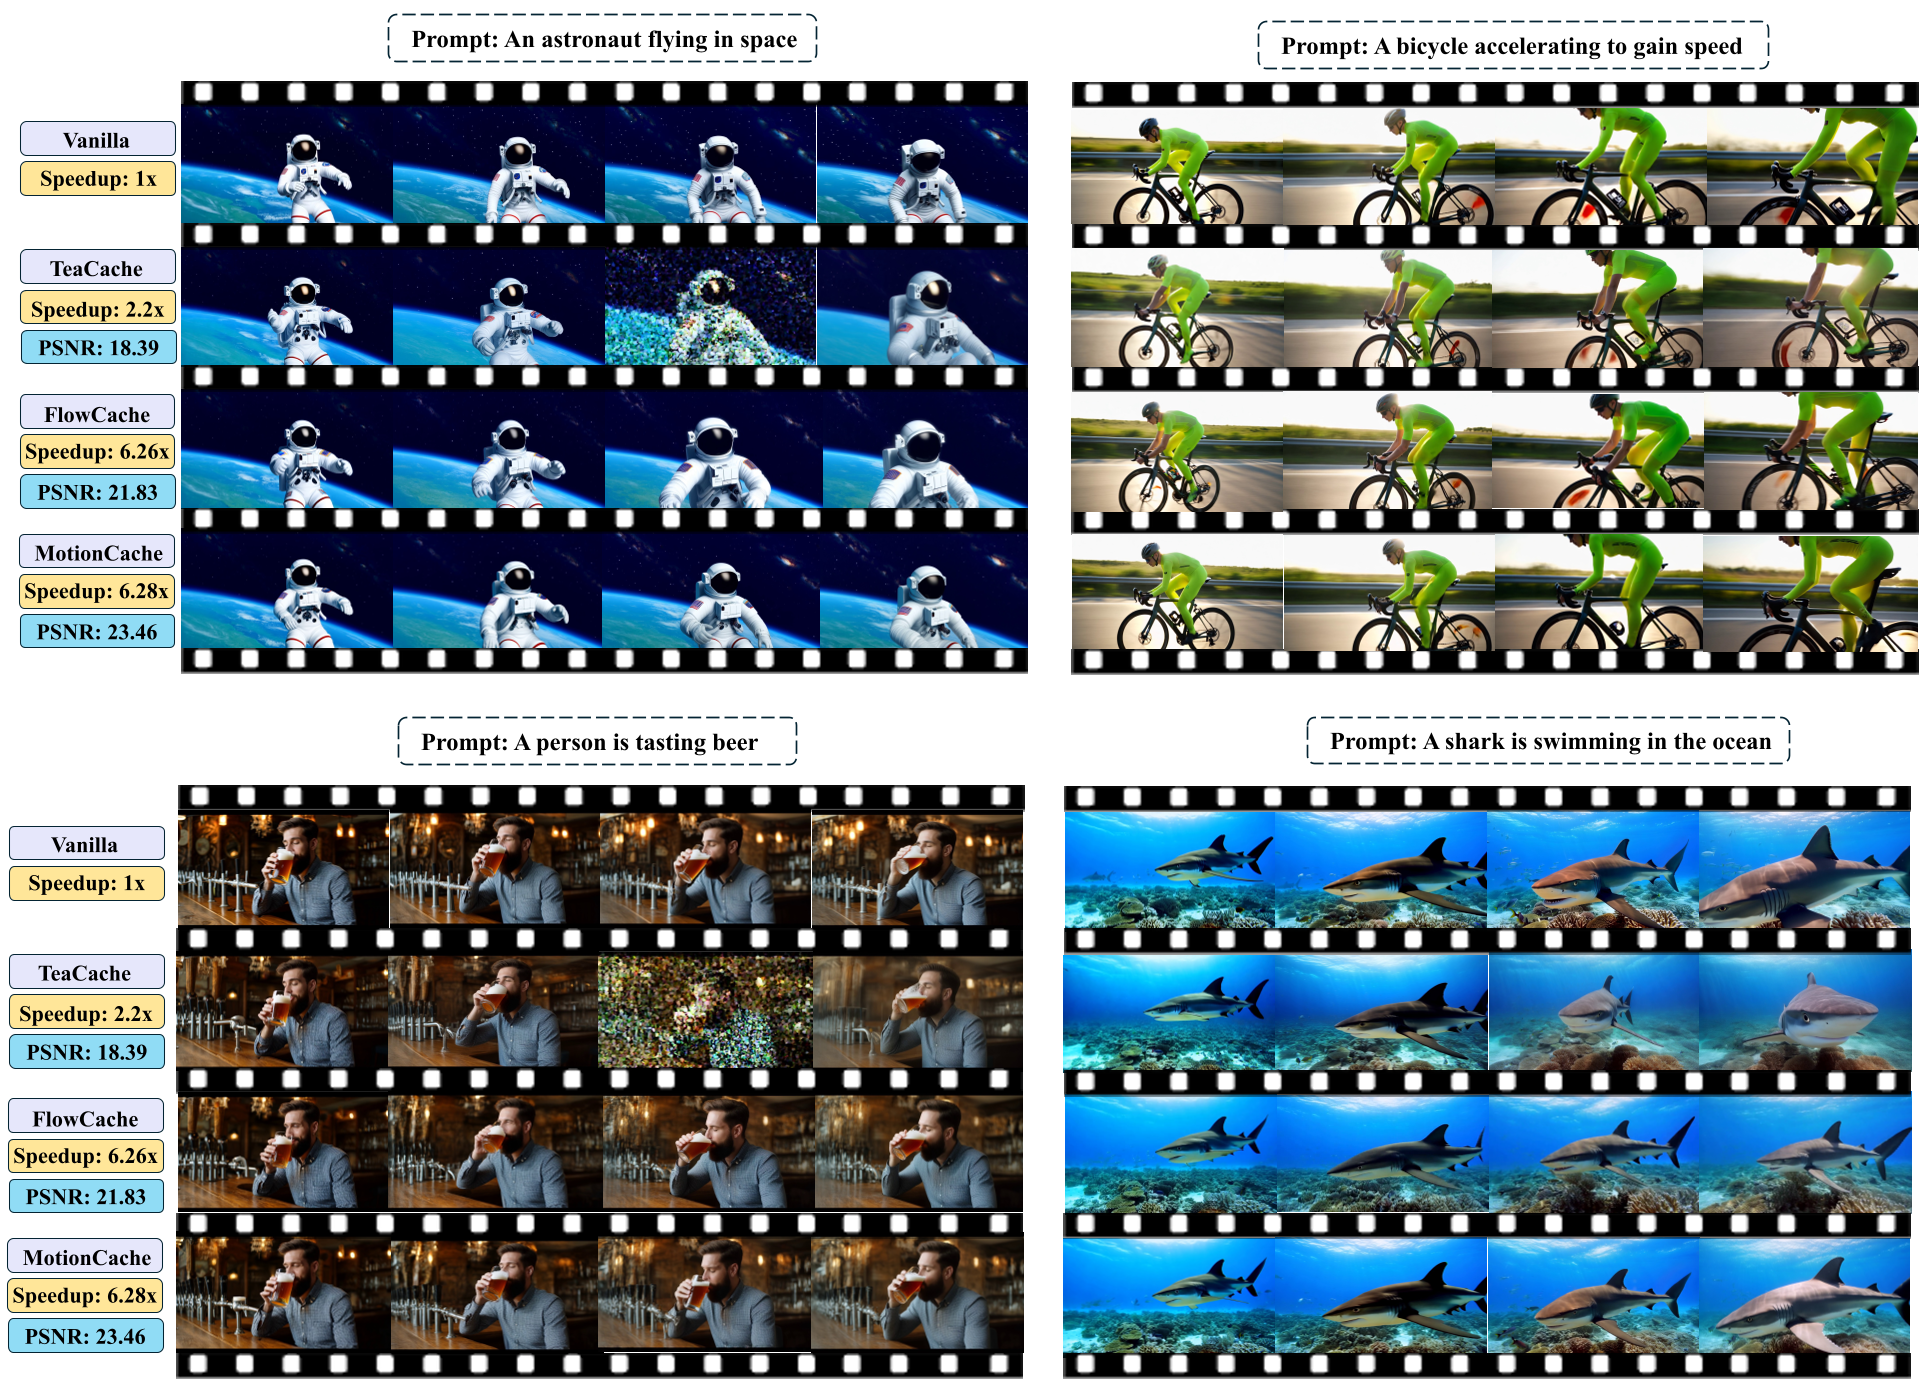 图 2:在航天员和品酒的案例中,FlowCache 等方法出现了“六指神魔”等解剖学缺陷,而 MotionCache 完美保留了细节并消除了高频噪声。
深度洞察
MotionCache 的成功在于其深刻理解了扩散模型在不同时间、空间尺度上的能量分布是不均匀的。
- 消融分析:研究发现参数 (底线更新频率)至关重要。如果完全不更新背景(),背景纹理会随时间逐渐瓦解;通过设置 ,模型即便在静态区域也会保持低频的“保底更新”,维持了背景的厚重感。
- 局限性:虽然通过 Token 指数加权降低了开销,但计算重要性图本身仍有一定计算量。尽管作者证明了这种开销极低,但在极端轻量化的边缘端设备上仍需优化。
总结
MotionCache 标志着视频加速从“全局粗放型”向“局部精细型”的转变。通过将数学上的残差分析与视觉上的运动直觉相结合,它为自回归视频生成提供了目前性能最强的训练无关(Training-free)加速方案。对于追求实时视频互动、长电影生成的开发者来说,这是一个极具启发性的方向。