
MotionGRPO:通过强化学习破解扩散模型在第一人称动作恢复中的“脚滑”难题
MotionGRPO: Overcoming Low Intra-Group Diversity in GRPO-Based Egocentric Motion Recovery
本文提出了 MOTIONGRPO,一个基于强化学习(RL)后训练的 3D 人体动作恢复框架。该方法通过 Group Relative Policy Optimization (GRPO) 优化扩散模型的采样过程,在由头显(HMD)提供的稀疏信号下,实现了 SOTA 级别的全身动作重建精度与视觉真实度。
TL;DR
在 VR/AR 领域,仅凭头显(HMD)信号恢复全身动态一直面临几何不精确和视觉伪影的挑战。MotionGRPO 首次将 DeepSeek-R1 背后火爆的 GRPO (组相对策略优化) 算法引入扩散模型后训练。通过引入混合奖励机制和Perlin 噪声注入策略,该框架不仅刷写了 AMASS 和 RICH 数据集的 SOTA 记录,还成功解决了重构任务中 RL 训练梯度消失的顽疾。
1. 痛点:扩散模型的“散漫”与重构的“严谨”
基于扩散模型(Diffusion Models)的方法在生成多样化动作方面表现优异,但在**第一人称动作恢复(Egocentric Motion Recovery)**这一重构任务中,却显得不够“严谨”:
- 几何失真:由于扩散损失(Standard Diffusion Loss)本质上是在做分布匹配,它并不直接惩罚某个关节的厘米级偏差。
- 物理违和:常见的“脚滑”(Foot Skating)和“入地”(Ground Penetration)在像素空间看可能符合分布,但在 3D 模型中却是致命的视觉 Artifacts。
- 约束困境:在采样过程中加入硬性几何约束往往会导致生成过程不稳定。
2. 核心贡献:重塑策略优化
2.1 扩散采样即决策过程 (MDP)
MotionGRPO 将扩散模型的反向去噪过程建模为一个多步马尔可夫决策过程(MDP)。
- 状态 (State):当前带噪动作坐标 、时间步 和头显轨迹条件 。
- 动作 (Action):预测下一步的去噪样本 。
- 奖励 (Reward):在采样结束()时计算。
2.2 混合奖励机制 (Hybrid Reward)
为了兼顾“长得像”和“对得准”,作者设计了双层奖励:
- 视觉级奖励(Visual-level):一个基于 Transformer 的感知模型,通过在线对比学习训练,专门识别抖动和物理不一致。
- 关节级奖励(Joint-level):显式计算位置、旋转、速度与 Ground Truth 的 L1/L2 距离。
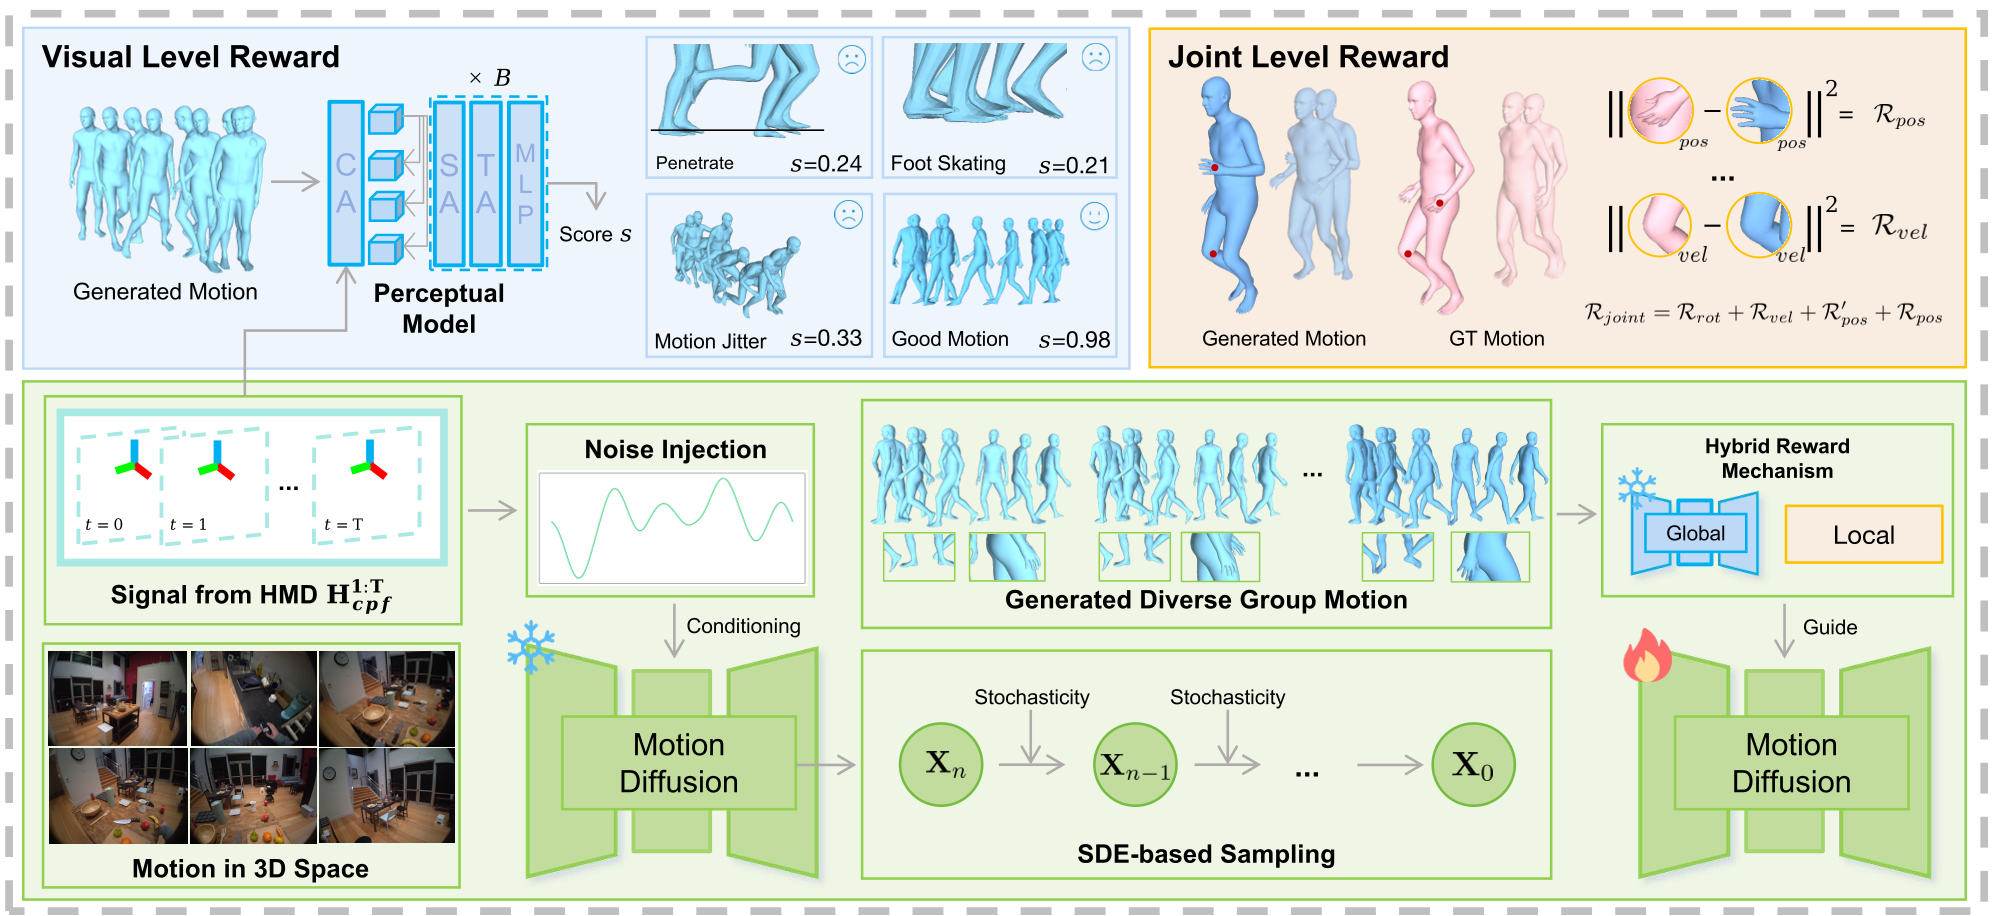 图 1:MotionGRPO 整体流程。从 HMD 信号输入到基于 SDE 的多样化采样,再到混合奖励反馈更新。
3. 技术突破:通过噪声注入对抗梯度消失
在标准的生成任务中,模型输出非常多样。但在动作恢复任务中,由于头显信号(Condition )的约束极强,GRPO 采样出的 16 个样本(Group Size )往往长得一模一样。
数学直觉: 在 GRPO 的优势函数计算中: 如果组内多样性太低,分母的方差(std)趋于 0,导致梯度爆炸或消失,训练立即崩溃。
解决方案: 作者巧妙地引入了 Perlin Noise 注入。在训练阶段,给输入的头显轨迹人为加入平滑噪声。
- Why? 这种“人工合成的困难样本”增加了模型的不确定性,迫使 policy 在探索时产生差异化的输出,从而为 GRPO 提供了有效的梯度信号。
4. 实验战绩
MotionGRPO 在多个 Benchmark 上实现了全方位超越。尤其是在处理复杂、剧烈动态的 RICH 数据集时,提升尤为明显。
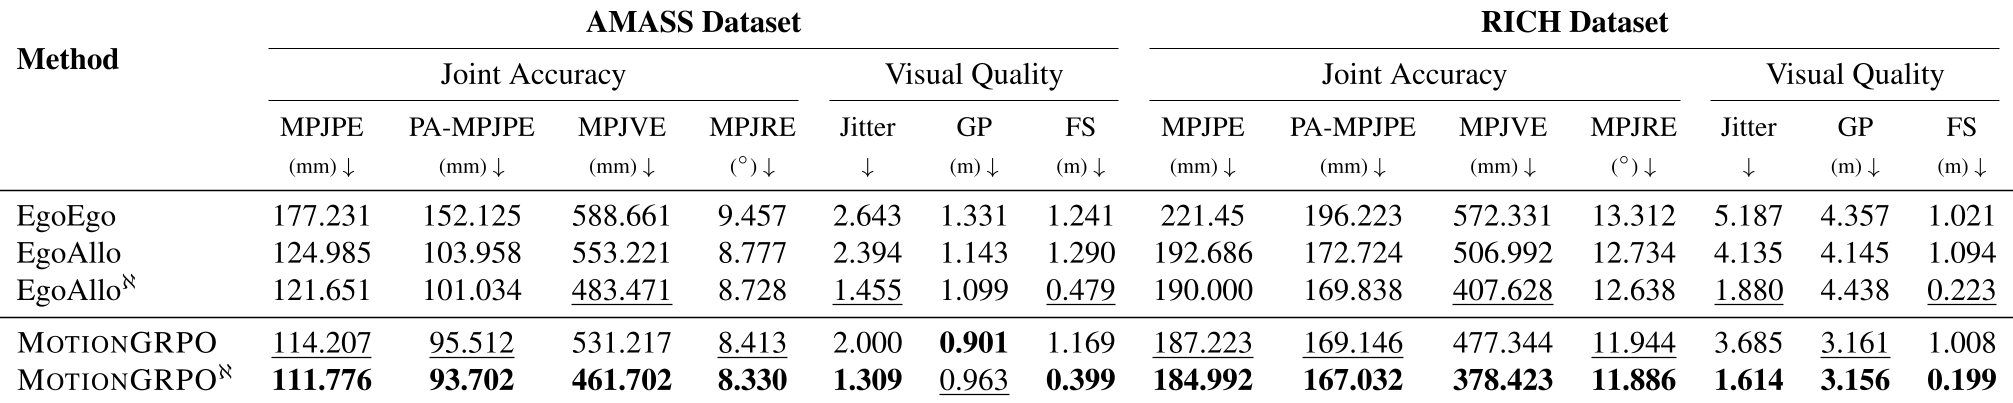 表 1:在 AMASS 和 RICH 数据集上的指标对比。可见其在关节精度(MPJPE)和视觉质量(Jitter/GP)上均大幅领先。
消融实验验证了三个核心设计的有效性:
- 加入 Vanilla GRPO:提升了基础精度。
- 加入 视觉奖励:显著减少了地面穿透现象。
- 加入 Perlin 噪声:通过恢复梯度流,将 MPJPE 进一步拉低。
5. 深度洞察
MotionGRPO 的成功不仅在于它用了 GRPO,更在于它理解了**条件重构任务(Conditioned Reconstruction)**做 RL 训练时的本质矛盾——确定性输入与探索性采样之间的冲突。
局限性: 虽然解决了动作恢复的精度问题,但目前模型仍假设地面是水平的,对复杂地形(如上下楼梯、沙发交互)的感知还有待提升。此外,GRPO 虽然省去了 Value Network 的显存,但多次推理生成的训练成本依然较高。
总结 (Takeaway): 这是一篇将 LLM 领域的 RL 对齐经验成功迁移到 CV/Graphics 领域的典范之作。它告诉我们,当模型生成的动作“看起来很美但错漏百出”时,与其增加数据或加深网络,不如给它一个好的“奖励函数”并用策略优化去调教。