
GLMap:利用 3D 高斯与多尺度语言构建具身智能的“数字化双胞胎”
Multi-Scale Gaussian-Language Map for Zero-shot Embodied Navigation and Reasoning
本文提出了多尺度高斯语言地图(GLMap),这是一种为具身导航与推理任务设计的语义地图框架。通过结合 3D Gaussian Splatting 与多尺度语义表示,GLMap 在无需任何特定任务训练的前提下,在 ObjectNav、InstNav 和 SQA 任务中达到了 SOTA 水平。
TL;DR
传统的语义地图要么空有几何结构(如点云),要么语义模糊(如特征场),难以让大语言模型(LLM)直接“看懂”。本文提出的 GLMap (Gaussian-Language Map) 创新性地结合了 3D Gaussian Splatting 的显式几何表达与多尺度语言描述,构建了一个大模型友好的双模态地图。它无需任何任务微调(Zero-shot),即可在物体导航、指令导航和空间问答任务中大放异彩。
1. 痛点深挖:为什么现有地图不够好?
具身智能(Embodied AI)的核心难题之一是:如何让机器人记住它看过的世界?
目前的方案主要存在三类局限:
- 拓扑地图 (Topological Maps):仅存储节点连接,丢失了精确的几何位置,难以处理“我右边有什么”这类空间推理。
- 网格地图 (Grid Maps):通常只存类别标签,丢失了丰富的视觉语义和上下文。
- 特征映射 (Feature-based):将图像编码为 CLIP 特征存入空间。虽然语义丰富,但 LLM 根本不认识这些“特征向量”,必须通过额外的映射层(Projection)转换,导致系统极难扩展。
作者给出的 Insight 是:大模型天然喜欢图片和文字。 那么,我们为什么不直接存图片渲染器(3D Gaussians)和文字描述,让 LLM 直接“读”地图?
2. 核心方法论:GLMap 的三层架构
2.1 显式几何与多尺度语义
GLMap 放弃了单一的标签系统,转而采用两级语义单元:
- Instance Units (实例单元):记录物体(如“蓝色的金属椅”),包含其对应的 3D 高斯点云集合。
- Region Units (区域单元):记录功能区(如“厨房”、“办公区”),存储相关的实例 ID 列表。
2.2 Gaussian Estimator:无需训练的几何推导
不同于原始 3DGS 需要数千次迭代更新,GLMap 利用具身任务自带的深度信息(Depth),通过一个解析式的 Gaussian Estimator 快速生成模型:
- 体素化采样:将点云划分为体素,利用切比雪夫邻域内的点计算均值和协方差。
- 曲率感知合并:在平坦区域(如墙壁)合并高斯球以节省内存;在此类边缘(如桌角)保留更多细节。
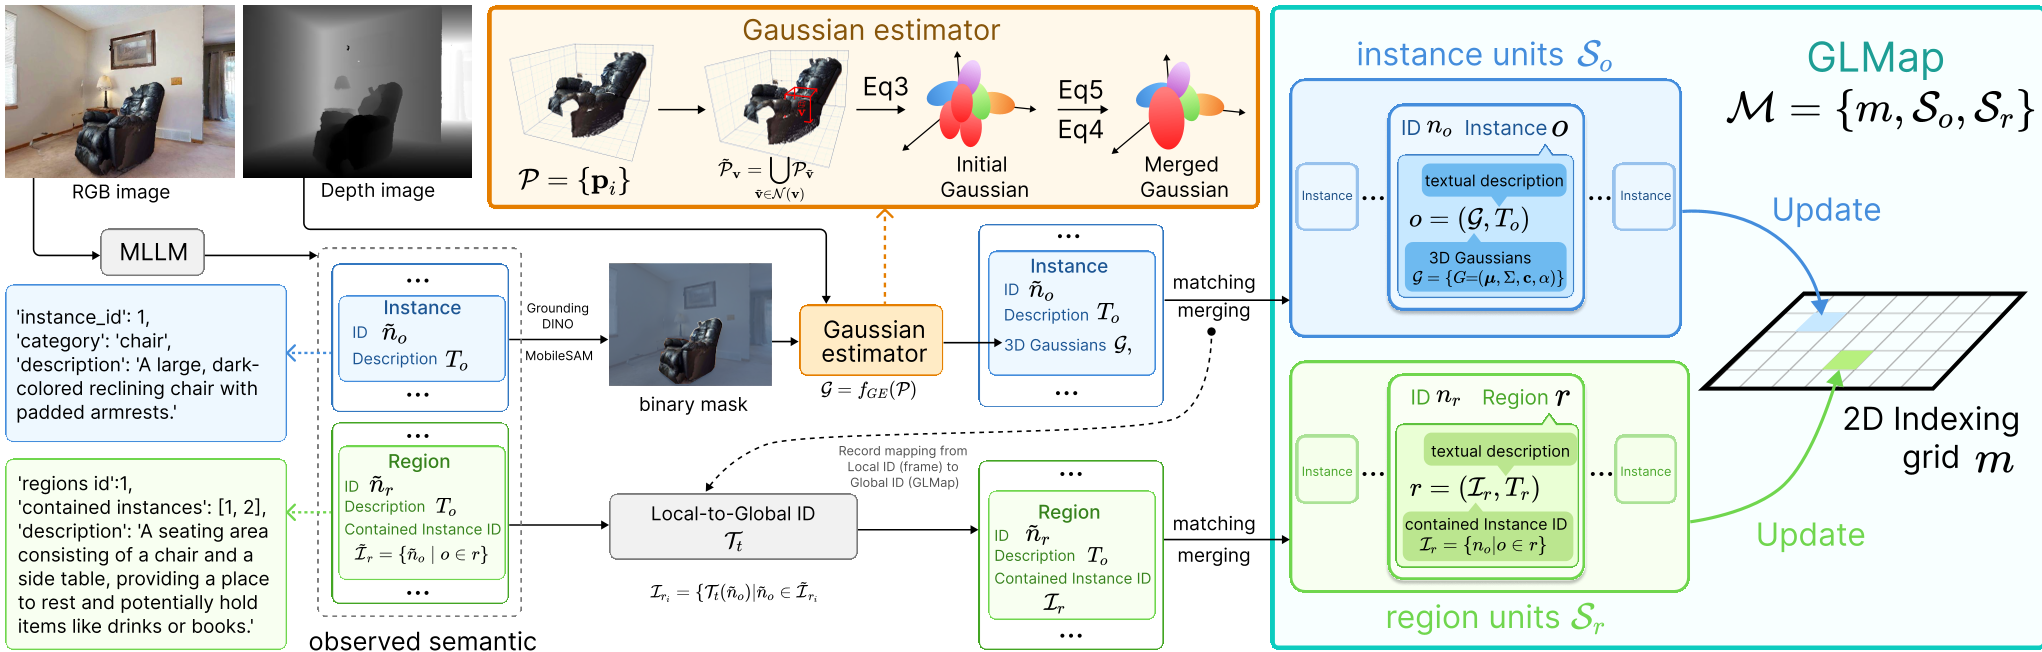 图 1:GLMap 的增量式构建流程,展示了从 RGB-D 输入到实例/区域语义提取及高斯融合的过程。
3. 实验战绩:全能选手的性能表现
在三大核心任务中,GLMap 均表现卓越:
- ObjectNav (目标导航):在未知环境中寻找“电视”,GLMap 通过 3D 高斯高效渲染候选视点供 LLM 评分。
- InstNav (特定对象导航):寻找“桌子上的显示器”,多尺度语义提供了丰富的空间关系描述。
- SQA (空间问答):面对“我背后开着什么窗户?”此类问题,GLMap 渲染多视角图像引导 MLLM 给出准确答案。
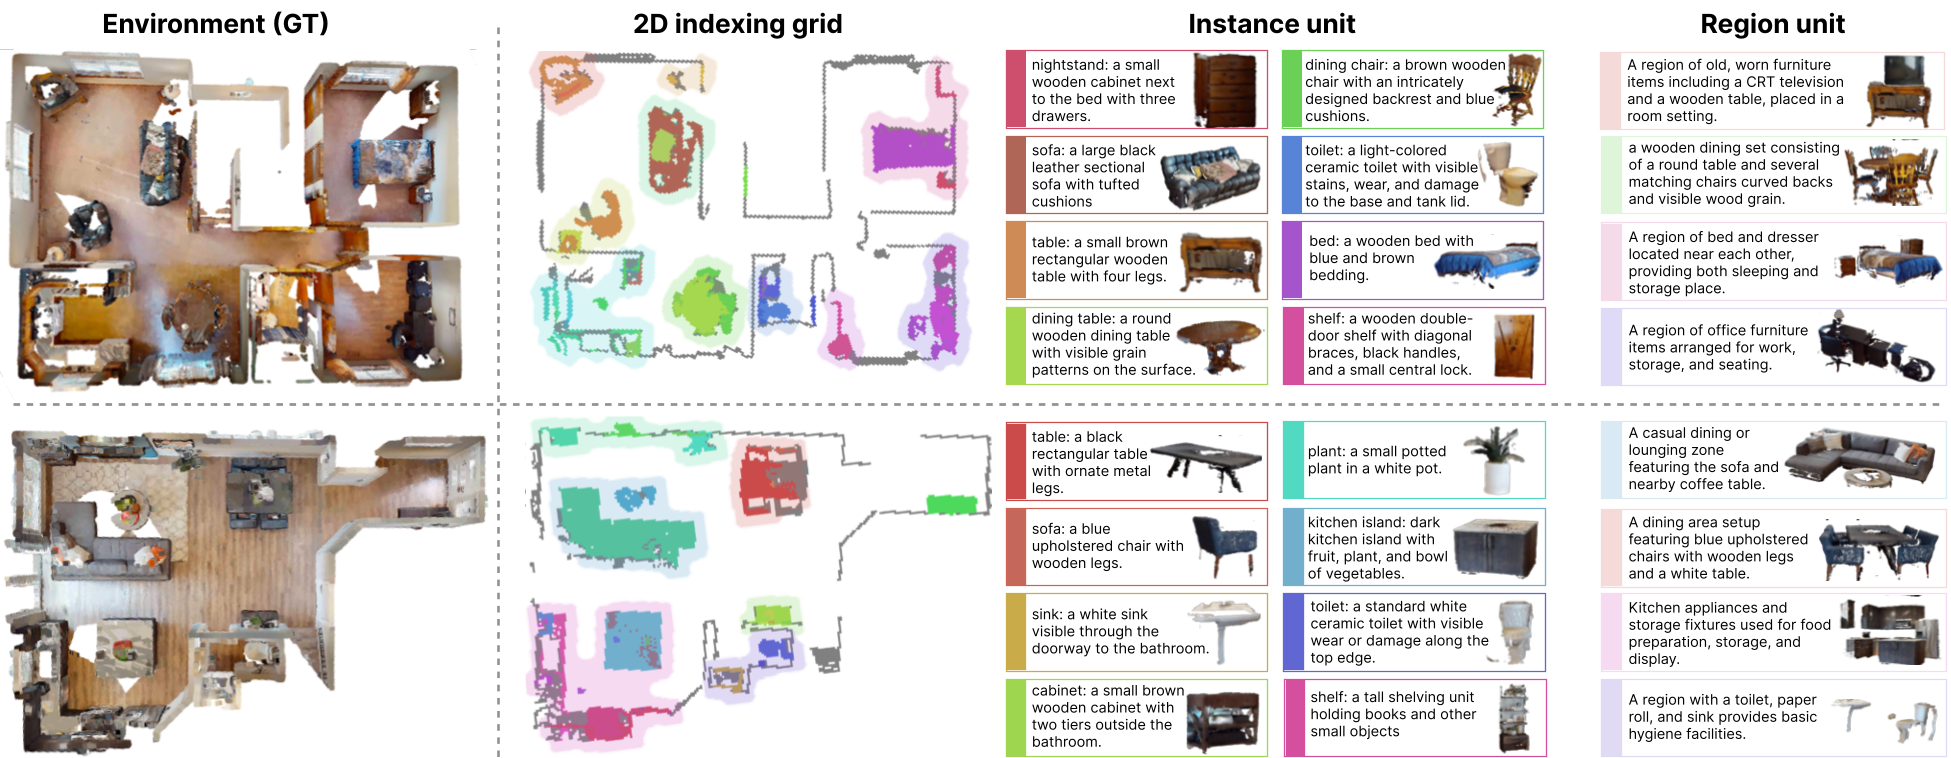 图 2:GLMap 渲染图与真值对比。可以看到,高斯渲染保留了极高的色彩保真度和语义完整性。
4. 深度洞察:为什么 GLMap 值得关注?
- 语义接口的一致性:这是该工作最大的学术贡献。它打破了“特征对齐”的魔咒,将 3D 表征转化为了通用的 2D 渲染图和文本描述。这意味着无论未来 LLM 进化到哪个版本,GLMap 依然能作为其“外部硬盘”直接使用。
- 计算效率的跨越:高斯估计器(Gaussian Estimator)实现了真正的增量式实时更新。对于需要实时反应的机器人而言,这比昂贵的梯度下降优化更有工程价值。
局限性与未来
尽管 GLMap 在静态场景表现优异,但在处理动态物体(如走动的人)时可能存在残影问题。未来如果能将动态高斯技术引入制图,将进一步增强其在复杂人类社交场景中的适用性。
5. 总结
GLMap 不仅仅是一个地图数据结构,它更像是一种具身智能的感知协议。它告诉我们:最强的 3D 表达不一定要通过最复杂的几何计算,而是要通过最能与人类/AI 进行“对话”的语义形式来实现。