
MMDG-Bench:我们真的在多模态领域泛化上取得进步了吗?
Are We Making Progress in Multimodal Domain Generalization? A Comprehensive Benchmark Study
本文推出了 MMDG-Bench,这是首个统一且全面的多模态领域泛化(MMDG)基准测试。该基准涵盖了动作识别、故障诊断和情感分析三大任务的 6 个数据集,评估了 9 种代表性算法,并首次将鲁棒性、缺失模态应对及模型可信度(误分类与 OOD 检测)纳入标准化考量。
TL;DR
在多模态机器学习(Multimodal Learning)蓬勃发展的今天,领域泛化(Domain Generalization, DG)成为了衡量模型能否走出实验室、应对真实世界变化的关键指标。然而,ETH Zurich 等机构的最新研究 MMDG-Bench 泼了一盆冷水:在标准化的严苛评估下,那些号称 SOTA 的专门算法相比简单的 ERM(经验风险最小化)提升微乎其微。本文通过 7,402 次实验告诉我们:多模态系统在面对输入损坏和传感器失效时,远比我们想象的要脆弱。
痛点深挖:被掩盖的“繁荣”
在多模态领域泛化(MMDG)的研究中,大家通常认为整合视频、音频、光流等多维信号能天然提升模型的鲁棒性。然而,该领域长期存在三个严重的黑盒问题:
- 评估不公平:不同论文使用的超参数搜索、数据集分割甚至骨干网络(Backbone)各异,导致算法间的性能对比如同“关公战秦琼”。
- 任务单一化:过度沉溺于视频动作识别,忽略了情感分析、工业诊断等具有完全不同统计特性的模态组合。
- 信任危机:模型在测试集上准确率高,并不代表它在感知失效(如镜头模糊、音频噪声)时仍能给出可靠的预测,更无法在遇到从未见过的样本(OOD)时及时“喊停”。
MMDG-Bench:构建多模态测试的“真理之尺”
为了打破上述僵局,作者提出了 MMDG-Bench,其涵盖了:
- 三大任务维度:动作识别(视觉主导)、故障诊断(传感器主导)、情感分析(文本主导)。
- 九大代表算法:从经典的 ERM 到最新的梯度调制(GMP)、协同蒸馏(MBCD)等。
- 五大评估维度:除了常规准确率,还引入了 Corruption Robustness(抗干扰)、Missing Modality(模态缺失)、Misclassification Detection(误分类检测)和 OOD Detection(分布外检测)。
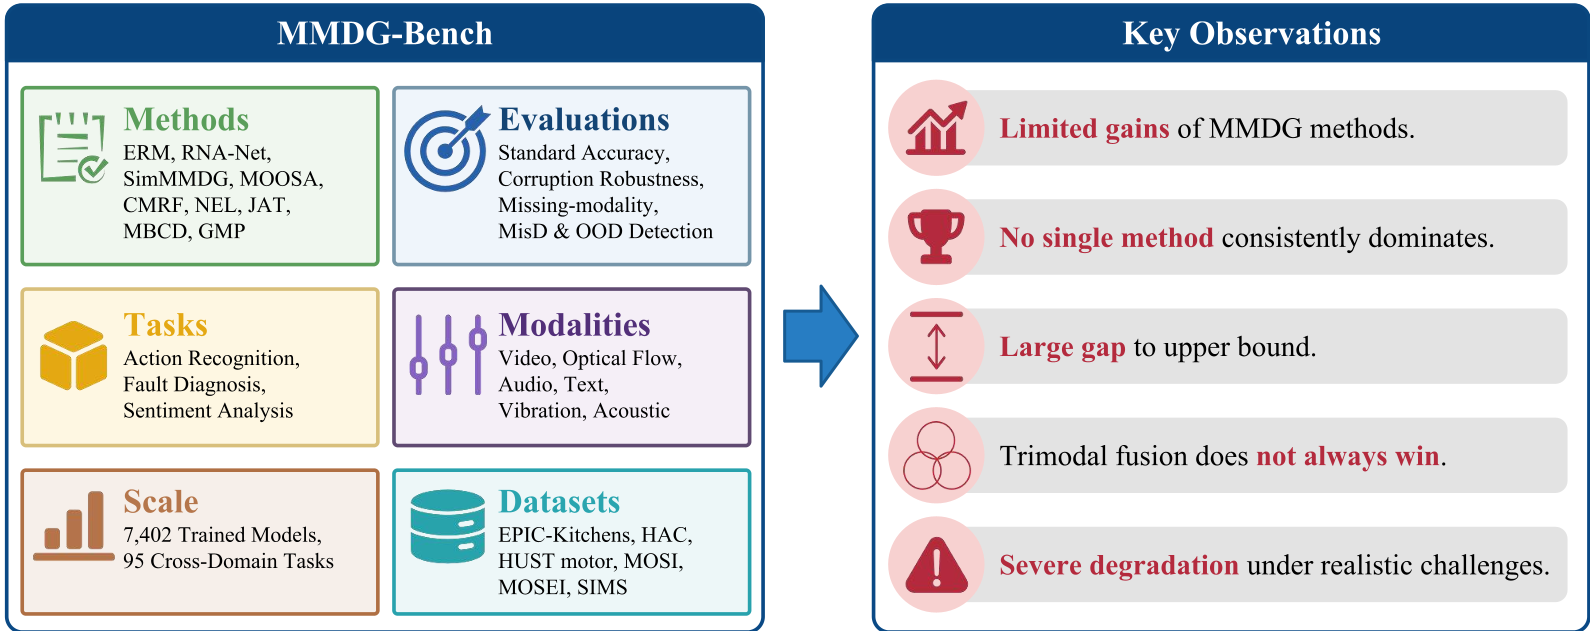 图 1:MMDG-Bench 的多任务、多指标评估框架
核心发现:真相往往令人不安
1. 专门算法的“边际效应”
实验结果表 1 和表 2 显示,在严格调参后,ERM 这个“老将”表现依然极其稳健。在很多跨域任务中,专门设计的复杂算法相比 ERM 仅有不到 1% 的提升,甚至在某些情感分析任务中出现负迁移。这暗示了当前许多 MMDG 论文可能过度拟合了特定的实验设置。
2. 模态并非“越多越好”
一个直觉上的误区是:三模态(V+A+F)一定强于双模态。但 MMDG-Bench 发现,在动作识别中,加入音频有时反而会干扰视听融合的稳定性。这种“模态竞争”现象导致模型在某些域上性能不升反降。
3. 极度依赖“大腿模态”
研究揭示了多模态模型中的“模态分级”:在动作识别中,视频是绝对的“大腿”。一旦视频模态缺失,模型准确率会发生崩塌式下降(-40% 以上);而音频缺失的影响则微乎其微。这表明现有的 MMDG 方法并没有真正实现模态间的互补,而只是学会了依赖某种最强的信号。
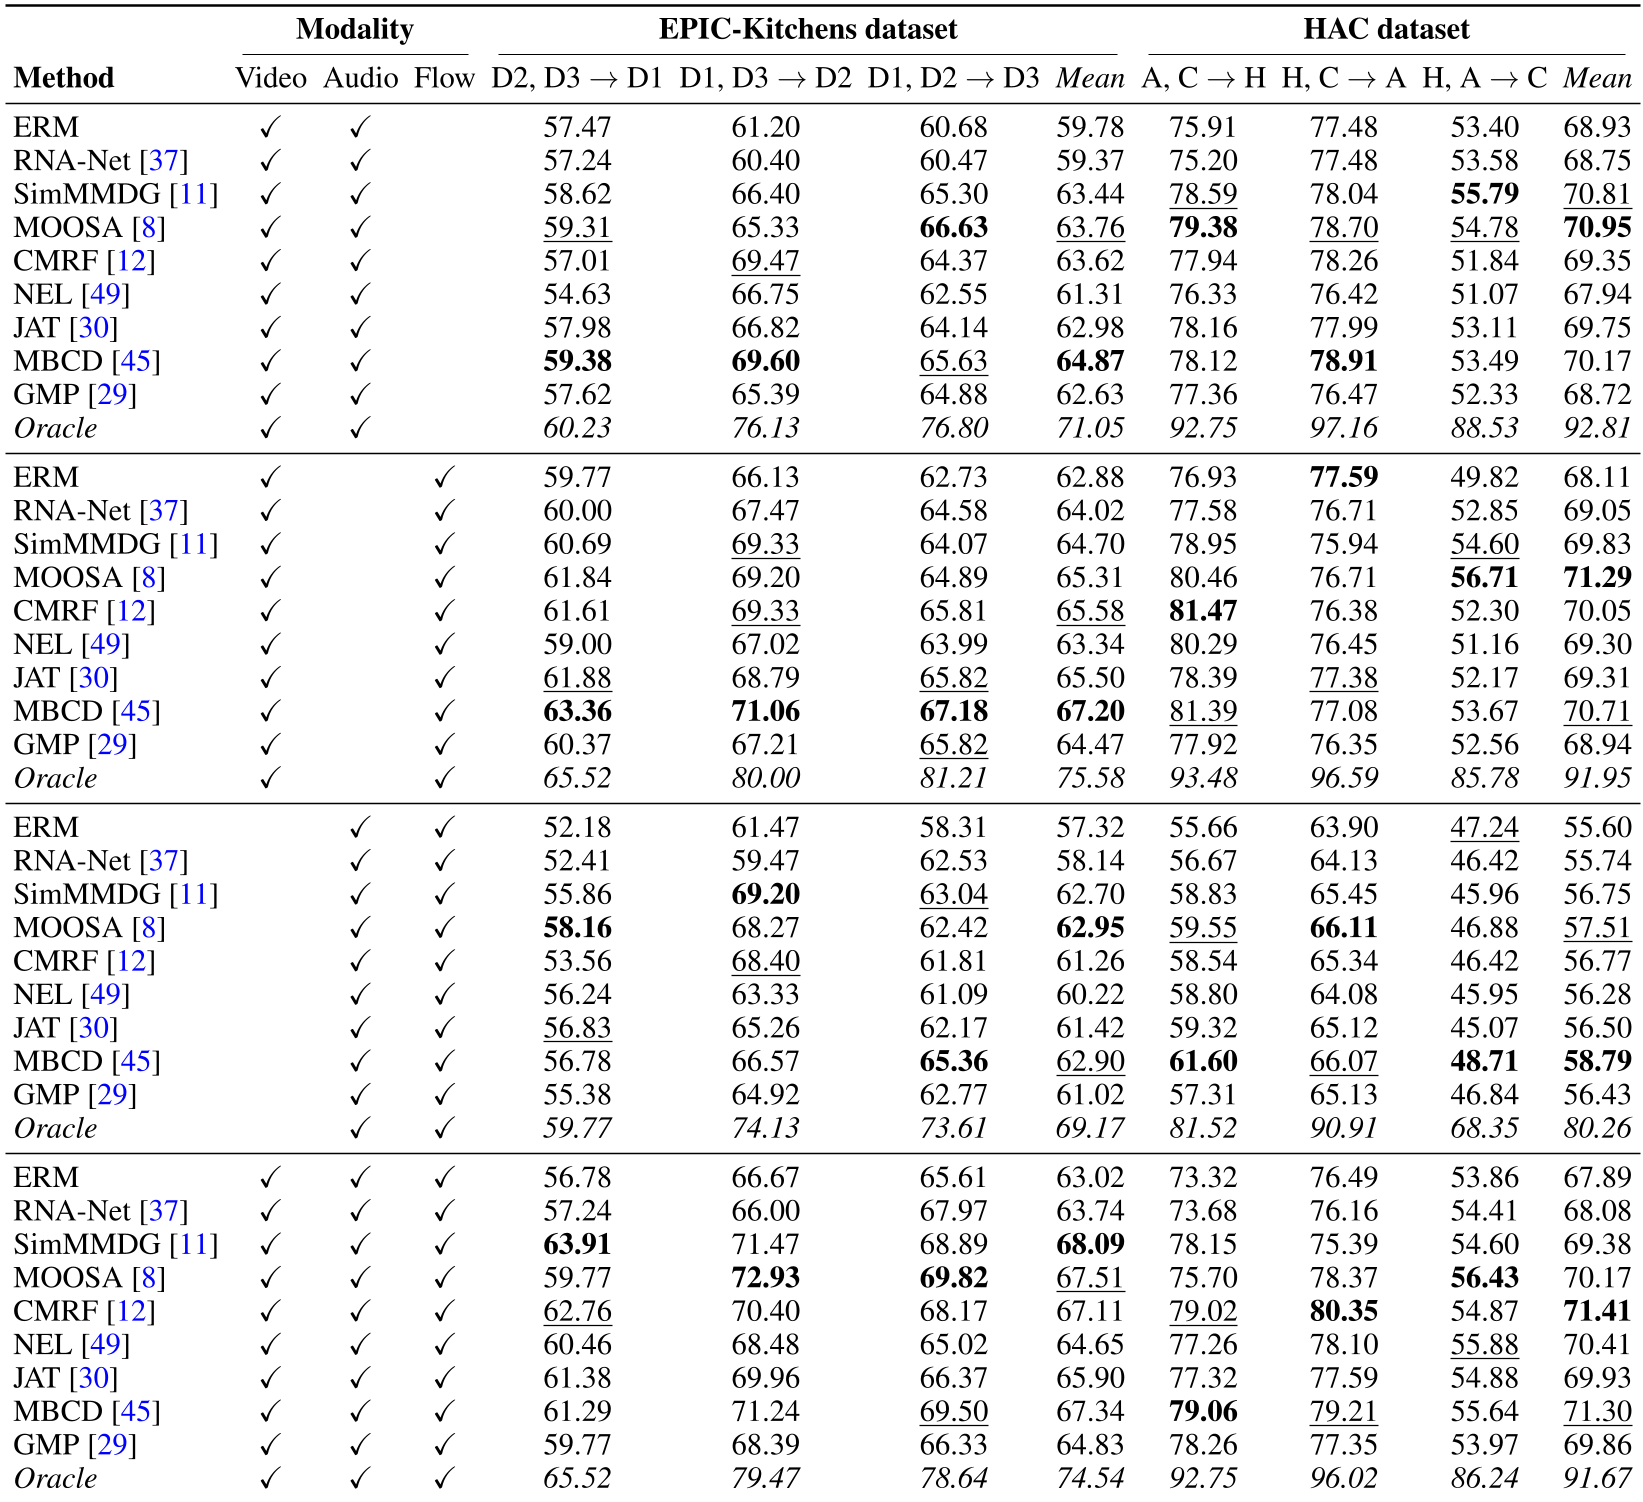 表 1:动作识别任务中的性能对比,由于各方法互有胜负,没有绝对的赢家
深度洞察:可信度与性能的“脱靶”
最令人深思的发现之一是:预测准确率高不代表模型可信。 在 Misclassification Detection(误分类检测)实验中,某些准确率极高的算法(如 CMRF)在判断自己“是否预测错误”时表现极差。这在自动驾驶或医疗诊断等高风险领域是致命的——我们宁愿模型承认自己不知道,也不愿它自信地给出一个错误的答案。
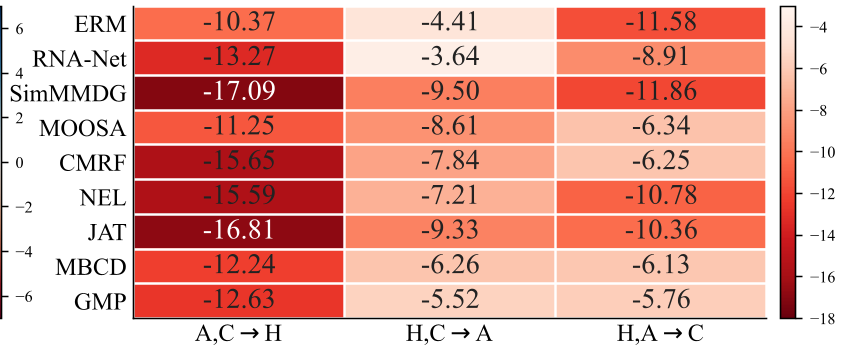 图 2:视频模糊对准确率的剧烈影响,暴露出算法在现实干扰下的脆弱性
总结与展望
MMDG-Bench 的出现不是为了否定前人的工作,而是为该领域确立了更真实的基础。它告诉我们,通过复杂的数学公式强行对齐模态空间,或许不如深入理解模态间的竞争机制和不确定性来源。
未来的研究方向应当转向:
- 自适应融合:如何动态判断当前哪个模态更可靠,并实时调整权重?
- 传感器失效保护:在模态瞬间缺失(Sensor failure)时,模型如何平滑切换?
- 联合优化准确率与置信度:让 AI 系统不仅跑得快,而且“心里有数”。
对于开发者而言,不要盲目迷信各种命名的 SOTA 算法,回归最底层的 ERM 并辅以精细的超参数调优,往往能获得意想不到的 Baseline 强度。