
MUSE:打破视觉 Tokenization 的“零和博弈”,实现生成与理解的流形统一
MUSE: Resolving Manifold Misalignment in Visual Tokenization via Topological Orthogonality
本文提出了 MUSE,一种基于拓扑正交性(Topological Orthogonality)的视觉 Tokenizer 框架。通过在 Transformer 中物理耦合解耦语义(特征值)与结构(注意力拓扑),MUSE 成功打破了视觉重建与语义理解之间的零和博弈,实现了 SOTA 级的生成质量(gFID 3.08)和超越教师模型的理解能力。
TL;DR
在多模态大模型的演进中,将图像理解(Understanding)与生成(Generation)统一到同一个 Token 空间一直是业界的“圣杯”。然而,鱼和熊掌往往不可兼得:追求重建精度会因过多高频细节干扰语义,追求语义抽象则会导致生成图像模糊。本文介绍的 MUSE (Manifold Unification via Structural Embedding) 通过**拓扑正交性(Topological Orthogonality)**巧妙地化解了这一矛盾,不仅实现了 SOTA 级的图像生成,更在理解任务上“青出于蓝”,超越了其自身的教师模型。
痛点深挖:为什么“既要又要”这么难?
现有的统一 Tokenizer(如 UniTok, UniLIP 等)往往在做一种消极的平衡。作者通过流形几何的视角揭示了其本质——流形失配(Manifold Misalignment):
- 语义不变性(Semantic Invariance):要求潜空间“折叠”掉背景、纹理等干扰,提炼核心概念(如“这是一只猫”)。
- 结构等变性(Structural Equivariance):要求潜空间“展开”以保留空间布局、姿态细节,用于驱动高质量重建。
当你把这两个完全相反的梯度推力通过简单的加权求和(Weighted Sum)丢给同一个参数空间时,模型会陷入“优化死锁”。结果就是:要么生成效果好但语义丢失(高频陷阱),要么理解力强但画面模糊(抽象偏见)。
方法论详解:拓扑正交作为桥梁
MUSE 的核心 Insight 极其深刻:结构(Structure)是连接像素与概念的桥梁。 既然结构既包含空间布局又承载语义边界,为何不将它独立出来?
1. 协同块(Synergistic Block)架构
作者提出了梯度正交假设:语义和结构目标可以解耦到不干扰的子空间。在 Transformer 块中,MUSE 进行了如下分工:
- 拓扑流(Topology Stream):更新 参数,负责塑造 Attention 图 (A),学习“怎么看”(物体边界和部组件关系)。
- 语义流(Semantic Stream):更新 参数,负责编码 特征值 (),学习“看什么”(具体含义)。
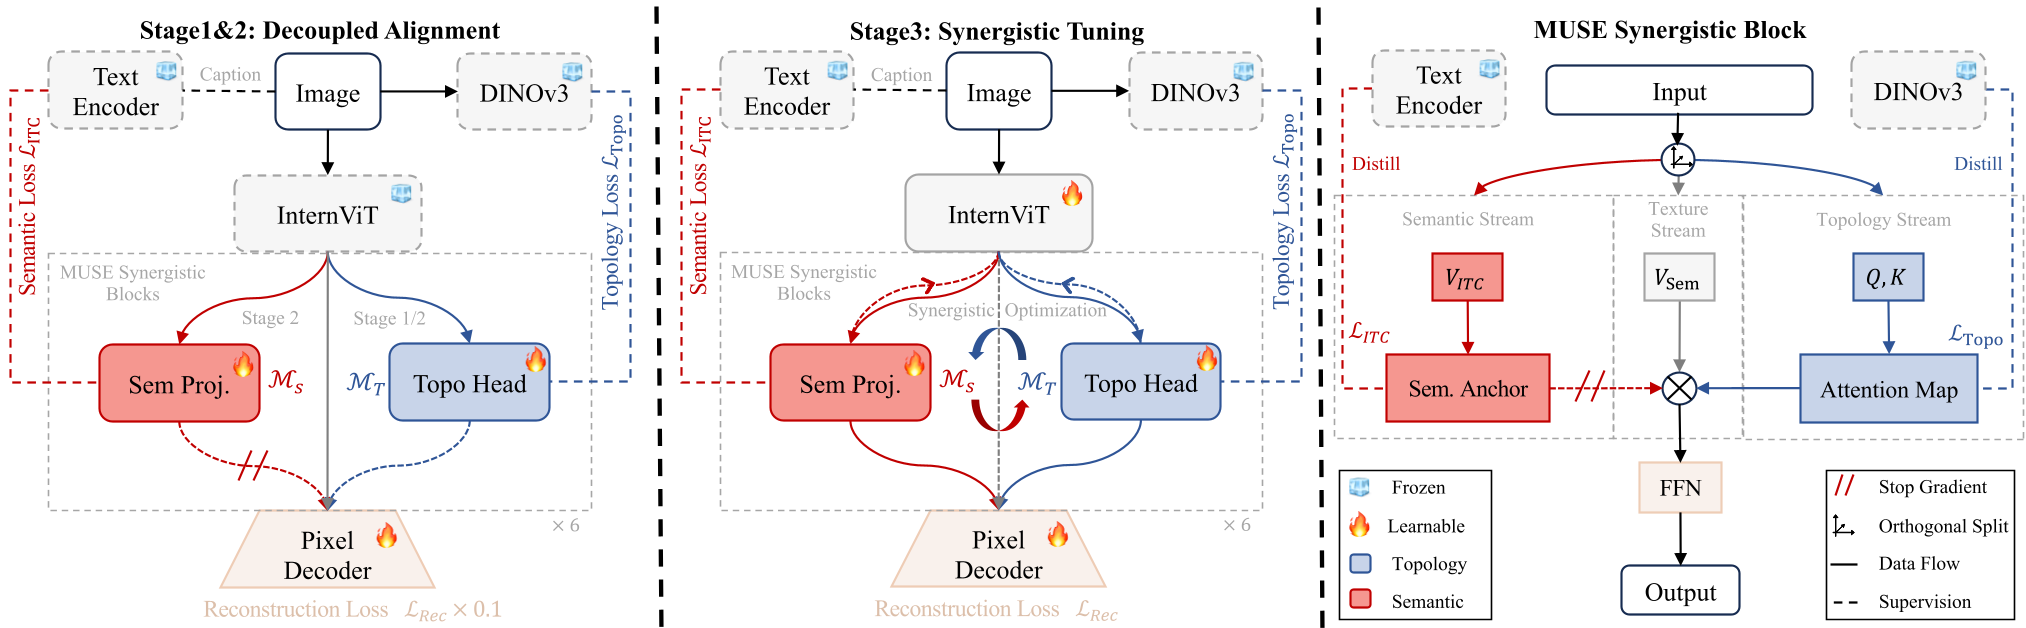 图注:MUSE 架构概览,展示了如何通过 Stop-gradient 算子物理隔绝语义分支与重建梯度的冲突。
2. 三阶段进化
- Stage 1 (Topology Warmup):模仿 DINOv3 的注意力拓扑,建立几何骨架。
- Stage 2 (Semantic Injection):利用噪声对比估计 (NCE) 将视觉 Token 锚定到视觉-语言流形上。
- Stage 3 (Synergistic Tuning):解冻骨架,在重建任务中进行端到端优化,实现真正的互补。
实验与结果:从“死锁”到“共赢”
突破帕累托前沿
实验结果令人震撼。MUSE 在大幅提升重建指标(rFID 0.62, SSIM 0.78)的同时,其理解能力不降反升。在线性探针实验中,MUSE 达到了 85.2% 的准确率,远超其教师模型 InternViT-300M (82.5%)。
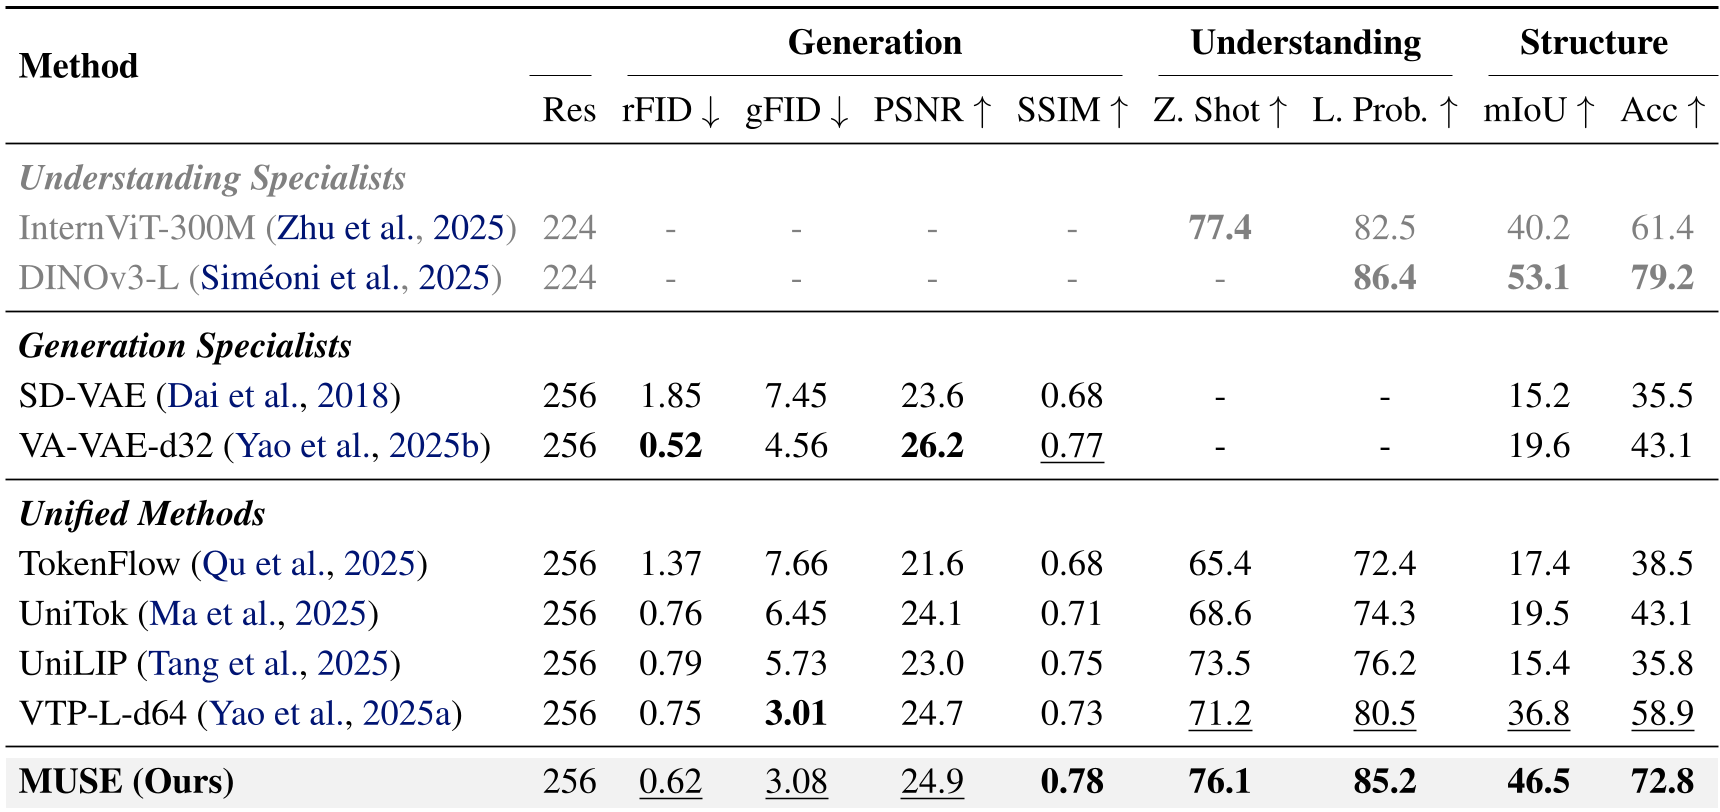 表注:MUSE 在统一方法中建立了全新的战绩标杆,尤其在结构化指标 mIoU 上大幅领先,证明了其捕捉物体形状的精确性。
定性分析:它真的看懂了结构
通过对比 Attention Map(图 7),我们可以看到传统方法 VQGAN 处于“支离破碎”的视角,只关注局部纹理;而 MUSE 则拥有类似 DINO 的“全局结构化视角”,能够精准提取主体轮廓。
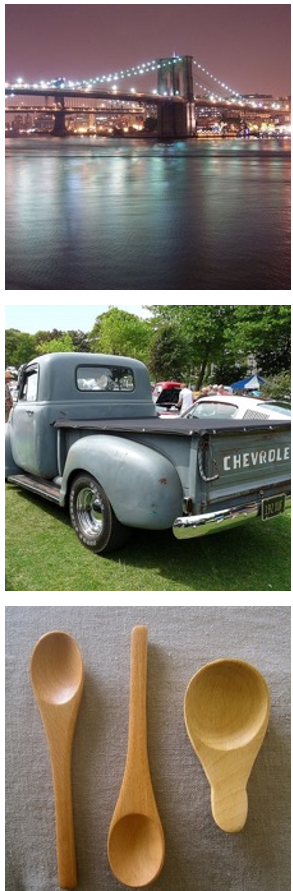 图注:不同 Tokenizer 的注意力拓扑对比,MUSE 展示了极高的结构完整性。
深度洞察与总结
MUSE 的成功带给我们几个关键的行业启示:
- 架构优先于损失函数:单纯通过 Loss 约束(Soft Regularization)无法完全解决梯度冲突。物理上的架构解耦(Synergistic Block)才是通向高效帕累托优化的路径。
- 结构是多模态的终极货币:自监督模型(如 DINO)学到的结构化先验,是连接判别式任务(理解)和生成式任务(重建)的天然粘合剂。
- 不再是零和博弈:MUSE 证明了重建任务如果做得“有结构”,反而能反哺理解任务。
局限性:尽管 MUSE 在 1B/3B 规模表现优异,但其在大规模参数(如 10B+)上的扩展性(Scaling Law)以及对于极高频纹理(如 8K 极细纹路)的保留仍有探索空间。
总结:MUSE 是一篇兼具数学优美感与工程实效性的佳作,它为我们指明了一个方向——一个优秀的视觉编码器,应该既能精准“描摹”世界的线条,又能深刻“读懂”世界的逻辑。