
[HMMT 2025] Nemotron-Cascade 2:30B MoE 模型的奥数金牌之路
Nemotron-Cascade 2: Post-Training LLMs with Cascade RL and Multi-Domain On-Policy Distillation
本文推出了 Nemotron-Cascade 2,一个高性能的 30B MoE 开源模型(3B 激活参数)。该模型采用级联强化学习(Cascade RL)和多领域在线蒸馏(MOPD)技术,在数学(IMO)和编程(IOI/ICPC)竞赛中达到了金牌级水平。
TL;DR
NVIDIA 发布的 Nemotron-Cascade 2 再次刷新了我们对“模型规模”与“智能密度”关系的认知。这是一个仅有 30B 参数(激活 3B) 的 MoE 模型,却在 2025 年国际数学奥林匹克(IMO)和信息学奥赛(IOI)中斩获金牌级表现。其核心秘诀在于一套极其严密的后训练(Post-training)管线:扩展的级联强化学习(Cascade RL)辅以多领域在线蒸馏(MOPD)。
这种“四两拨千斤”的动力从何而来?
在 LLM 的学术界,大家一直苦于一个问题:如果你想让模型数学变强,它的对齐和通用对话能力往往会掉;如果你想让它变“乖”,它的长文本逻辑推理又会退化。
Nemotron-Cascade 2 的作者团队给出的答案是:不要试图在同一个篮子里处理所有奖励信号,而是要分阶段、有顺序地“级联”训练。
1. 痛点:RL 的不稳定性与能力漂移
传统的 RL 往往是全堆在一起训练,或者随机顺序的阶段训练。这会导致模型在学会“解微积分”的同时,忘了怎么“听从指令(Instruction Following)”。此外,RL 依赖的序列级奖励(Sequence-level Reward)极其稀疏,学习效率极低。
2. 核心武器:多领域在线蒸馏 (MOPD)
这是本文最具学术见解的贡献。为了解决 RL 过程中的能力退化,作者在 Cascade 流程中引入了 MOPD。
- 老师筛选:从 Cascade 过程中产生的所有中间 Checkpoint 中,选出每个领域(如数学、编程、对话)表现最强的版本作为“老师”。
- Token 级监督:传统的 GRPO 等算法只给一个最终分数,而 MOPD 提供密集的 Token 级 Logit 对齐。这种“保姆级”教学让模型能在极少的训练步数内(50 步以内)恢复甚至超越老师的能力。
方法论详解:Cascade RL 的进化
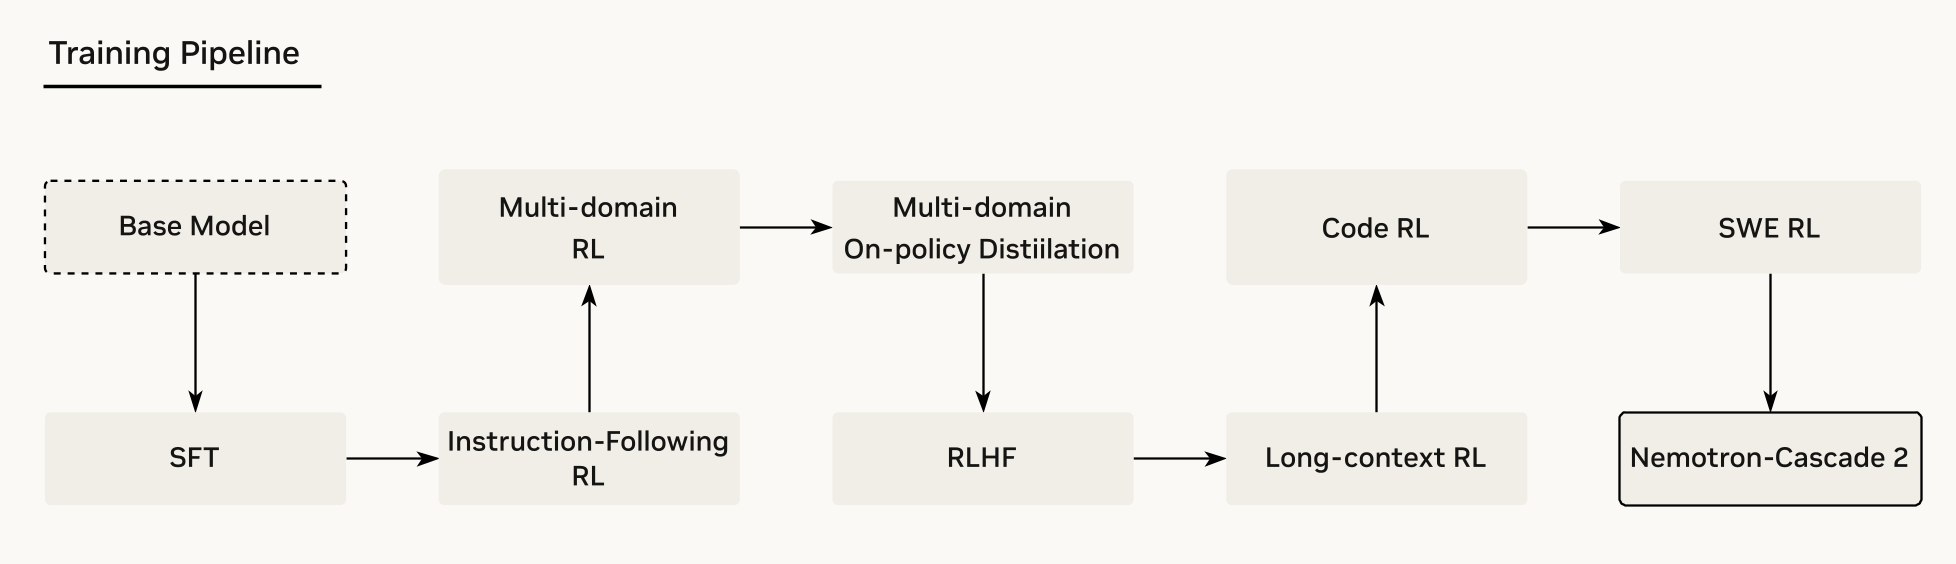
作者重新梳理了 RL 的训练顺序,其背后的物理直觉是:先建立指令遵循的基础,再注入多领域的工具使用能力,最后通过数学和编程 RL 极限压榨逻辑上限。
- 第一阶段:IF-RL。建立基础的指令遵循。
- 第二阶段:多领域 RL。整合 MCQA(选择题)、工具调用等任务。
- 第三阶段:MOPD。这是“大一统”阶段,把上述所有领域的最优基因缝合进一个 Policy。
- 后续阶段:包含 RLHF、长文本 RL 以及最核心的 Code/Math RL。
实验战果:以小博大的极致体现
Nemotron-Cascade 2 的表现堪称惊艳。尽管其激活参数仅为 3B,但在多项硬核测试中直接对标千亿级模型。
- IMO 2025:获得了 35 分(总分 42),达到金牌标准。
- LiveCodeBench:在最新的 LCB 榜单上,它以微小的参数规模,在 Pass@1 准确率上与 Kimi-K2.5 和 Qwen-3.5 等巨兽并驾齐驱。
- 软件工程(SWE):通过执行反馈(Execution-based RL),该模型在处理真实的 GitHub Issue 时展现了极强的自主 Debug 能力。

深度洞察与思考
作为资深主编,我认为 Nemotron-Cascade 2 的价值不仅在于刷榜,而在于其对 “后训练效率” 的极致探索。
- 参数平权:它打破了“只有千亿大模型才能做奥数”的迷思。通过高质量 SFT 数据(如文中提到的 1.9M 编程轨迹)和精准的 RL 奖励引导,小模型也能具备深度思维(Thinking Mode)。
- 蒸馏的新用法:MOPD 的引入证明了,与其追求外部更强的老师模型,不如“向过去的自己学习”——即在 Cascade 各阶段留存最优 Checkpoint 进行自我迭代。
局限性
尽管在推理任务上表现卓越,作者也坦诚该模型在知识密集型任务和多模态 Agent 任务上略逊于 Qwen3.5 等竞争对手。这说明 MoE 的参数总量(Total Parameters)依然决定了知识的广度,而激活参数(Activated Parameters)更多决定了推理的深度。
总结
Nemotron-Cascade 2 是 NVIDIA 在小参数深度推理领域的一次重大胜利。它告诉研究者:数据的质量(蒸馏老师的选择)和训练的次序(Cascade 的排布)远比单纯堆砌算力更重要。 对于追求私有化部署、高性价比推理的开发者来说,这无疑是目前最值得关注的开源标杆。