
Neural Garbage Collection:不仅会思考,更要学会“优雅地遗忘”
Neural Garbage Collection: Learning to Forget while Learning to Reason
本文提出了 Neural Garbage Collection (NGC),一种让语言模型在学习推理(Reasoning)的同时,通过强化学习(RL)自主学习管理和驱逐 KV cache 冗余信息的框架。该方法在 Countdown 和数学竞赛(AMC/AIME)任务中,在 KV cache 峰值压缩 2-3 倍的情况下,依然保持了极高的推理准确度,显著优于传统的启发式驱逐策略。
TL;DR
斯坦福大学的研究团队最近提出了一种名为 Neural Garbage Collection (NGC) 的创新框架。它打破了传统 KV cache 管理依赖手动规则(如“保留最近”或“看注意力权重”)的僵局,转而让模型在强化学习(RL)的驱动下,自主决定哪些记忆该丢弃。实验证明,NGC 在节省 2-3 倍内存的同时,推理性能大幅领先传统方案,真正实现了“边推理边瘦身”。
痛点深挖:膨胀的 KV Cache
在推理模型(如 o1 等 Chain-of-thought 模型)逐渐流行的今天,模型可以靠“多想一会儿”(Thinking Steps)来解决复杂问题。然而,这些思维链条会迅速填满 KV Cache,导致内存溢出。
为什么现有的方案不够好?
- 启发式规则(Heuristics)太死板:像 SnapKV 或 StreamingLLM 这种方法,通常只在测试阶段生效,它们假设注意力权重高的就一定重要,但这在复杂的推理链路中未必成立。
- 代理目标的不一致性:有些方法试图通过蒸馏或重建损失来压缩缓存,但这与最终的“答题正确率”这个核心指标是脱节的。
核心直觉:如果模型能学推理,为什么不能学遗忘?
NGC 的核心思想非常符合 Sutton 的 The Bitter Lesson:能端到端学习到的东西,就不要手写。
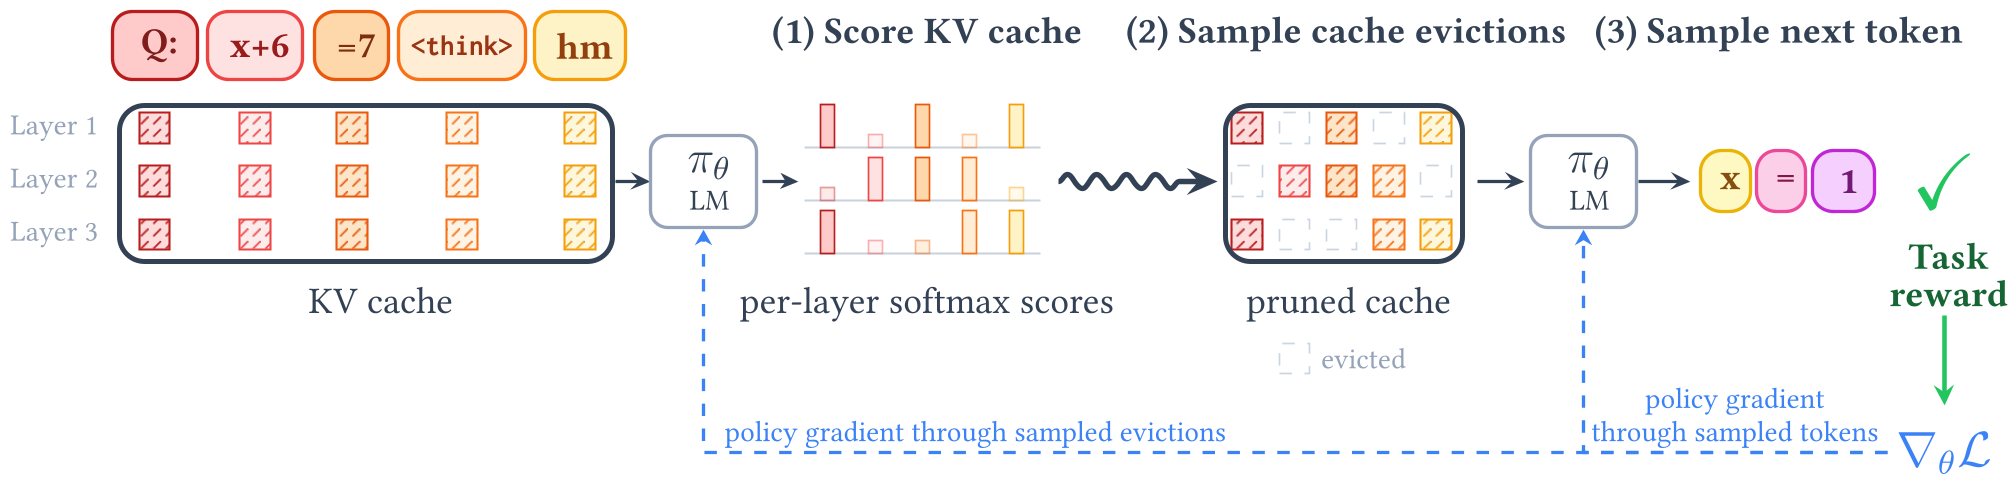
作者将 KV cache 的块级驱逐(Block-level Eviction)建模为一种离散动作。在推理过程中,模型会周期性地停下来,“审视”一遍当前的缓存,采样一批认为不再有用的块进行清理,然后基于精简后的记忆继续思考。
架构解析:Grow-then-Evict 动态
NGC 引入了**“增长-驱逐”**循环。每生成 个 token,就会触发一次驱逐:
- 打分:利用模型原有的 Attention 机制对已知缓存块进行打分。
- 采样:通过 Gumbel-top-k 技巧,以随机但可微(指 policy gradient)的方式选出要保留的块。
- 推理:基于剩下的 Context 继续生成。
技术挑战:如何稳定训练?
在 RL 训练中,动态驱逐会导致“策略偏移(Off-policyness)”。为此,作者设计了 Replay Attention Masks。在反向传播期间,通过特殊的掩码强制让模型看到与采样时完全一致的上下文片段,从而保证梯度的准确性。
实验战况:遥遥领先的效率
在最具挑战性的 Countdown(倒计时运算)任务中,NGC 展现了惊人的自适应能力。
- 准确率对比:在 50% 驱逐率下,NGC 的准确率是 SnapKV 等主流基线的两倍多。
- 泛化能力:即便在测试时使用比训练更严苛的预算(Budget),NGC 的表现也极其稳健。
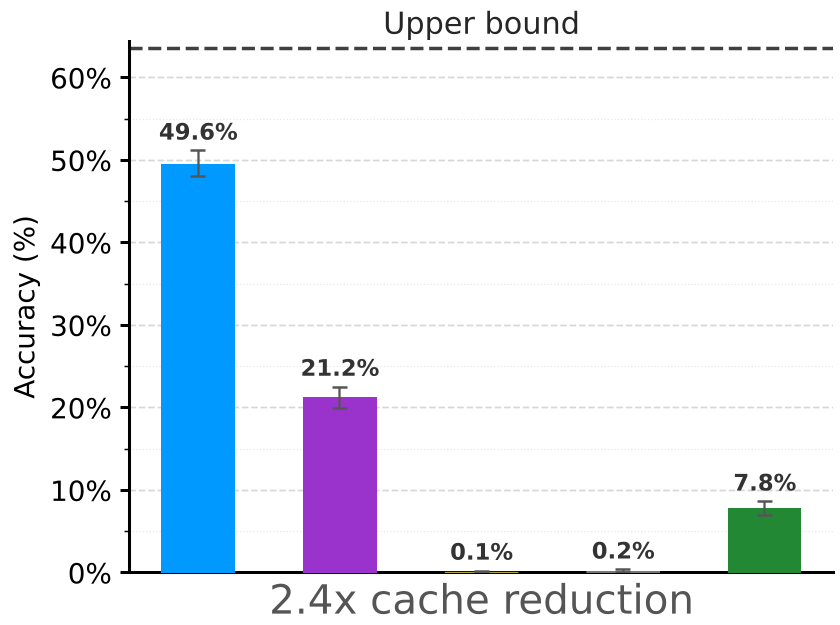
此外,在 AMC/AIME 数学竞赛任务中,NGC 证明了它可以从通用的强化学习信号(如答题对错)中自动进化出各种任务所需的“精简记忆策略”。
深度洞察:预算感知与元认知
论文中一个迷人的点是 Budget-aware Interoception(预算感知)。作者在 Prompt 中告诉模型当前的“内存余额”。这就好比一个人在知道时间紧迫时会自动简化思考流程一样,模型在感知到内存受限时,会展现出更强的防御性记忆管理行为(Generalization)。
局限性与展望
虽然 NGC 目前表现出色,但它依然需要额外的 RL 训练过程(Post-training)。如何将这种能力更早地引入预训练,或者结合 Meta-tokens(文中提到的类似 Gist Token 的压缩 token)进行跨语义的信息压缩,是未来值得探索的方向。
总结
NGC 告诉我们:自我资源管理(Self-management)是通用人工智能的重要拼图。 真正强大的模型不应该只是无止境地消耗算力,而应该学会像人类一样,在有限的“工作记忆”中精炼出最关键的逻辑火花。
注:本文图片引用自 arXiv 论文原文。