
neuralCAD-Edit:填补 AI 在专业 3D CAD 编辑领域的巨大鸿沟
neuralCAD-Edit: An Expert Benchmark for Multimodal-Instructed 3D CAD Model Editing
本文推出了 neuralCAD-Edit,这是首个由专家 CAD 工程师收集的 3D CAD 模型编辑基准测试。该研究通过捕获专业设计师在 CAD 软件中进行实时语音、手势指向和绘图的视频,构建了一个高质量的多模态指令数据集,用于评估基础模型在复杂工程设计中的编辑能力。
TL;DR
Autodesk Research 推出了 neuralCAD-Edit,这是第一个基于专家级工程师真实操作的多模态 3D CAD 编辑基准测试。与以往仅支持“文本框输入”的研究不同,该工作捕捉了设计师通过说话、手语、绘图进行实时交互的视频指令。实验表明,即便当前最顶尖的 GPT 5.2 在理解专业几何指令方面仍远逊于人类,性能差距高达 50% 以上。
背景定位:从“生成”迈向“编辑”的深水区
现在的 AI 已经能根据文字生成简单的 3D 模型,但在工业制造中,**编辑(Editing)**才是核心。工程师需要根据反馈微调公差、修复 B-Rep 边界或调整装配逻辑。此前,缺乏一个能够模拟真实设计场景(即“像教新同事一样下达指令”)的高质量数据集。
痛点深挖:为什么文本指令是不够的?
在复杂的 3D 空间中,仅靠文字(如“把左边的螺丝孔加深”)往往存在歧义。专业设计师习惯于在屏幕上画圈、指点部件的同时进行口头描述。
- Prior Work 的局限:大多使用合成文本(Synthetic Text)或静态图片,忽略了指令在时间轴上的同步性(Temporal Alignment)。
- B-Rep 复杂性:CAD 采用边界表示法(B-Rep),对几何精度要求极高,传统的网格生成模型完全无法适应下游制造。
方法论详解:模拟专家的多模态工作流
作者设计了四个维度的采集协议:
- 交互模态:从纯文本到静动态绘图(Static/Temp Drawing),捕捉了鼠标轨迹与语音的时间戳对齐。
- 输入轴向:覆盖了“死模型”(Dumb models)与参数化模型,以及单体零件与复杂装配体(Assemblies)。
- 人类基准:除了请求者的操作,还引入了另一名未参与请求的人类专家作为对比基准,确保任务的可行性。
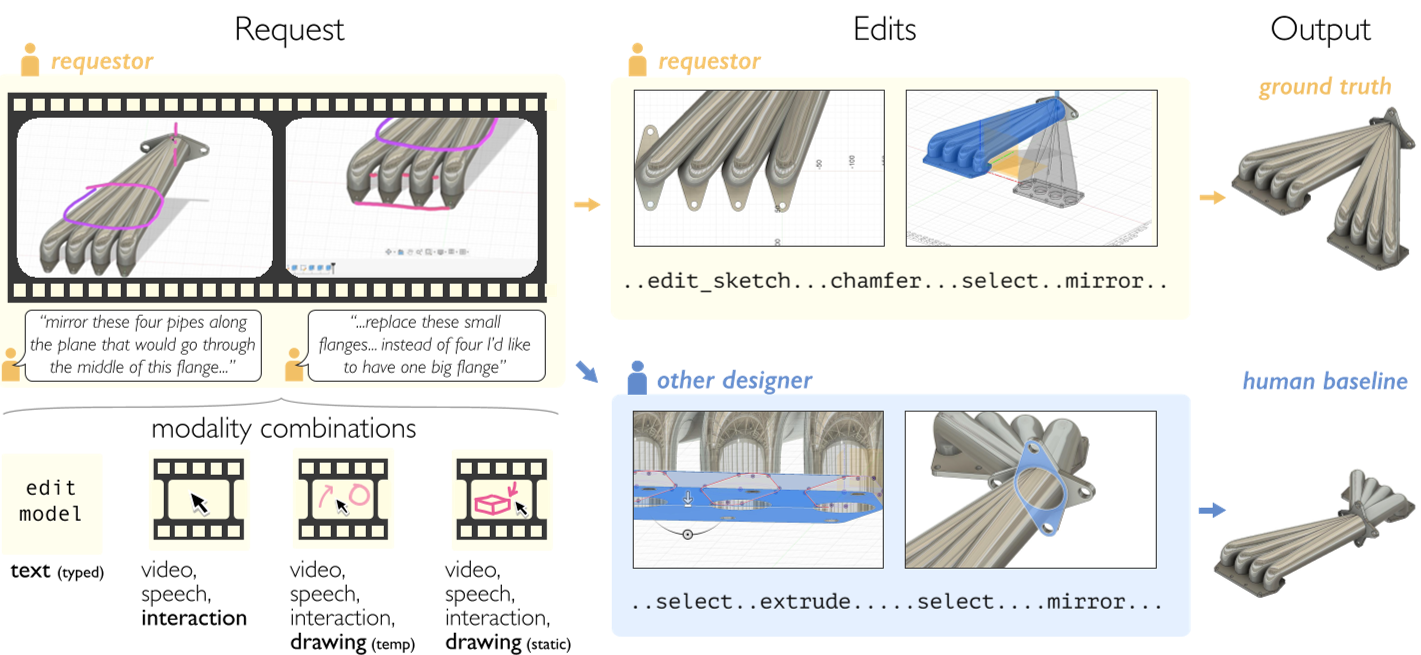 图 1:人类专家通过多模态交互下达指令,模型需通过解析视频/音频生成 CadQuery 脚本完成编辑任务。
核心实验与结果:AI 的“空间盲区”
研究评估了 GPT 5.2、Gemini 3 Pro 和 Claude Sonnet 4.5。
- 巨大的性能鸿沟:由人类专家评审的“接受度”指标显示,AI 表现惨淡(见下表)。
- 视觉推理失效:AI 经常发生“位置错乱”。例如在无人机模型中,模型虽然知道要复制螺旋桨,却无法正确地将其定位到支臂末端。
- 测试时间缩放(Test-time Scaling)不足:人类在面对更难的任务时会花更长时间思考,但除了 GPT 5.2 外,其他模型基本处于“一拍脑袋出结果”的状态。
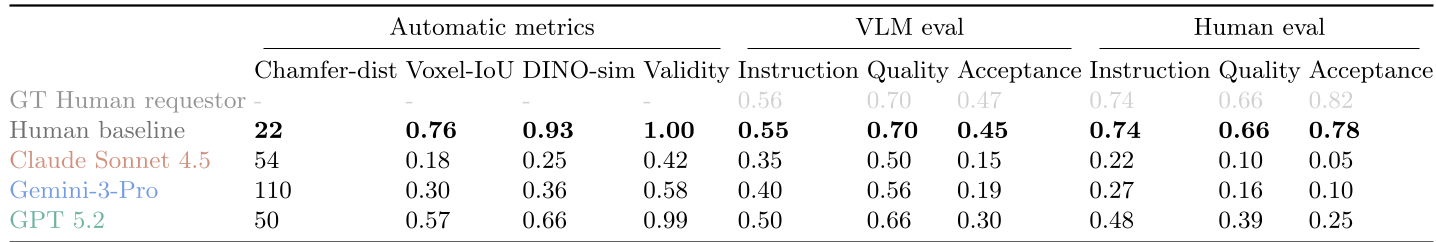 表 1:AI 在 Instruction Following(指令遵循)与 Quality(质量)上均远落后于人类基准。
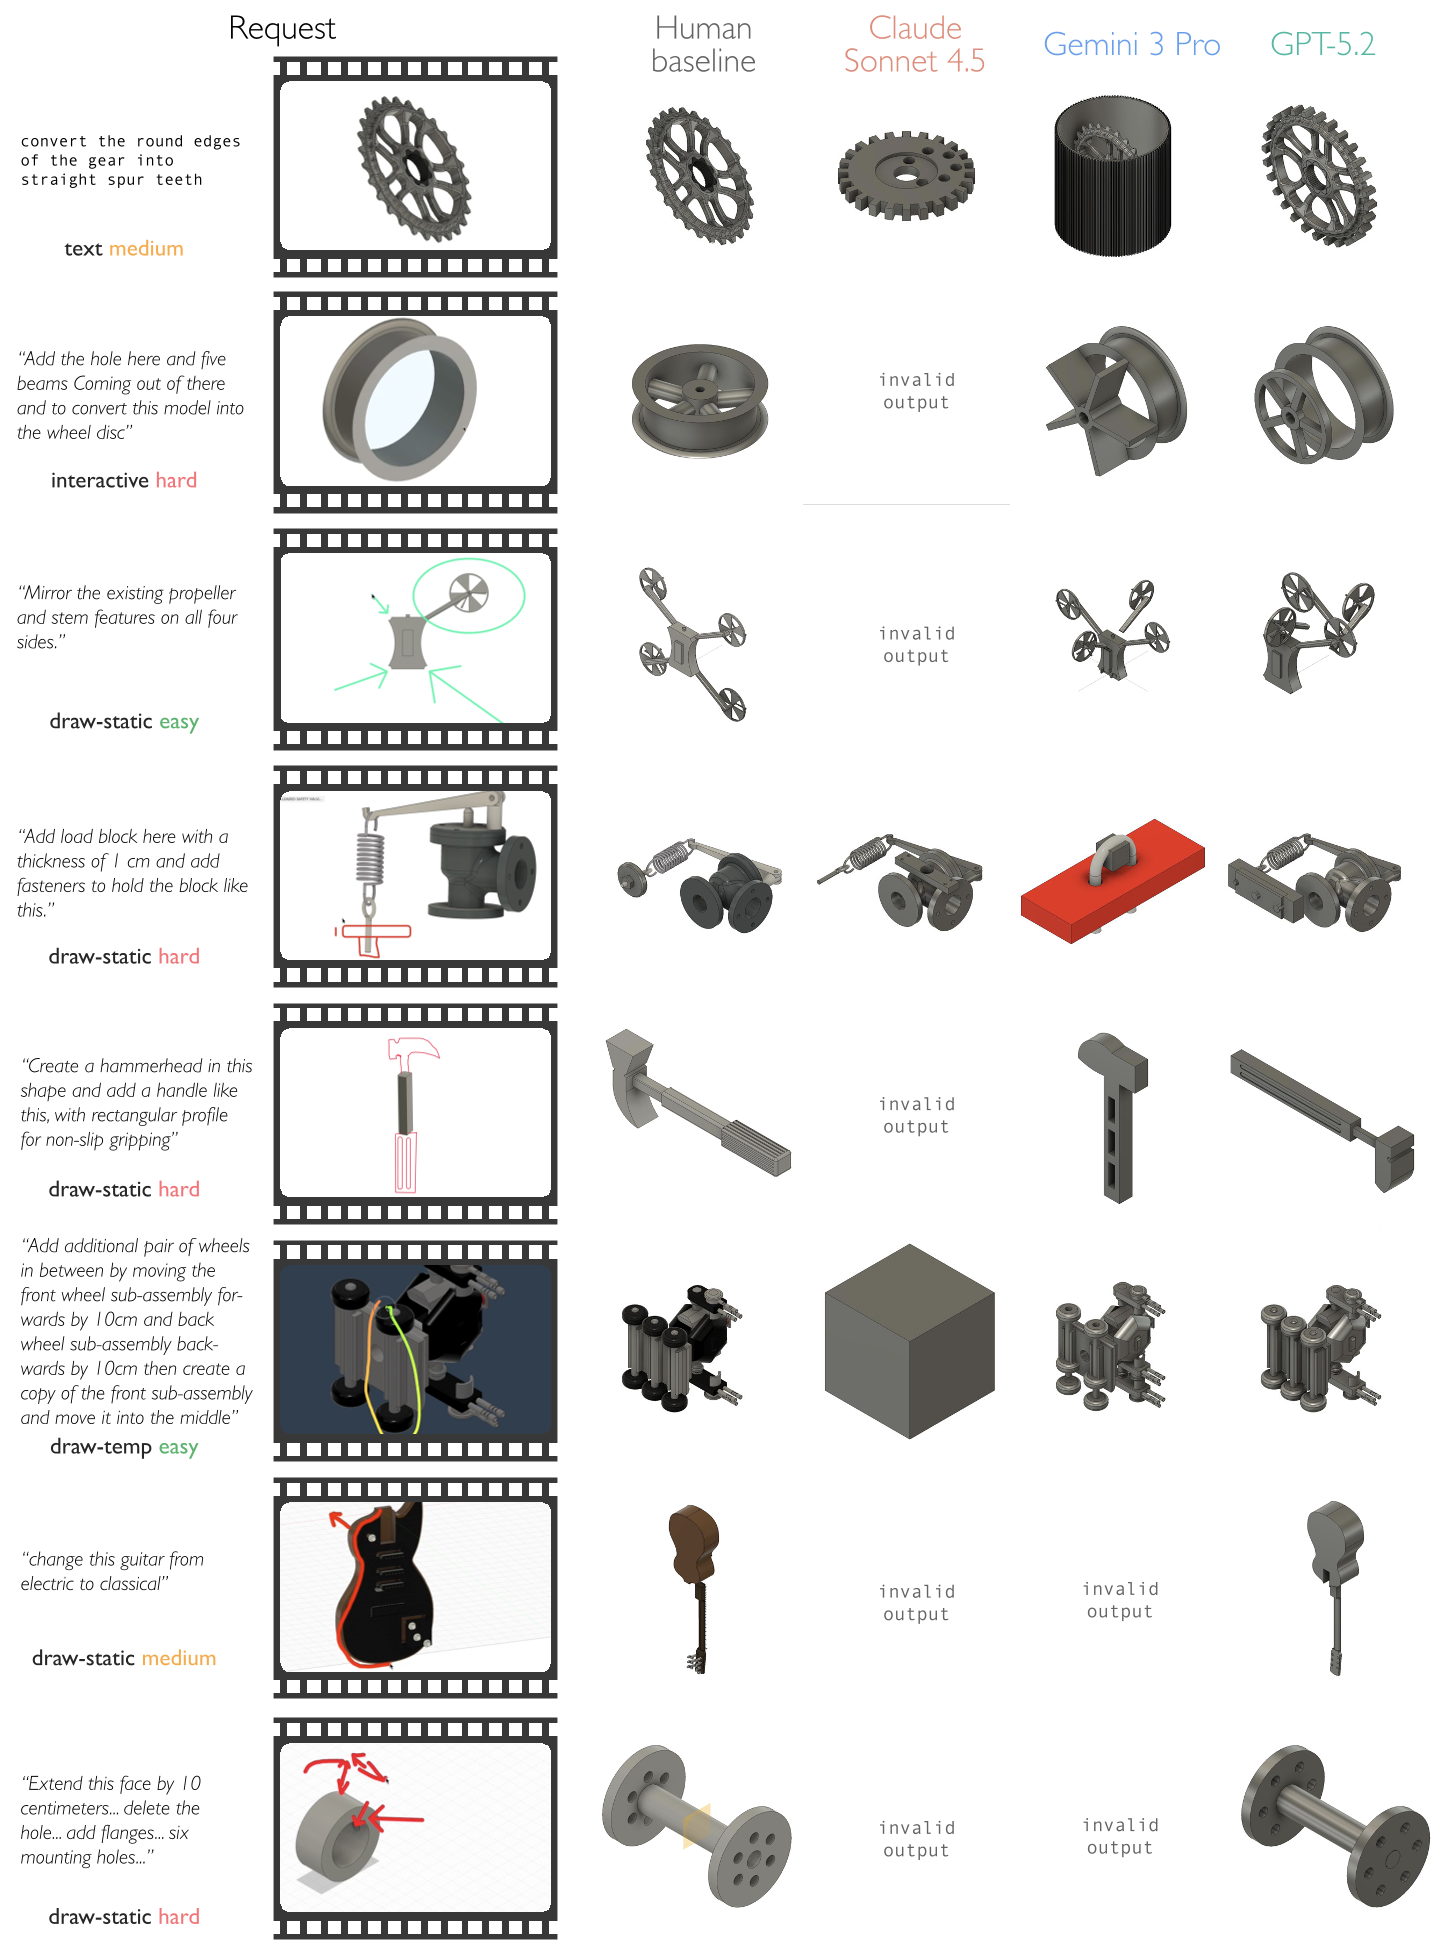 图 2:AI(Claude/Gemini)在处理包含绘图指令的复杂几何修改(如下方的无人机和齿轮)时屡屡受挫。
深度洞察:未来的 AI CAD 应该长什么样?
- 统一的多模态表征:模型必须学会理解“绘图轨迹”与“口头代词”(如“这里”、“那块”)之间的对应关系。
- 自适应推理:AI 需要学会在环境中模拟运行(代码测试),通过反馈不断调整 CAD 参数,而非一次性生成。
- 评价机制的革命:传统的 3D 几何指标(如 Chamfer Distance)与人类专家的真实审美/工程逻辑仍有很大偏差,我们需要更精准的 VLM Evaluate。
总结
neuralCAD-Edit 不仅仅是一个数据集,它是对现有 General-purpose 基准测试的一次有力补充。它证明了即便是在大语言模型时代,面对高精度、多模态、强逻辑推理的垂直工程领域,通用基础模型仍有漫长的路要走。