
LGF:深度流模型与神经符号文法的碰撞,重塑物理方程发现系统
Neuro-Symbolic ODE Discovery with Latent Grammar Flow
本文提出了 Latent Grammar Flow (LGF),一种用于从数据中发现常微分方程 (ODE) 的神经符号框架。该方法结合了文法量化自编码器 (GQAE) 和离散流模型 (Discrete Flow Model),在离散潜空间中实现 SOTA 级别的公式发现精度。
TL;DR
研究人员提出了一种名为 Latent Grammar Flow (LGF) 的新框架,通过将数学方程映射为离散文法序列,并利用生成式流模型(Flow Models)进行引导采样,成功解决了从噪声数据中发现隐式/显式 ODE 的难题。相比于传统的黑盒模型,LGF 发现的方程不仅精度高,更具备物理上的稳定性约束和可解释性。
1. 背景与动机:为什么符号回归这么难?
传统的符号回归(Symbolic Regression)方法(如遗传算法 PySR 或基于 Transformer 的模型)在处理微分方程时往往存在两个痛点:
- 语法合法性与效率的矛盾:基于搜索的方法在巨大的公式树空间里如大海捞针;基于生成的方法(Transformer)则容易生成语法错误的表达式。
- “差之毫厘,谬以千里”的语义鸿沟:在数学符号上仅一个正负号之差的两个方程,其动力学轨迹可能完全不同(例如稳定系统变发散)。
LGF 的作者敏锐地察觉到:我们需要一个能够理解“物理行为”的潜空间,而不仅仅是字符排列。
2. 核心技术:离散文法流 (LGF) 的三板斧
2.1 文法量化自编码器 (GQAE)
作者摒弃了变分自编码器(VAE)的连续空间,采用了 Finite Scalar Quantization (FSQ)。通过将方程解析为文法规则序列并进行离散量化,LGF 极大地缩小了搜索范围,并保证了生成的每一条序列都严格符合数学语法。
2.2 行为潜距离 (Behavioural Latent Distance)
这是本文最具洞察力的创新点。作者利用 Wasserstein 距离 定义了“行为损失”:
- 逻辑:不直接对比方程的长相,而是对比它们产生的“向量场”分布。
- 效果:强制让那些动力学特性相似的方程在潜空间中聚集,从而让模型可以通过流模型精准定位到正确的“物理区域”。
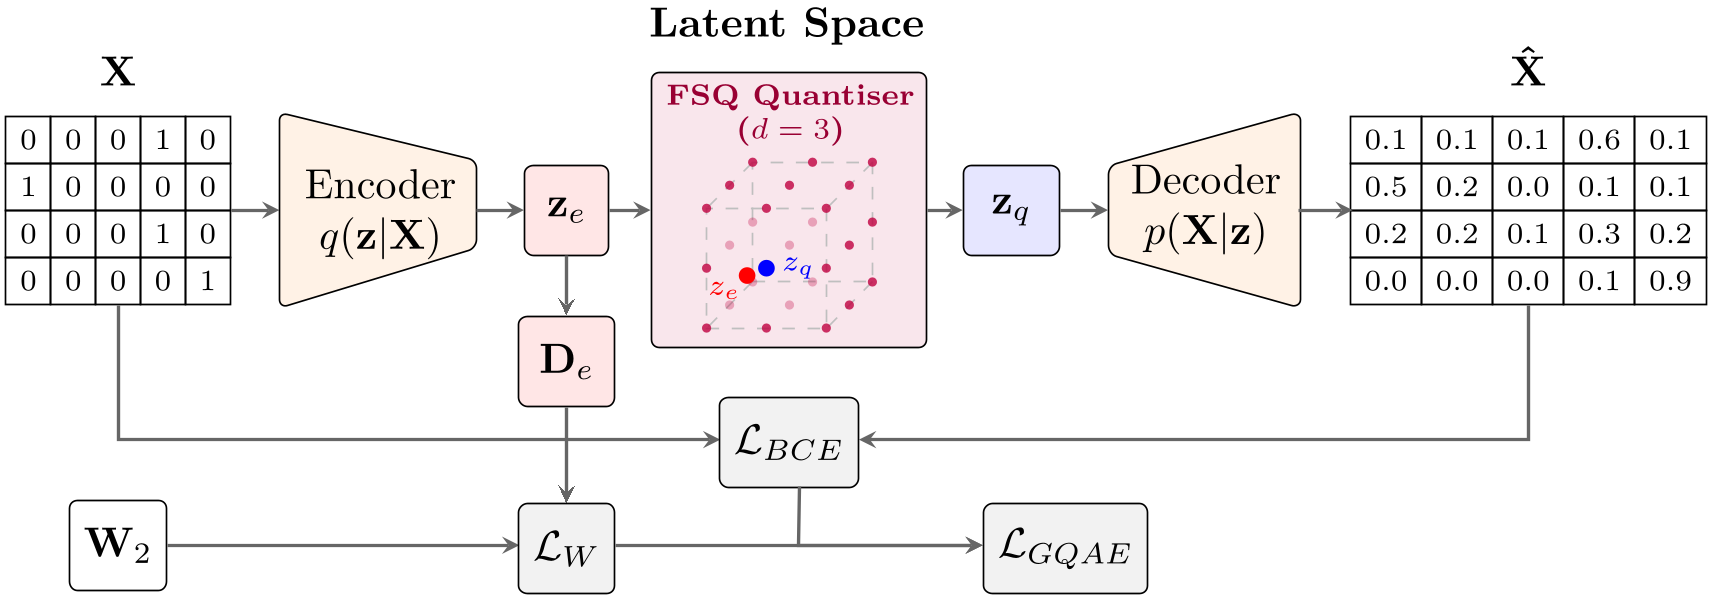 图 1:GQAE 训练流程,展示了如何结合 Wasserstein 距离重塑潜空间。
2.3 受控离散流采样 (Discrete Flow Guidance)
LGF 引入了离散流匹配 (Discrete Flow Matching) 并在采样阶段注入了“预测器引导”。这意味着用户可以告诉模型:“我需要一个二阶的、且在局部平衡点稳定的方程”。模型会根据这些约束,调整流的方向,向高概率区域演化。
3. 实验见证:吊打传统基准
在包含单摆、Duffing 振子、Van der Pol 振子等经典动力系统测试中,LGF 展现了极强的采样效率。
- Benchmark 1 (简单 ODE):虽然 PySR 在绝对精度上领先,但 LGF 在保持复杂度的平衡上表现更佳。
- Benchmark 3 (噪声与部分观测量):在面对包含加速度指标的复杂振子系统时,LGF 展现了压倒性优势。PySR 由于缺乏对方程解的验证,往往陷入局部最优,而 LGF 依靠内层标量优化 (Nelder-Mead) 和流模型的全局引导,精准还原了真实方程。
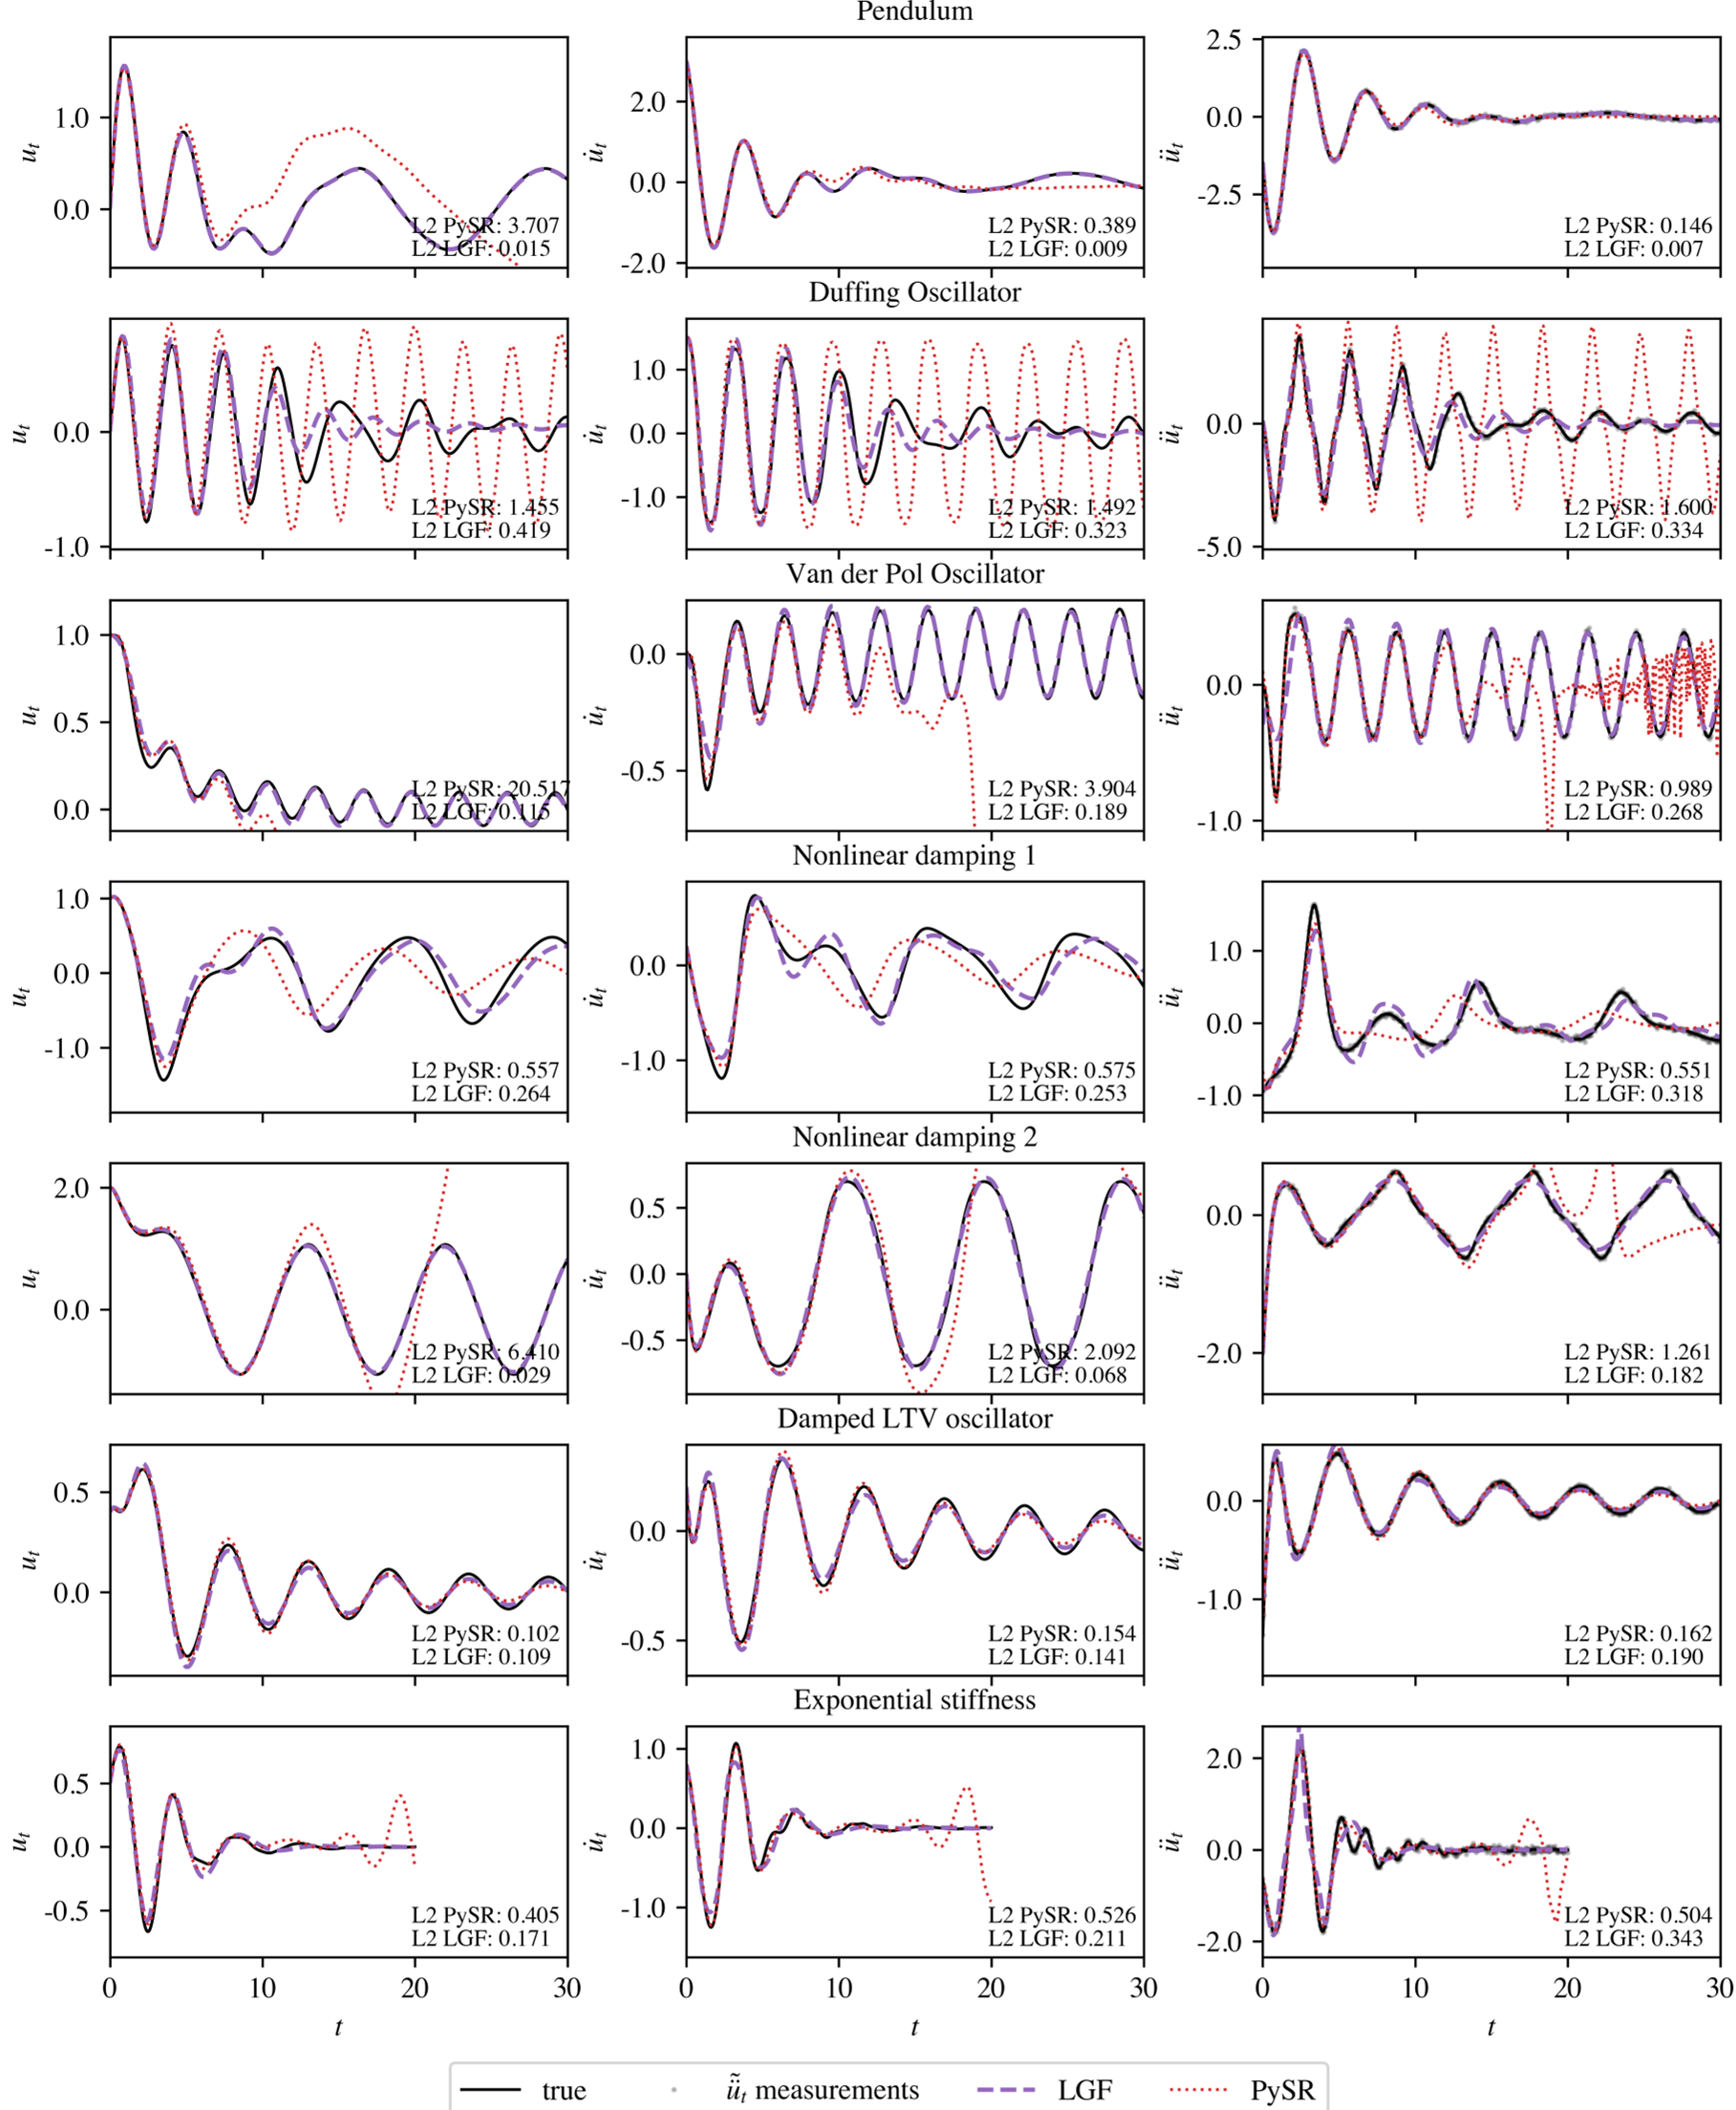 图 2:Benchmark 3 中各动力系统的轨迹还原对比,LGF(蓝色)几乎完美贴合真值。
4. 深度洞察
LGF 的成功揭示了一个趋势:未来的 AI for Science 不再是纯粹的加大数据量,而是如何将人类积攒了几百年的“符号约束”转换为模型可理解的“正则化”。
虽然 LGF 目前主要针对单自由度 ODE,但其架构具有极强的扩展性。通过调整 Grammars,它可以轻松扩展到偏微分方程(PDE)或多变量系统。
局限性:
- 依赖预先定义的 Context-free Grammar。
- 离散流模型的训练需要一定的预计算开销(用于评估向量场相似度)。
5. 总结
Latent Grammar Flow 为科学方程发现开辟了新路径。它不仅证明了生成式模型能写出正确的方程,更证明了通过离散流引导,我们可以让 AI 具备初级的物理直觉。