
LoPE:看似“胡言乱语”的拉丁文扰动,如何让大模型突破推理瓶颈?
Nonsense Helps: Prompt Space Perturbation Broadens Reasoning Exploration
本文提出了 LoPE (Lorem Perturbation for Exploration),一种通过在 Prompt 空间引入随机伪拉丁文 (Lorem Ipsum) 扰动的重采样框架。该方法旨在解决强化学习算法 GRPO 中的“零优势问题”,在多项数学推理评测中显著提升了模型性能(如 Qwen2.5-Math-7B 提升 +6.20 pts)。
TL;DR
在强化学习(RL)提升 LLM 推理能力的道路上,**“全军覆没”的采样(Zero-advantage)**一直是算力浪费的罪魁祸首。本文提出的 LoPE (Lorem Perturbation for Exploration) 给出了一种极其简单却精妙的解法:既然模型在当前 Prompt 下死活想不出答案,那就往 Prompt 里加一段“胡言乱语”的伪拉丁文(Lorem Ipsum)。这种 Prompt 空间的微小扰动 竟然能引导模型探索出全新的推理路径,在 MATH 和 AIME 等硬核数学竞赛题上实现了显著的性能飞跃。
痛点深挖:GRPO 的“零优势”尴尬
目前的推理模型(如 DeepSeek-R1 采用的 GRPO)极其依赖组内相对优势。如果模型针对一个问题采样的 G 个回答全部错误,所有样本的 Advantage 都会变成 0,梯度也随之消失。这不仅浪费了宝贵的 Rollout 算力,更让模型失去了通过难题“进化”的机会。
虽然可以通过增加采样预算或调高温度(Temperature)来强行探索,但作者发现:Logit 空间的探索(调高温度)往往会导致输出过于混乱(Perplexity 激增),而无法真正触及正确的逻辑链。
核心直觉:上下文扰动唤醒“正交路径”
作者的 Insight 在于:LLM 对输入上下文极其敏感。通过在 Prompt 前部添加一段任务无关的、低困惑度(Low-perplexity)的伪拉丁文,可以轻微改变模型的激活状态,从而在不干扰原题语义的前提下,强制模型跳出原有的“逻辑死循环”。
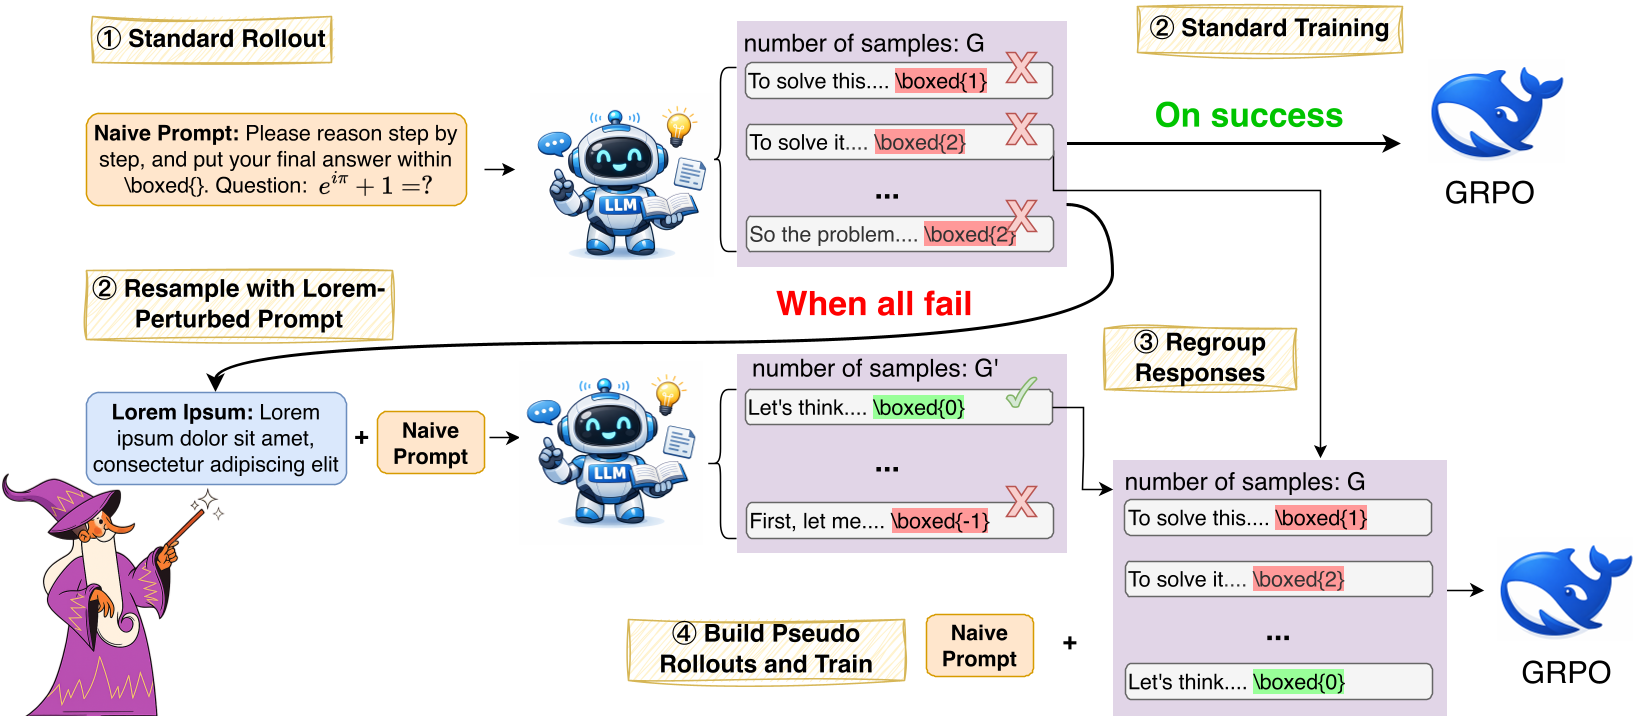 图 1: LoPE 框架概览。当标准采样失败时,通过插入 Lorem Ipsum 触发重采样,并进行信号整合。
方法论:LoPE 的三大利器
- Lorem 扰动采样:在重采样阶段,将 100-300 个词的 Lorem Ipsum 拼接到原文前。实验证明,拉丁文作为扰动项效果最好,因为它既符合自然语言结构(低困惑度),又由于不是英语,不会与数学题干产生语义干扰。
- 优势整形 (Advantage Shaping):为了不让少数“幸运”搜到的正确答案被淹没,LoPE 在计算 Advantage 时会将所有采样的失败样本都计入分布,从而成倍放大稀有正确解的奖励值(提升 2-5 倍)。
- 策略整形 (Policy Shaping):针对 Off-policy 带来的问题,修正重要性采样比例(Importance Sampling Ratio),确保那些在原模型看来概率极低但却是关键推理步骤的 Token 得到足够的学习权重。
实验战绩:全线飘红
在 Qwen 系列模型上的测试显示,LoPE 在 AIME 2024/2025 等顶级竞赛题上的提升尤为巨大:
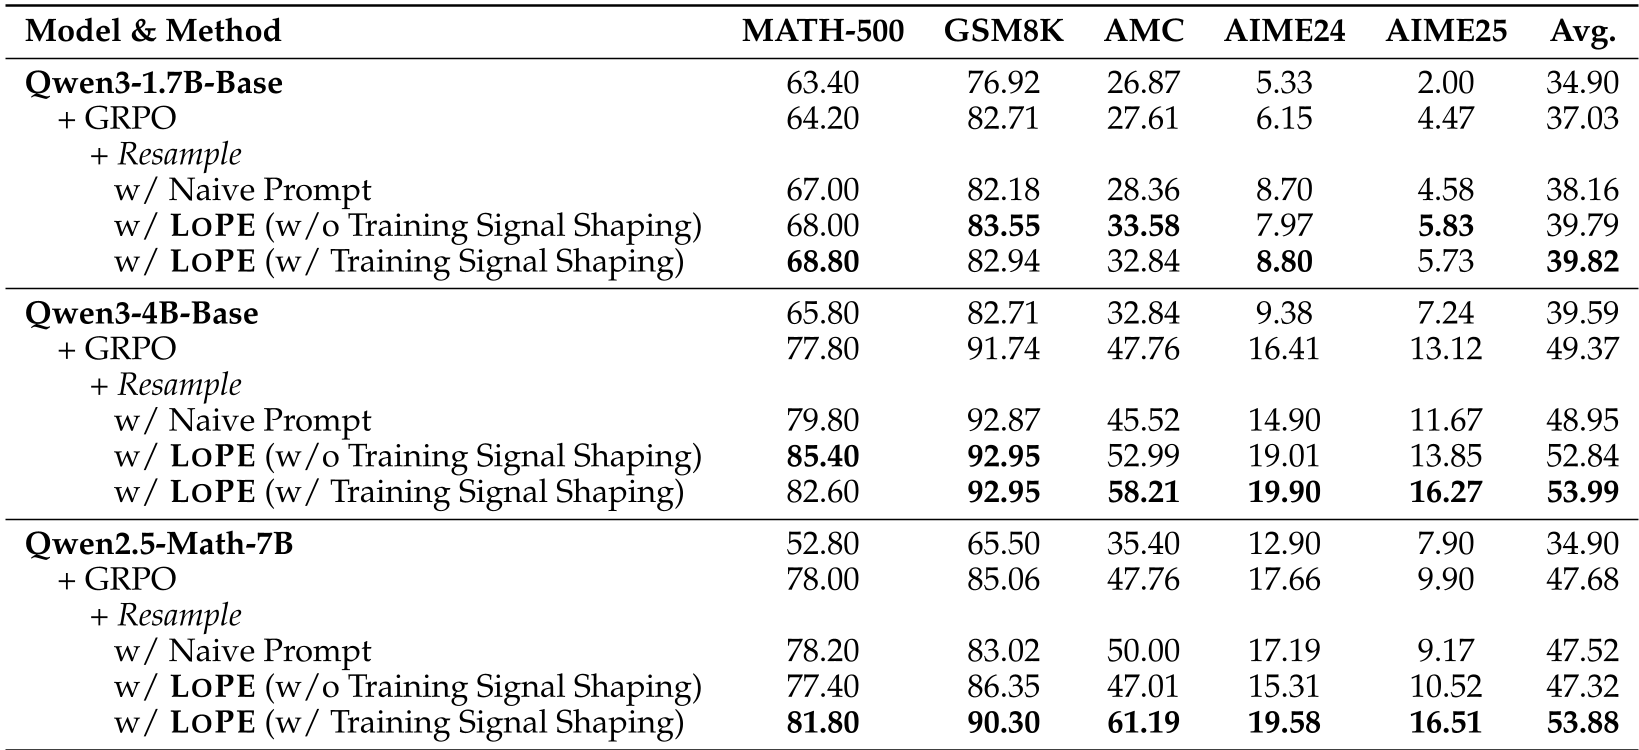 表 1: LoPE 与标准 GRPO 及普通重采样的对比,展示了其在模型规模扩大时的强劲韧性。
更令人惊讶的发现是,单纯的随机 ASCII 码或英文单词扰动效果并不如伪拉丁文。如图 5 所示,Lorem Ipsum 的困惑度(Perplexity)分布极窄且靠近自然语言分布,这证明了“高质量的噪声”才是有效探索的关键。
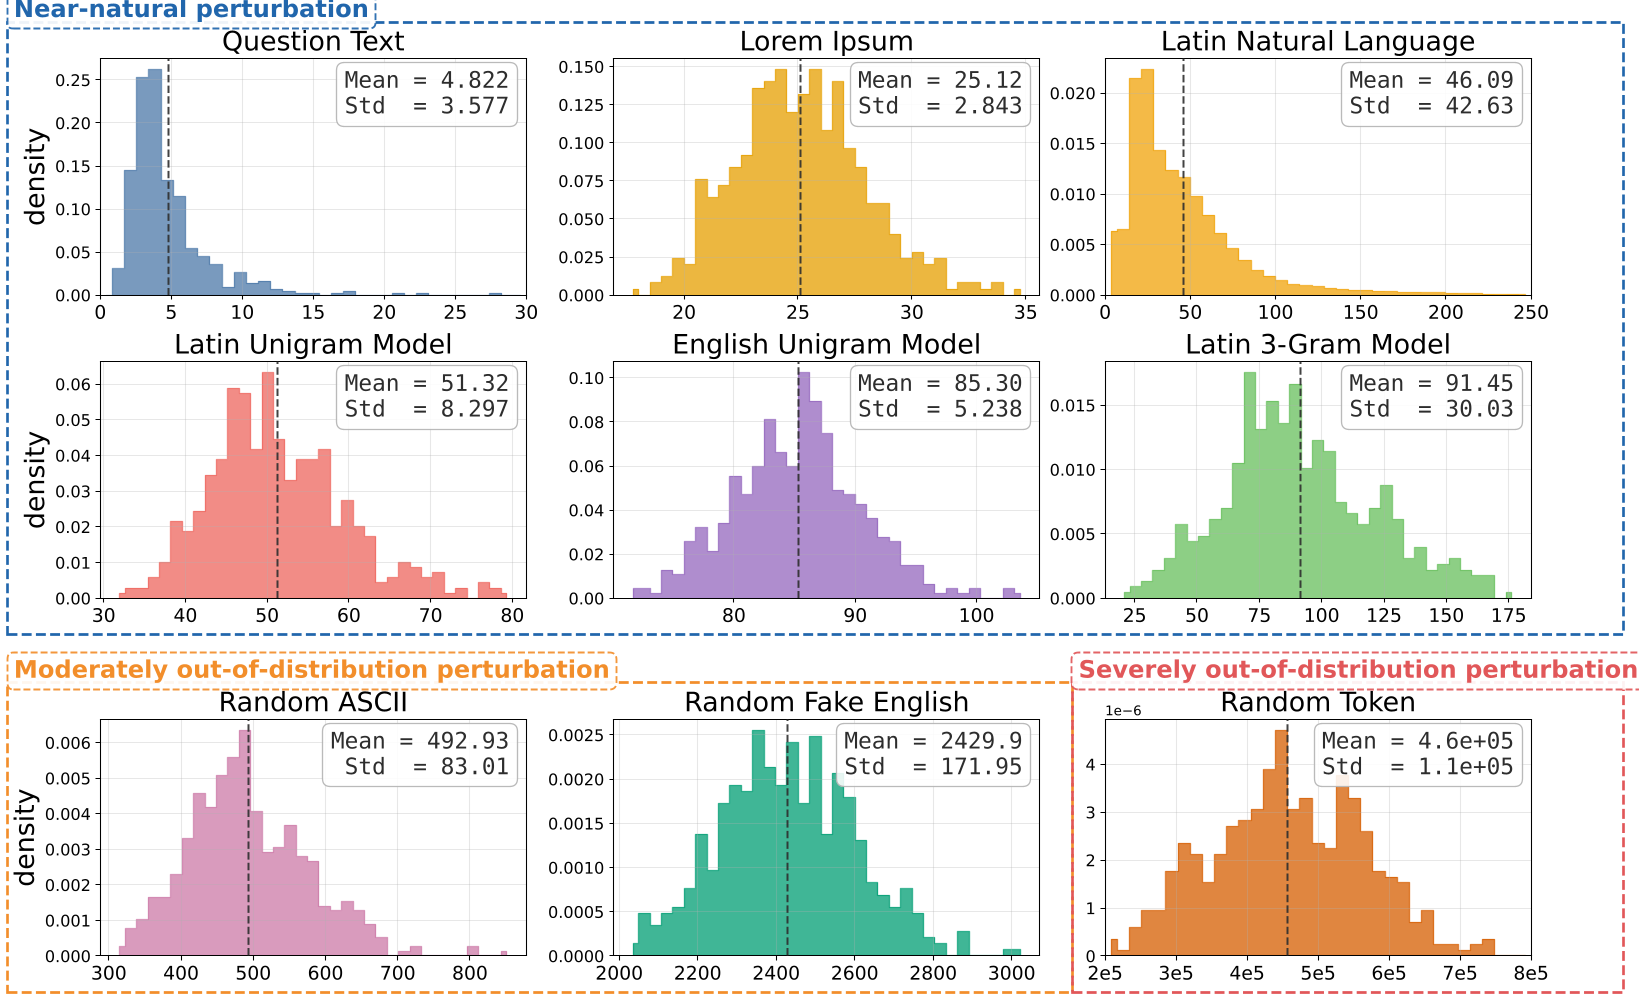 图 5: 不同扰动形式的 Perplexity 分布。Lorem Ipsum 表现出最接近自然语言的特性。
深度洞察与总结
LoPE 的成功揭示了 LLM 训练中的一个深刻道理:模型不是“不会”做这道题,而是被固有的 Prompt 偏好限制在了错误的决策边界内。
- 核心贡献:提出了一种比 Logit 采样更高效的 Prompt 空间探索策略。
- 局限性:虽然解决了探索问题,但这种“胡言乱语”前缀在推理侧的额外计算开销仍需优化;同时,如何全自动生成针对特定题目的“最优扰动”尚待研究。
- 展望:这一思路可以推广到图像生成、代码除错等一切需要 RL 且存在数据稀疏问题的领域。有时,一点点“噪音”正是打破僵局的关键钥匙。