
Odysseus:强化学习助力视觉语言模型突破 100+ 步长程游戏决策
Odysseus: Scaling VLMs to 100+ Turn Decision-Making in Games via Reinforcement Learning
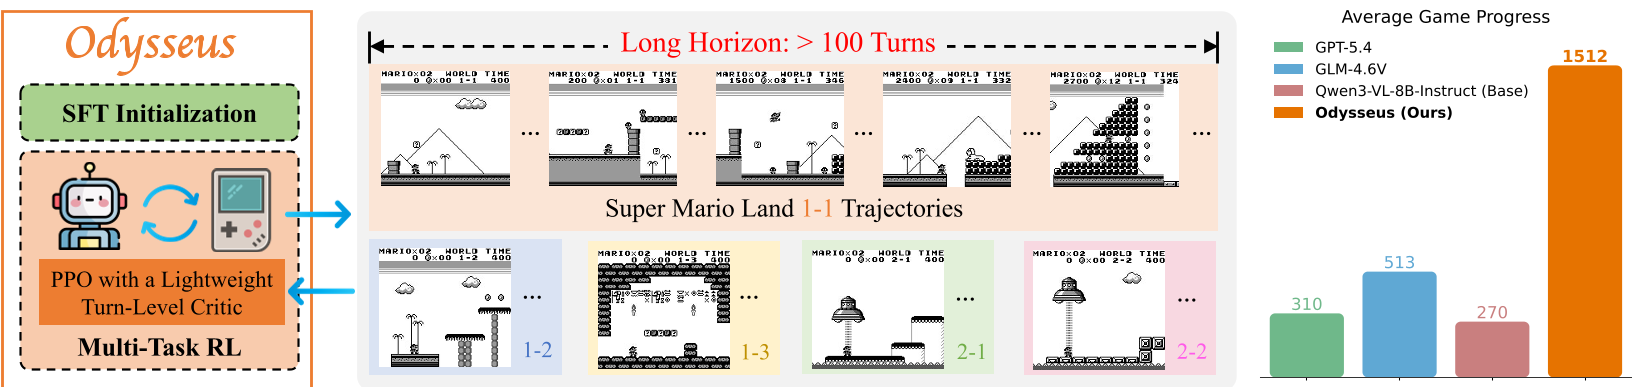
本文提出了 Odysseus,一个旨在将视觉语言模型(VLM)扩展到长程(100+ 步)游戏决策任务的强化学习框架。通过在《超级马里奥大陆》中应用改进的 PPO 算法,Odysseus 在游戏进度上达到了 SOTA 水平,显著超越了 GPT-4o 等顶尖模型。
TL;DR
普林斯顿大学的研究团队发布了 Odysseus,一个专门为 VLM(视觉语言模型)设计的开放式强化学习框架。该工作成功地将 VLM 智能体在复杂动作游戏《超级马里奥大陆》中的决策长度从以往的几十步扩展到了 100 步以上。相比于闭源的 GPT-4 等模型,Odysseus 在游戏进度上实现了约 3-5 倍 的跨越式增长,并展示了惊人的跨游戏泛化能力。
痛点深挖:为什么 VLM 玩不好马里奥?
目前将 VLM 转化为具身智能体(Embodied Agent)主要面临两大障碍:
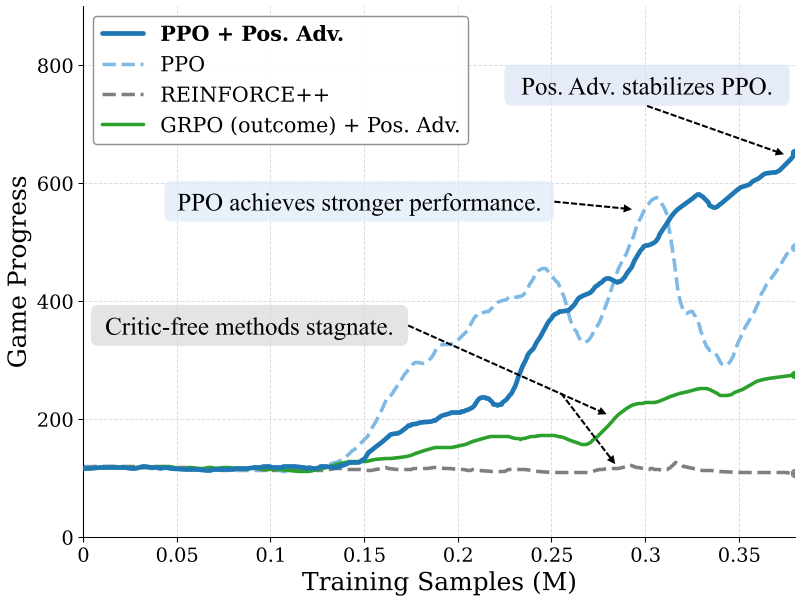
- 长程信用分配难题:在马里奥这类游戏中,一个“跳跃”按键的效果可能要在几十帧后才能体现。传统的 GRPO 或 Reinforce++ 等 Critic-free 方法在处理这种长程反馈时表现极其不稳定。
- 巨大的计算开销:如果效仿 RLHF 使用另一个 VLM 作为 Critic(批评者网络),显存和计算资源的需求将呈指数级增长。
核心方法论:轻量级 Critic 与 动作先验
Odysseus 的成功归功于三个关键的算法直觉:
1. 异构 Critic 设计 (Adapted PPO)
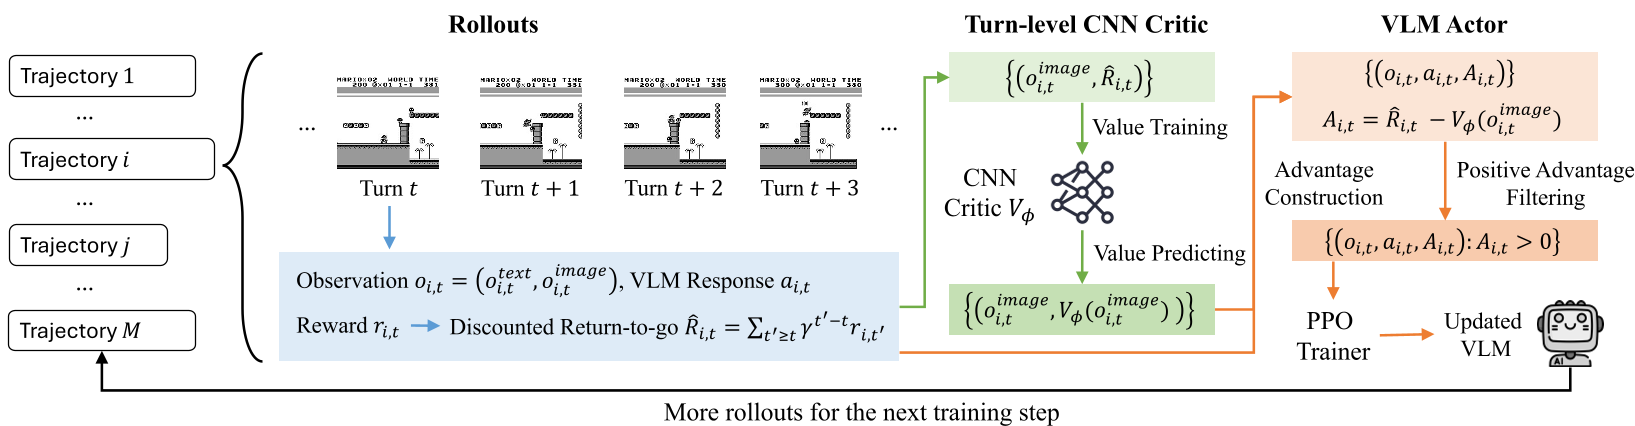
作者发现,Critic 不需要像 Actor 一样聪明。他们没有使用大模型,而是采用了一个极其轻量化的 CNN 批评者 专门负责进行轮次级(Turn-level)的价值评估。
- 物理直觉:视觉状态的价值判断(如“当前位置是否安全”)可以通过简单的空间特征提取完成,无需复杂的语义理解。这种设计减少了近 50% 的计算开销,同时显著提升了训练稳定性。
2. 正优势过滤 (Positive-advantage Filtering)
在训练过程中,Odysseus 会主动忽略那些表现不如预期的正样本(优势值为负的样本),只针对表现更好的动作进行梯度更新。这在长程序列优化中极大地降低了噪声干扰。
3. VLM 并非“空脑壳”
相比从零训练(Train from scratch)的传统深度强化学习(Deep RL),VLM 内部已经封装了大量关于物理世界的常识(如“悬崖不能踩”、“敌人要跳过”)。实验数据的对比令人震惊:VLM 驱动的 RL 样本效率比传统 CNN 策略快了 2 倍以上。
实验结果:马里奥之王的诞生
Odysseus 在多个维度上展现了压倒性的优势:
- 进度突破:在《超级马里奥大陆》前五关中,Odysseus 平均进度远超 GPT-4o 和 GLM-4V。
- 零样本泛化:即便只在第一关训练,模型也能在未见过的关卡甚至完全不同的游戏(如《超级马里奥兄弟》)中表现出色的避障和导航能力。
- 通用性保留:在经历了几千万波次的强化学习训练后,该模型在 MMMU 和 MathVision 等通用基准测试上的表现依然坚挺,没有发生严重的“灾难性遗忘”。
深度洞察
Odysseus 的意义在于它为 “如何让模型动起来” 提供了可落地的路径。它证明了:
- 解耦是关键:将复杂的 Token 生成(Actor)与简单的环境评估(Critic)解耦,是目前扩展 Agent 能力的最佳平衡点。
- 先验即效率:我们不需要通过 RL 让模型学习“什么是敌人”,而应该通过 RL 让模型学习“如何以正确的时间戳应对敌人”。
局限性与展望
尽管 Odysseus 表现出色,但在处理极端复杂的逻辑关卡(如需要特定顺序触发机关)时仍有提升空间。未来,将这种轻量级 RL 框架与更大规模的多模态模型(如 GPT-5 级别)结合,可能会诞生真正具备类人反应速度与策略深度的全能游戏智能体。
总结 (Takeaway):Odysseus 是一套高效的“训练配方”,它告诉我们:稳定的 Critic 设计 + 正向优势引导 + VLM 的动作先验 = 强大的交互式智能体。