
Omni-Fake:迈向全模态社交媒体深度伪造检测的新纪元
Omni-Fake: Benchmarking Unified Multimodal Social Media Deepfake Detection
本文推出了 Omni-Fake,首个针对社交媒体环境的统一四模态(图像、音频、视频、音视频说话人)深度伪造检测基准。同时提出了 Omni-Fake-R1,一个基于强化学习驱动的多模态检测器,在实现高精度检测的同时,支持伪造区域定位与自然语言解释。
TL;DR
随着生成式 AI(如 Sora, Kling)的爆发,社交媒体上的虚假内容已演变为复杂的多模态威胁。本文通过构建 Omni-Fake —— 一个包含百万级样本、覆盖四种模态(图、音、视、说话人)的全新基准,并推出强化学习驱动的 Omni-Fake-R1 探测器,实现了从单纯“判别真假”到“定位伪造并给出解释”的范式跃迁。
背景定位:为何现有的检测器在社交媒体面前集体失灵?
传统的检测方法往往在实验室的受控环境下表现良好,但一旦进入社交媒体的“荒野”,就会面临以下挑战:
- 分布偏移:新的生成模型(如 GPT-4o, FLUX)不断涌现,旧模型对此一无所知。
- 逻辑割裂:图像归图像,音频归音频,缺乏对音画不一致等复杂伪造的洞察。
- 信任鸿沟:只告诉用户“这是假的”,却不解释哪里假、为什么假,难以作为司法取证或内容审查的依据。
痛点深挖:为何需要 Omni-Fake?
作者指出,现有基准(如 FaceForensics++)大多侧重人脸替换,且模态单一。真实世界的深度伪造往往涉及局部编辑(Partial Manipulation)和复杂的后处理。为此,本文设计了 Omni-Fake-OOD 测试集,其生成算法与训练集完全不重叠,这成为了衡量检测器是否只是在“背模型偏置”还是在“理解伪造逻辑”的金标准。
方法论详解:Omni-Fake-R1 的核心机制
Omni-Fake-R1 基于 Qwen2.5-Omni-7B 构建,其训练过程包含两个关键环节:
1. 课程 SFT 与模态重放 (Modal Replay)
为了让一个模型同时学会处理四种模态而不产生“灾难性遗忘”,作者设计了一个学习序列:音频 → 图像 → 视频 → 音视频说话人。在学习新模态时,保留 15% 的旧模态数据进行重放,确保了跨模态知识的协同。
2. 统一 GSPO 强化学习
这是模型智能的核心。通过群组序列策略优化 (GSPO),模型不仅要预测标签,还要学习生成 <think> 链条。
- 格式奖励:确保模型按结构化输出。
- 检测奖励:对识别难度高的“局部篡改(Tampered)”给予更高权重。
- 定位奖励:通过 IoU(交并比)奖励模型精准框选伪造区域(空间)或时间段(时间)。
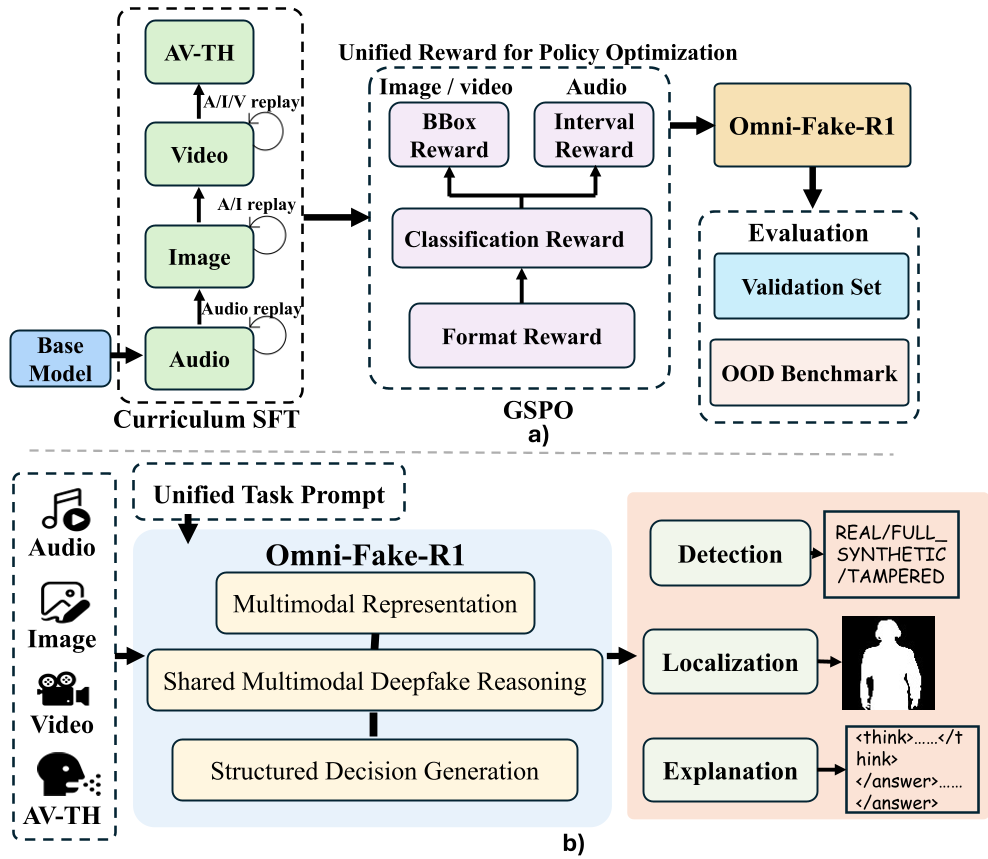 图 1:Omni-Fake-R1 的训练流程,结合了 SFT 与基于任务层面奖励的强化学习。
实验与结果:全维度的 SOTA
在 Omni-Fake-Set 上,Omni-Fake-R1 的表现碾压了传统的专业检测器。
- 性能提升:在音频伪造检测中,Acc 达到了 92.13%,远超 AASIST 等基线。
- 泛化能力:在 OOD 测试中,尽管所有模型的性能都有所下降,但 R1 模型依然能维持在 80% 以上的准确率,证明其学到了通用的伪造伪影。
- 鲁棒性验证:即使经过 JPEG 70 压缩或高斯模糊处,模型的检测性能依然稳健(F1 保持在 88% 以上)。
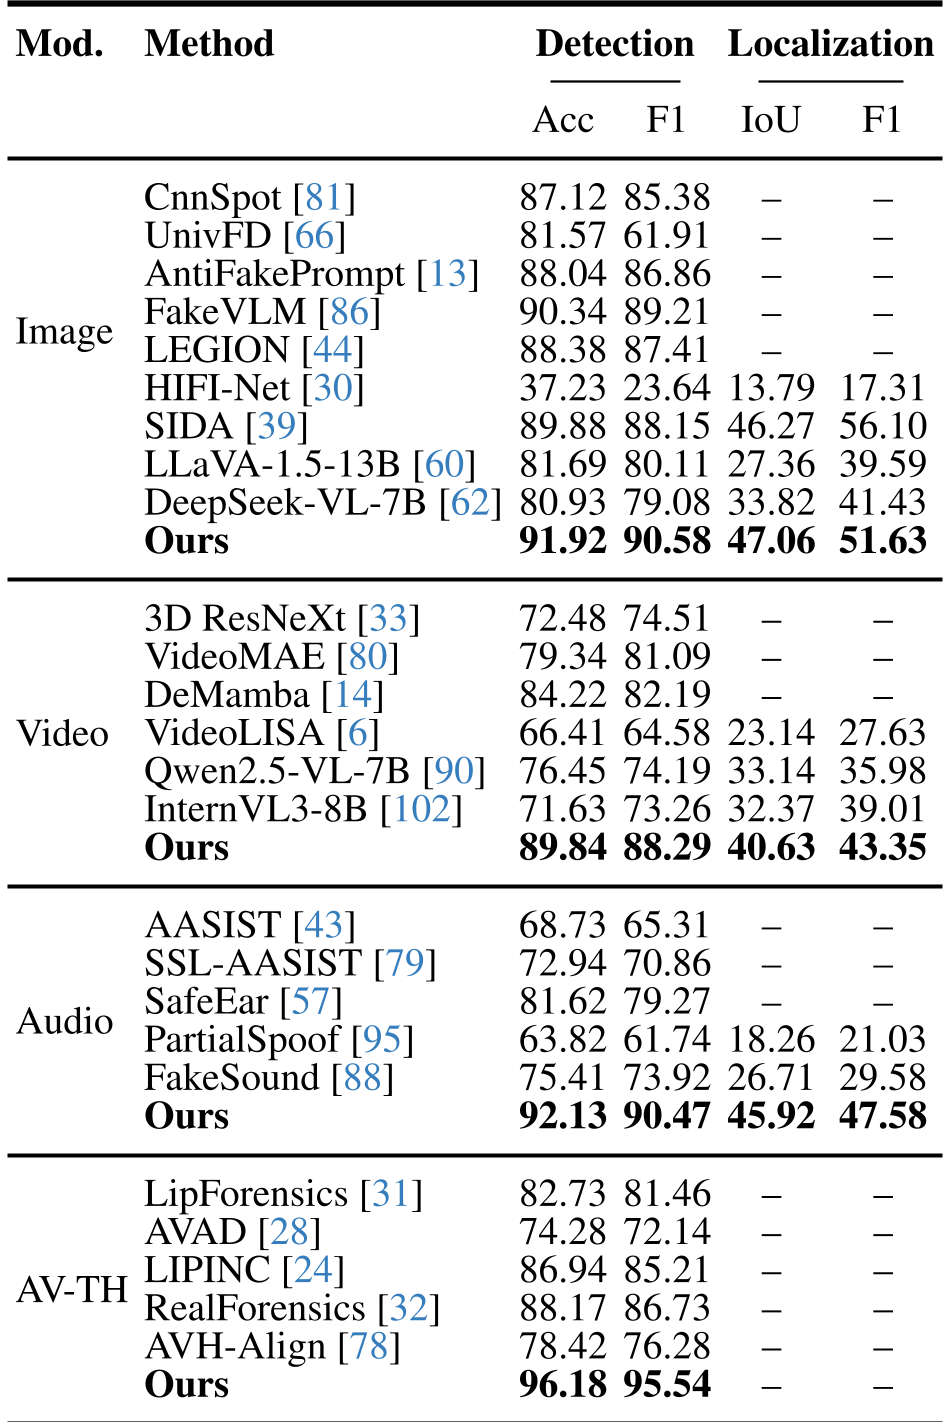 表 1:不同模态下的性能指标对比,R1 在检测与定位上双领先。
定性分析:它真的懂为什么是假的吗?
通过案例研究发现,Omni-Fake-R1 能够指出诸如“蝴蝶翅膀边缘有微弱光晕”、“嘴唇动作与发音不匹配”或“肤质过于平滑呈现塑料感”等细节。这种从“感知”到“认知”的进化,是传统二分类模型无法企及的。
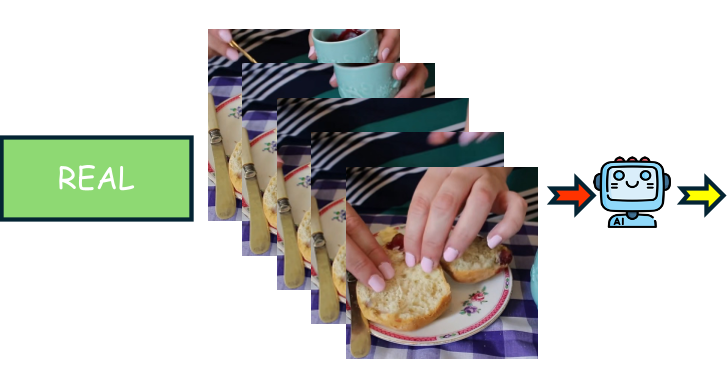 图 2:视频伪造案例研究,模型精准圈出了篡改的蝴蝶区域并给出了逻辑推导。
深度洞察与总结
Takeaway:深度伪造检测正在进入“大模型+强化学习”的新阶段。Omni-Fake 告诉我们,仅仅依赖视觉特征是不够的,未来的探测器必须具备跨模态的常识逻辑推理能力。
局限性:尽管 Omni-Fake 已经非常全面,但目前暂未涵盖 3D 虚拟人(Avatars)或多语言同步等最新变种,这也是未来研究的重要方向。
结论:Omni-Fake 不仅仅是一个数据集,它更是一套关于“数字真实性”的评估方法论。对于社交平台、内容审核机构和司法取证人员来说,其开源的 Omni-Fake-R1 模型具有极高的部署价值。